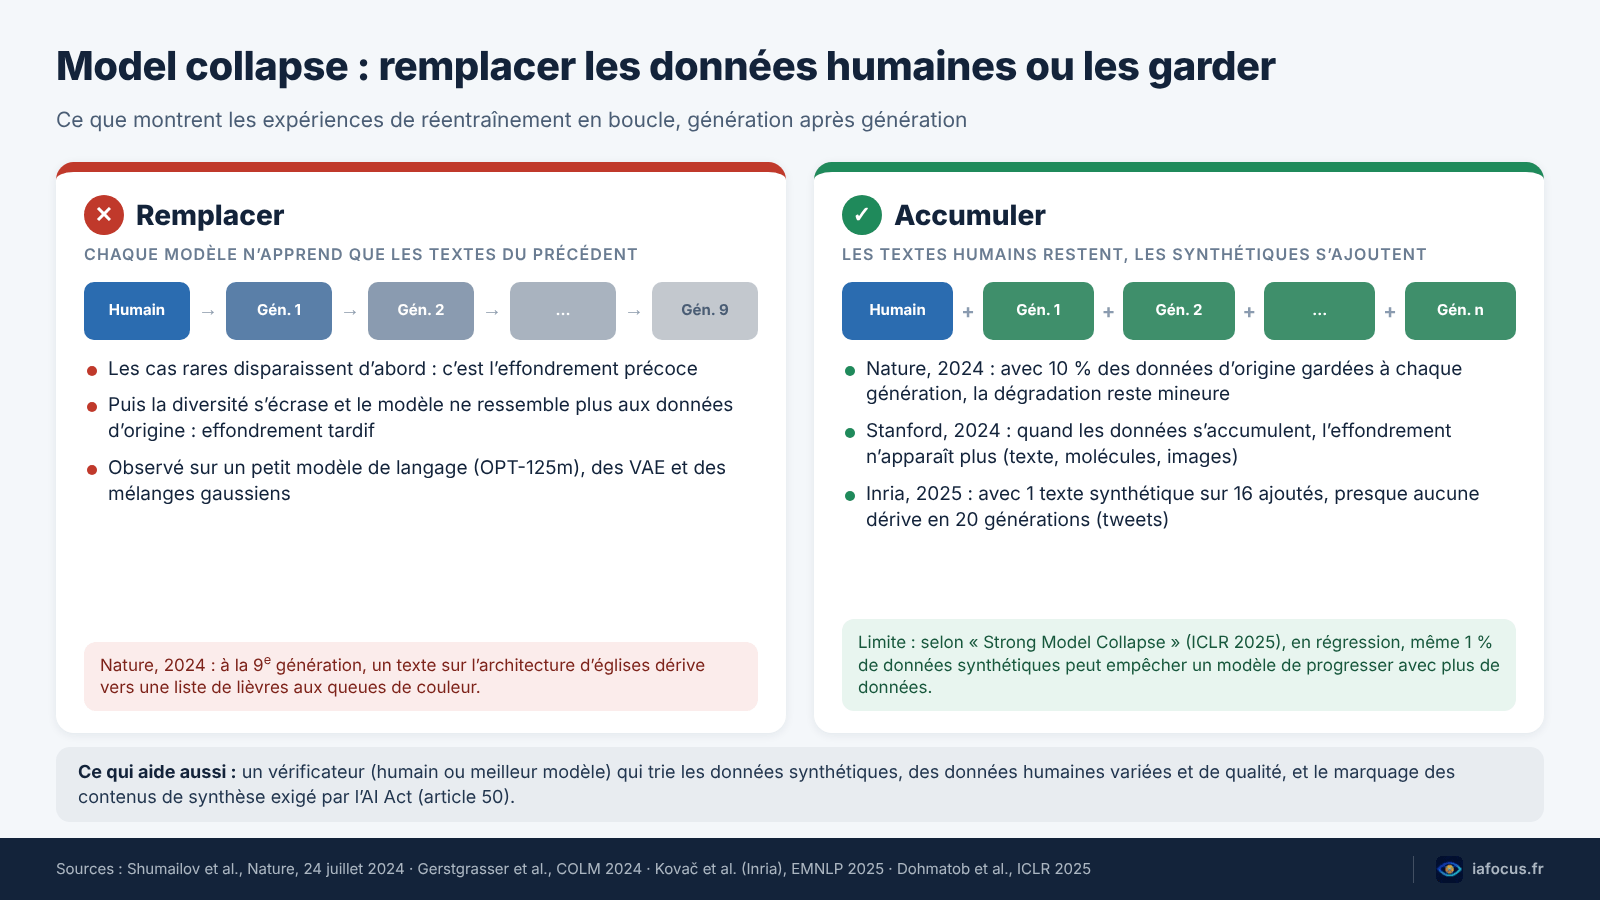
Le model collapse, c’est ce qui guette une IA nourrie de textes écrits par d’autres IA : génération après génération, elle oublie les cas rares, puis elle radote. Exemple célèbre : un petit modèle reçoit un passage sur l’architecture des églises anglaises ; neuf générations plus tard, il aligne des lièvres à queue noire, blanche, bleue, rouge, jaune.
L’expérience vient d’une étude parue dans Nature le 24 juillet 2024. Deux ans après, le contenu généré par IA s’étale partout, et les sites écrits par des humains reçoivent moins de visites. Faut-il craindre des IA qui s’abîment en se recopiant ? En laboratoire, le model collapse se produit bel et bien, sous conditions. Dans la réalité, rien ne le démontre, et la recherche récente montre surtout comment l’éviter.
Model collapse : ce que l’étude de Nature a vraiment testé
L’article, signé Ilia Shumailov, Yarin Gal et quatre coauteurs d’Oxford, de Cambridge, de l’Imperial College de Londres et de Toronto, est en accès libre sur le site de Nature. Le dispositif est modeste : OPT-125m, un modèle de Meta de 125 millions de paramètres, affiné sur wikitext2, un corpus tiré de Wikipédia. Chaque modèle produit un jeu de textes de même taille, sur lequel apprend le suivant.
Sans aucune donnée humaine réinjectée, les erreurs s’accumulent, les phrases se répètent, et surgissent des séquences que le modèle d’origine n’aurait jamais produites. Avec 10 % des données d’origine réintroduites à chaque génération, la dégradation reste mineure. Les auteurs distinguent l’effondrement « précoce », où disparaissent les événements peu probables, et l’effondrement « tardif », où le modèle converge vers une distribution appauvrie, sans grand rapport avec celle de départ. Ils l’observent aussi sur des autoencodeurs variationnels et des mélanges gaussiens.
Leur conclusion parle d’un avantage au premier arrivé : les données collectées avant l’adoption massive de ces outils, et celles qui viennent de vraies interactions humaines, vaudront de plus en plus cher. Yarin Gal a repris le sujet dans une conférence de l’école d’été MLSS 2026, mise en ligne par l’institut Max Planck pour les systèmes intelligents le 5 octobre 2026.
Pourquoi un modèle oublie d’abord les cas rares
Le mécanisme du model collapse n’a rien de mystérieux. L’étude cite trois sources d’erreur qui se cumulent. La principale est statistique : un modèle apprend sur un échantillon fini, et chaque rééchantillonnage peut perdre une information. Les deux autres tiennent aux limites du réseau et de son apprentissage.
Prenez une tournure régionale ou une opinion minoritaire, présente une fois sur mille. Le premier modèle risque de la reproduire un peu moins souvent, le suivant encore moins, et au bout de quelques tours elle peut avoir disparu. Plus rien ne la ramène. Les auteurs démontrent, dans un cas simple, que la chaîne finit dans un état absorbant dont elle ne sort plus.
Voir ce qui s’est perdu à l’intérieur d’un modèle reste difficile : on mesure la dégradation à la sortie. Lire directement dans les neurones relève d’un autre chantier, l’interprétabilité de l’IA, qui débat encore de la bonne méthode.
Effondrement des modèles : ce qui a nuancé l’alarme
Le point faible de l’expérience a vite été relevé. Dans son régime le plus spectaculaire, chaque génération jette les textes humains ; or le web ne fonctionne pas ainsi, les anciens textes restent en ligne. En 2024, une équipe de Stanford menée par Matthias Gerstgrasser et Rylan Schaeffer a comparé les deux scénarios (travaux présentés à COLM 2024). Remplacer les données mène bien à l’effondrement des modèles. Les accumuler, réelles et synthétiques côte à côte, l’évite, pour plusieurs tailles de modèles, et aussi pour des molécules et des images.
Quentin Bertrand et ses coauteurs de Mila l’avaient établi à leur manière à ICLR 2024 : la boucle reste stable si le premier modèle est assez bon et la part de données propres assez grande (prépublication). Contrepoint signé Meta et l’université de New York. Dans « Strong Model Collapse » (ICLR 2025), Elvis Dohmatob, Julia Kempe et leurs coauteurs montrent, dans un cadre de régression, que même 1 % de données synthétiques peut empêcher un modèle de progresser quand on lui donne plus de données (l’article).
Autre piste, le tri. Un vérificateur extérieur, humain ou modèle plus fort, empêche l’effondrement des modèles, mais les gains plafonnent au niveau de ce qu’il sait (Yi et al., ICLR 2026). Rylan Schaeffer et ses coauteurs recensent même huit définitions du model collapse, parfois contradictoires, et jugent plusieurs scénarios catastrophes éloignés du réel (prise de position, 2025). Les laboratoires, eux, utilisent les données synthétiques à dessein : Microsoft en a mis à toutes les étapes de l’entraînement de Phi-4, qui dépasse GPT-4, son « professeur », sur des questions scientifiques (rapport technique). Tout dépend de ce qu’on garde à côté, et de qui trie.
Inria : toutes les données humaines ne se valent pas
Côté français, l’équipe Flowers du centre Inria de l’université de Bordeaux a posé une question laissée de côté : et si tout dépendait des textes humains de départ ? Grgur Kovač, Pierre-Yves Oudeyer et leurs coauteurs ont présenté leur réponse à EMNLP 2025 (notice HAL). Leur boucle colle au web réel : les données s’accumulent, chaque génération mêle textes générés et nouveaux textes humains, et un petit modèle ouvert (Llama, Qwen, SmolLM ou Falcon) est tiré au sort à chaque tour.
Sur un corpus de tweets, quand un texte ajouté sur seize est synthétique, la dérive reste presque nulle en 20 générations ; elle grandit avec la proportion, puis plafonne à partir de la moitié. La diversité lexicale amplifie la dérive, quand la diversité sémantique et la qualité la freinent. Les effets restent cantonnés à leur domaine (Twitter, Reddit, Wikipédia). Et selon l’orientation politique des données humaines, le biais initial est amplifié, réduit ou inversé. Pas un model collapse global, donc. Plutôt une mosaïque de dérives locales.
L’effondrement des modèles a désormais son projet financé en France. Depuis février 2026, l’Agence nationale de la recherche soutient pour 36 mois le projet LSD, coordonné par Quentin Bertrand (Inria) avec Mila, à hauteur de 335 960 euros (fiche ANR). Objectif : mesurer la « vitesse d’effondrement » des modèles qui se réentraînent sur leurs propres sorties, et trouver comment l’éviter.
Contenu généré par IA : quelle part du web ?
Le scénario de Nature suppose un web saturé de textes de machines. Des chercheurs de Princeton estiment qu’entre 4 et 5 % des 2 909 articles de la Wikipédia anglophone créés en août 2024 contiennent une part importante de contenu généré par IA ; la proportion est plus faible en français (l’étude). À Stanford, une autre équipe évalue la part rédigée avec un modèle de langage, fin 2024, à environ 18 % du texte des réclamations de consommateurs dans la finance aux États-Unis, et jusqu’à 24 % de celui des communiqués d’entreprise (prépublication).
Ajoutez les sites qui misent sur la rédaction SEO assistée par IA, et la part des textes de machine risque de grimper. Le stock de textes humains, lui, s’épuise : Epoch AI (ICML 2024) prévoit que les modèles seront entraînés sur l’équivalent de tout le texte humain public entre 2026 et 2032, avec 2028 comme année médiane, si les tendances se maintiennent (arXiv). Parmi les pistes citées pour la suite : les données synthétiques. Une voie prévue, pas un accident.
Moins de clics, moins de textes humains ?
Beaucoup de sites qui publient des textes humains vivent de l’audience envoyée par les moteurs, et les résumés affichés en tête des résultats retiennent l’internaute. Le Pew Research Center a suivi 900 adultes américains sur 68 879 recherches Google en mars 2025 : avec un résumé IA, ils cliquent sur un lien classique lors de 8 % des visites, contre 15 % sans (Pew Research Center). Google a annoncé le 15 octobre 2026 plus de liens dans ses Aperçus IA, sans donner aux sites de chiffres de clics, comme nous l’expliquions à propos du trafic ChatGPT.
Autre réflexe des sites : fermer la porte aux robots. D’après un audit de 14 000 domaines par la Data Provenance Initiative, les fichiers robots.txt ont placé sous restriction, en un an (2023-2024), environ 5 % des données du corpus C4 et plus de 28 % de ses sources les plus actives (l’audit). En France, l’AFP et Radio France ont rejoint la coalition SPUR pour savoir ce que les assistants puisent chez elles.
Le 9 décembre 2025, la Commission européenne a ouvert une enquête contre Google : les AI Overviews et l’AI Mode utilisent-ils le contenu des éditeurs sans compensation appropriée, ni moyen de refuser sans perdre l’accès à Google Search (communiqué) ? Le lien avec le model collapse paraît simple : moins de visites, moins de revenus pour écrire, plus de contenus verrouillés, donc une part de contenu généré par IA qui grossit dans ce qui reste. Plausible. Mais aucune étude, à notre connaissance, n’a mesuré cette chaîne de bout en bout.
Model collapse : ce qui est avéré, ce qui reste spéculatif
Ce qui est établi : en laboratoire, des modèles entraînés en boucle sur les productions de leurs prédécesseurs se dégradent, en perdant d’abord les cas rares. Garder ou accumuler des données humaines limite fortement le phénomène, d’après plusieurs équipes indépendantes. Et la part de contenu généré par IA augmente dans des sources très lues.
Ce qui reste spéculatif : que ChatGPT, Gemini ou Claude se soient déjà dégradés pour cette raison. Nous n’avons trouvé aucune publication qui l’établisse. Une analyse présentée à ICML 2026, cosignée par Michal Valko (Inria et Meta), note que les développeurs répondent au risque par le nettoyage des données, le filigrane, des règles sur les données synthétiques, « ou, parfois, une ignorance béate ». Et la plupart des expériences portent sur de petits modèles et des corpus étroits.
Le risque réaliste est plus discret. Pas une IA qui s’effondre, mais une IA qui s’appauvrit : moins de tournures rares, moins de voix minoritaires, des biais amplifiés par le tri (des chercheurs de Mila l’ont montré pour des images sélectionnées selon un critère de préférence). Les auteurs de Nature le rappellent, les événements peu probables comptent pour l’équité des prédictions. Et cette perte-là ne se verra pas dans un score moyen.
AI Act : marquer le contenu généré par IA pour le retrouver
La parade réclamée par les auteurs de Nature tient en un mot : la provenance, savoir ce qui sort d’un modèle. Depuis le 2 août 2026, l’article 50 du règlement européen sur l’IA oblige les fournisseurs de systèmes qui génèrent du son, des images, de la vidéo ou du texte à marquer leurs sorties dans un format lisible par machine. Ceux déjà sur le marché ont jusqu’au 2 décembre 2026 (article 111), et la Commission a publié le 10 juin 2026 un code de bonnes pratiques facultatif.
Le même article vise aussi ceux qui publient : un texte généré par IA, publié pour informer le public sur des questions d’intérêt public, doit être signalé, sauf examen humain ou contrôle éditorial, avec une personne qui en assume la responsabilité éditoriale. Nous avions détaillé ces règles à propos de la publicité générée par IA.
Le marquage a ses limites. SynthID-Text, le filigrane de Google DeepMind déployé dans Gemini (Nature, 23 octobre 2024), suppose que les fournisseurs se coordonnent, s’affaiblit quand un autre modèle reformule le texte, et s’impose mal aux modèles ouverts déployés de façon décentralisée. Ce sont pourtant eux qui permettent à des laboratoires publics, comme l’équipe d’Inria, de rejouer vingt générations d’entraînement. Une fois les poids téléchargés, personne ne garantit que leurs textes porteront une marque. Le filigrane ne réglera donc pas seul l’effondrement des modèles.
Et vous, concrètement ? Si vous affinez un modèle sur vos créations, par exemple pour entraîner un LoRA, gardez vos originaux dans le jeu de données plutôt que de le regonfler d’images générées. Archivez vos textes d’origine, datés. Et réglez votre robots.txt en connaissance de cause : il indique aux robots d’entraînement ce qu’ils peuvent collecter chez vous.
Foire aux questions
Qu’est-ce que le model collapse, en une phrase ?
C’est la dégradation d’un modèle génératif entraîné en boucle sur des données produites par d’autres modèles : il perd d’abord les cas rares, puis sa diversité. L’expression a été popularisée par une étude parue dans Nature en juillet 2024.
ChatGPT ou Gemini sont-ils déjà touchés ?
Rien ne le démontre. Nous n’avons trouvé aucune publication qui attribue au model collapse une baisse de qualité d’un grand assistant. Les expériences portent surtout sur de petits modèles, et les développeurs filtrent leurs données. Le risque est plutôt à long terme, si les textes humains récents se raréfient.
Les données synthétiques sont-elles à bannir ?
Non. Ajoutées à des données humaines conservées, ou triées par un vérificateur fiable, elles n’ont pas provoqué d’effondrement des modèles dans la plupart des expériences publiées. Microsoft en a fait un ingrédient central de Phi-4. Le danger vient du remplacement des données réelles.
Que change l’AI Act pour le contenu généré par IA ?
Depuis le 2 août 2026, les fournisseurs d’outils génératifs doivent marquer leurs sorties dans un format lisible par machine (article 50). Un texte généré qui informe le public sur des questions d’intérêt public doit être signalé, sauf contrôle éditorial assumé.
Sources
- PubMed (National Library of Medicine) : Shumailov et al., Nature, 2024 et Dathathri et al. (SynthID-Text), Nature, 2024
- HAL, archive ouverte : Kovač et al. (Inria), EMNLP 2025, Racca, Valko et Sanyal, ICML 2026 et Ferbach, Bertrand et al., NeurIPS 2024
- Agence nationale de la recherche : projet ANR-25-CE23-6481 sur les données synthétiques
- Commission européenne : communiqué IP/25/2964 du 9 décembre 2025 et code de bonnes pratiques du 10 juin 2026
- EUR-Lex : règlement (UE) 2024/1689, version consolidée du 27 juillet 2026
- AI Act Service Desk (Commission européenne) : article 50 et article 111