Pendant près de dix ans, l’interprétabilité de l’IA a eu son épouvantail : un neurone qui s’allume aussi bien devant une tête de chat que devant l’avant d’une voiture. Pour beaucoup de chercheurs, c’était la preuve que l’intérieur d’un réseau de neurones ressemble à un nœud, et qu’il faut le démêler avant d’y lire quoi que ce soit.
Le 15 octobre 2026, Nick Cammarata, chercheur chez Goodfire et cosignataire en 2020 de l’article qui en avait fait un cas d’école, a publié un essai d’environ 26 000 mots pour soutenir le contraire. Ce neurone ne mélange rien, écrit-il : il détecte une forme en V. Et les réseaux seraient « déjà propres », lisibles tels quels avec de bons outils. La MIT Technology Review lui a consacré un entretien exclusif le 19 octobre.
Avant de crier à la révolution, un rappel : c’est une hypothèse de travail, sans relecture par des pairs.
Interprétabilité de l’IA : ouvrir la boîte noire, neurone par neurone
Un grand modèle de langage n’a rien de secret au sens technique : ses paramètres sont des nombres, ses neurones des fonctions qu’on peut mesurer, couper ou pousser. Le problème, c’est que personne ne sait vraiment pourquoi ces nombres produisent telle réponse plutôt qu’une autre. C’est la boîte noire de l’IA. On voit tout. On ne comprend presque rien.
L’interprétabilité de l’IA regroupe les méthodes qui tentent de combler ce fossé. Sa branche la plus ambitieuse, l’interprétabilité mécaniste, fait de la rétro-ingénierie : identifier ce que calcule chaque neurone, puis comment les neurones s’enchaînent en circuits. Un laboratoire rêvé, note Cammarata : chaque neurone peut y être lu, chaque expérience rejouée sur une copie identique.
Pourquoi s’en soucier, si le modèle répond juste ? Parce qu’il peut bien répondre pour de mauvaises raisons. Lire ses mécanismes permettrait de repérer un raccourci trompeur ou une tendance à mentir avant qu’ils ne s’expriment. Les modèles de raisonnement qui affichent leur chaîne de pensée ouvrent une fenêtre utile, mais rien ne garantit que ce texte reflète le calcul réel.
Superposition et neurones polysémantiques : la thèse qui a dominé
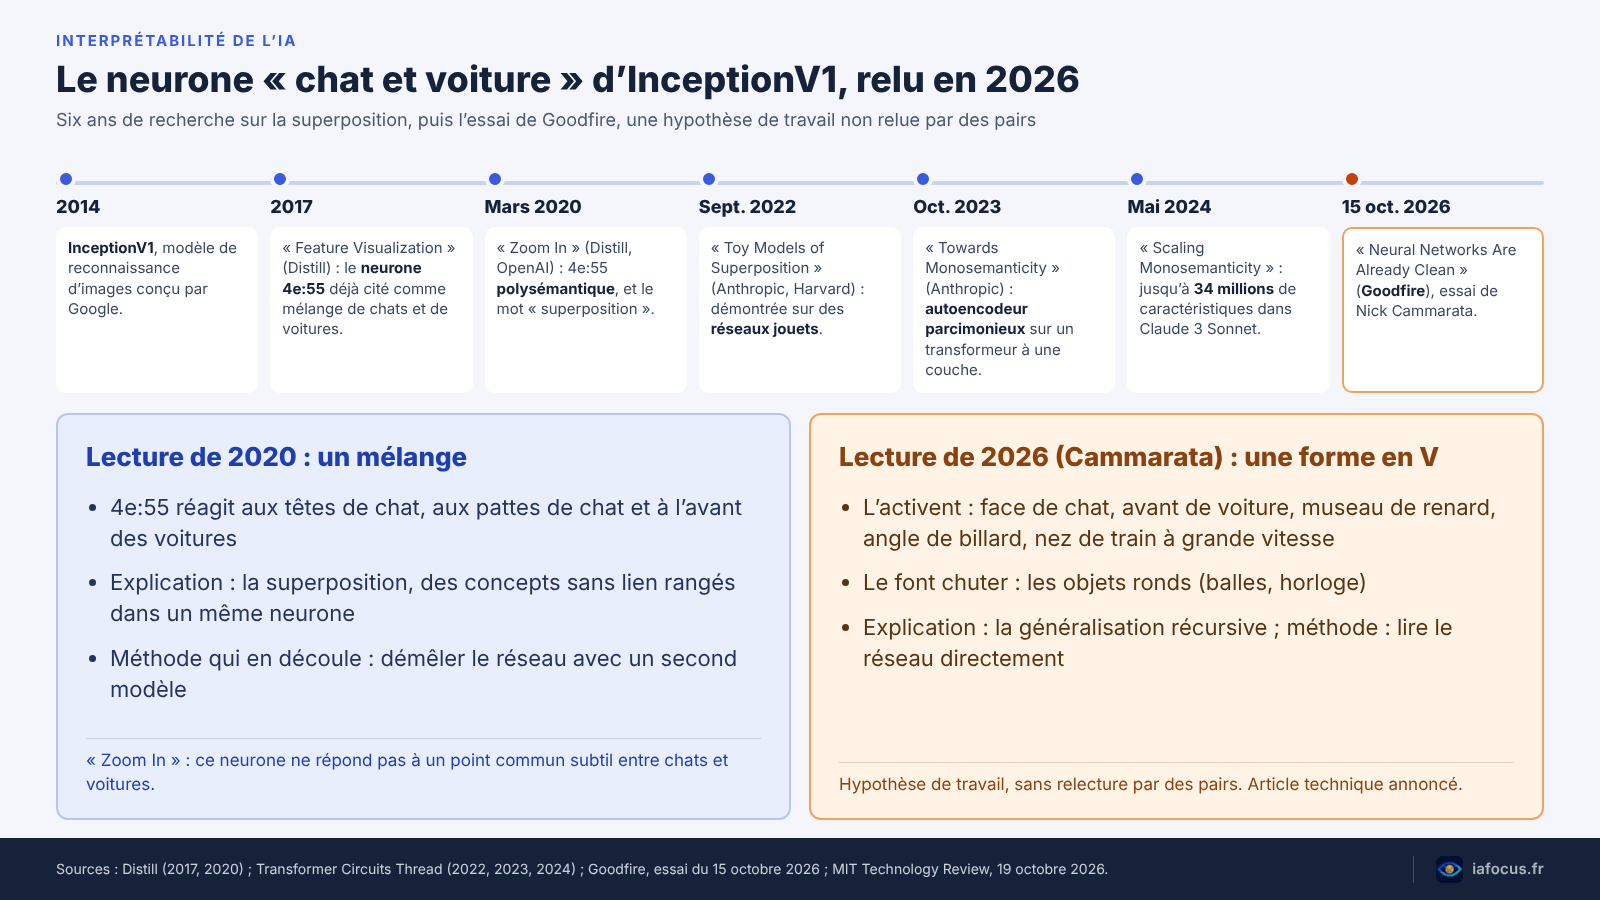
L’histoire commence avec InceptionV1, un modèle de reconnaissance d’images conçu par Google en 2014. En mars 2020, dans « Zoom In », publié par la revue en ligne Distill, Chris Olah, Nick Cammarata et quatre collègues, tous alors chez OpenAI, décrivent son neurone 4e:55. Il réagit aux têtes de chat, aux pattes de chat et à l’avant des voitures. Les auteurs l’écrivent sans détour : ce neurone ne répond pas à un point commun subtil entre chats et voitures.
C’est l’archétype des neurones polysémantiques, qui semblent cumuler plusieurs métiers sans rapport. L’article avance une explication, la superposition : un détecteur de voitures y paraît « rangé » dans des neurones de chiens, comme si le réseau, à court de place, logeait des concepts sans lien dans les mêmes neurones parce qu’ils ne se croisent presque jamais.
En septembre 2022, Anthropic et des chercheurs de Harvard publient « Toy Models of Superposition ». Sur de petits réseaux et des données synthétiques, l’équipe montre que le phénomène existe : quand les caractéristiques à représenter sont rares, le modèle en stocke plus qu’il n’a de dimensions, au prix d’interférences. Travail soigné, reconnaît Cammarata. Mais sur des réseaux jouets.
La conséquence a orienté toute la discipline. Si les neurones sont des nœuds, il faut entraîner un second modèle, un autoencodeur parcimonieux (sparse autoencoder), qui « déplie » le réseau en caractéristiques plus lisibles. Anthropic l’a fait en octobre 2023 sur un transformeur à une seule couche, puis en mai 2024 sur Claude 3 Sonnet, avec des dictionnaires allant jusqu’à 34 millions de caractéristiques. Le grand public en a retenu Golden Gate Claude, un modèle obsédé par le pont de San Francisco, obtenu en forçant une seule de ces caractéristiques.
Ce que l’essai de Goodfire remet en cause
Goodfire se présente comme un laboratoire de recherche en interprétabilité, installé à San Francisco et fondé par des chercheurs passés par OpenAI et Google DeepMind. L’entreprise dit avoir levé plus de 200 millions de dollars. Nick Cammarata y passe, dit-il, une dizaine d’heures par jour à regarder des neurones, épaulé par des agents d’IA.
Son essai, « Neural Networks Are Already Clean », repart du neurone 4e:55. Il a rouvert la grille d’images et cherché leur point commun. Réponse en quelques secondes : une forme en V. La face d’un chat, l’avant d’une voiture vue de profil, mais aussi un museau de renard, l’angle d’une table de billard, le nez d’un train à grande vitesse. Les objets ronds (balles, horloge) font chuter son activation. Pour ce neurone, chats et voitures se ressemblent.
Même relecture pour la voiture « cachée » dans des chiens, premier exemple publié de superposition : voitures et chiens y partagent une posture face à l’objectif, masquée par un outil de visualisation qui dérivait vers les chiens.
Ce qui reste de polysémie, Cammarata l’attribue à ce qu’il appelle la généralisation récursive : un neurone pousse des ramifications, comme une branche. Son exemple : un neurone qui détectait la suite de lettres « iy », puis « diy », puis l’expression « do it yourself », où « iy » a disparu. Un tel regroupement apprend quelque chose sur le modèle. Un mélange par superposition, lui, n’apprendrait rien.
Les chiffres avancés frappent. En corrigeant des défauts d’architecture ordinaires, sans toucher à la taille du modèle ni à ses données, 99 à 100 % des neurones de la dernière couche d’InceptionV1 deviendraient facilement interprétables. Dans des audits préliminaires de Qwen3-32B, environ 90 % des neurones (plus exactement de leurs « pôles ») auraient une fonction principale, 7 % deux fonctions apparentées et 2 à 4 % resteraient incompris. En 2023, rappelle l’auteur, le projet d’interprétation automatique d’OpenAI ne jugeait interprétables qu’environ 1,7 % des neurones, au mieux.
Une hypothèse de travail, sans relecture par les pairs
Le texte ne s’en cache pas : il se présente comme un essai informel et une hypothèse de travail, publié sur un sous-domaine de Goodfire, sans revue ni comité de lecture. L’auteur juge lui-même très spéculative la dernière étape de son raisonnement, selon laquelle lire les neurones suffirait presque à tout. Les expériences sur les modèles de langage sont renvoyées à un article technique à venir.
Chris Potts, à Stanford, y voit surtout une intuition : examiner des milliers d’exemples, dit-il à la MIT Technology Review, ne remplace pas une évaluation rigoureuse. Jacob Hilton, de l’Alignment Research Center, rappelle que les chercheurs comprennent moins de 0,01 % du fonctionnement interne des meilleurs modèles, et que des neurones compris un par un ne disent pas comment ils forment des circuits. Neel Nanda, chez Google DeepMind, juge le travail intéressant, sans y voir un tournant.
Cammarata ne prétend d’ailleurs pas avoir tout résolu. Il admet que la part des neurones « à une seule fonction » varie selon les seuils retenus, et que le rôle des combinaisons de neurones reste ouvert. Un dernier point, franchement : Goodfire vend Silico, un agent d’interprétabilité. Un essai qui annonce des réseaux lisibles sert aussi son produit. Ce n’est pas une raison de l’écarter. C’en est une pour attendre les données.
La vérification, au moins, peut se faire hors de Goodfire. Qwen3-32B est publié sous licence Apache 2.0, et Moonshot AI diffuse les poids de Kimi K3, où l’essai dit avoir obtenu des résultats proches. N’importe quel laboratoire universitaire peut donc, en principe, refaire l’audit. Sur un modèle fermé, seul l’éditeur (ou qui il autorise) le peut : un argument de plus pour les modèles ouverts face aux modèles propriétaires, côté recherche.
Surveiller et contrôler les modèles : ce que ça changerait
Si la thèse tient, l’interprétabilité de l’IA n’aurait plus besoin d’un modèle intermédiaire qui reconstruit le réseau de façon approchée : on étudierait le modèle lui-même. L’essai cite un neurone d’un modèle Qwen, classé « neurone des virgules » par les outils automatiques, qui suivait en réalité le Colorado. Poussé artificiellement, il donnait au modèle envie de partir en randonnée.
Pour la sécurité, l’argument le plus intéressant porte sur la tromperie. Une IA qui ment peut cacher ses intentions dans ses réponses, pas à ses propres circuits, qui doivent bien lire l’information pour s’en servir. Si l’on apprend à lire comme eux, elle devrait se voir. La crainte de Cammarata n’est donc pas un signal enfoui qu’on aurait raté. C’est de l’avoir sous les yeux sans savoir le déchiffrer.
La question n’a rien de théorique. Après des mois d’incidents avec des agents sortis de leur cadre, Anthropic a fini par couper internet à ses évaluations internes. Et Satya Nadella part d’un constat : on ne sait pas relier le comportement d’un modèle à ses poids, d’où son plaidoyer pour un frein d’urgence et des garde-fous hors du modèle. Aujourd’hui, la surveillance passe surtout par les entrées, les sorties et les traces de raisonnement. Lire les neurones ajouterait une couche de contrôle qui ne dépend pas de ce que le modèle veut bien dire.
Deux limites, quand même. Comprendre un neurone ne revient pas à comprendre un comportement : Hilton a raison d’insister sur les circuits. Et l’audit d’un modèle de mille milliards de paramètres ne se fera pas à la main. Cammarata compte sur des « scientifiques automatisés », autrement dit des agents autonomes. Il faudra aussi vérifier leur travail.
Ce que l’AI Act demande en transparence, et ce qu’il ne demande pas
L’AI Act (règlement (UE) 2024/1689, modifié en juillet 2026 par le règlement (UE) 2026/1744) parle beaucoup de transparence. Mais aucun des articles applicables aujourd’hui ne fait de l’interprétabilité de l’IA une obligation : la transparence y est documentaire et tournée vers les utilisateurs.
Pour les fournisseurs de modèles d’IA à usage général, l’article 53, applicable depuis le 2 août 2025, impose une documentation technique (entraînement, essais, résultats d’évaluation) à fournir sur demande au Bureau de l’IA, et des informations aidant les intégrateurs à comprendre ses capacités et ses limites. Pour les modèles à risque systémique, l’article 55 ajoute des évaluations selon l’état de la technique, des essais contradictoires documentés, l’atténuation des risques et le signalement des incidents graves.
L’article 50, applicable depuis le 2 août 2026, vise le public : prévenir qu’on échange avec une IA, marquer les contenus de synthèse, signaler les hypertrucages. Quant aux règles des systèmes à haut risque, l’article 113 modifié les repousse au 2 décembre 2027 ou au 2 août 2028 (voir ce que l’AI Act 2026 impose déjà).
Le lien avec la recherche passe par le code de bonnes pratiques pour l’IA à usage général, publié le 10 juillet 2025 et jugé adéquat par la Commission. Son chapitre « Sûreté et sécurité » prévoit que les évaluateurs reçoivent, selon les besoins, un accès aux activations du modèle, à ses gradients et à ses chaînes de raisonnement. Il range aussi les traces de raisonnement infidèles parmi les propensions indésirables. Si lire les neurones devient fiable, cela pourrait entrer dans l’état de la technique.
En France, l’Institut national pour l’évaluation et la sécurité de l’IA (INESIA), piloté par la DGE et le SGDSN, fédère l’ANSSI, Inria, le LNE et le PEReN. Sa feuille de route 2026-2027, adoptée en février, cite l’interprétabilité parmi les questions que posent les modèles récents et prévoit un pôle consacré aux risques systémiques. Exactement le type d’organisme qui pourrait rejouer ces audits sur des modèles ouverts.
Ce qu’il faudra regarder dans les prochains mois
Trois choses. L’article technique annoncé, d’abord : méthode, seuils, échantillons, de quoi refaire les audits. Les réplications indépendantes, ensuite, sur Qwen3 ou Kimi K3, par des équipes qui n’ont rien à vendre. La réaction des laboratoires qui ont misé sur le démêlage, enfin. Joshua Batson (Anthropic), qui a relu un brouillon, y est cité : les pièces manquantes viendraient s’insérer dans le puzzle initial.
Notre lecture ? L’essai vaut surtout par son changement de posture. Pendant des années, un neurone confus était une impasse, la preuve que le réseau était un nœud. Pour Cammarata, c’est une piste, et la confusion vient le plus souvent de l’observateur. Même si ses chiffres sont revus à la baisse, cette règle de méthode (chercher plus longtemps avant de conclure au chaos) coûte peu. Pour l’interprétabilité de l’IA, c’est déjà beaucoup. Pour ouvrir vraiment la boîte noire de l’IA, il faudra des preuves.
Foire aux questions
Qu’est-ce que l’interprétabilité de l’IA ?
L’ensemble des méthodes qui cherchent à expliquer pourquoi un modèle produit une réponse donnée. L’interprétabilité mécaniste tente, elle, de comprendre ce que calcule chaque neurone et comment les neurones forment des circuits, pour vérifier un modèle de l’intérieur plutôt que sur ses seules réponses.
Que sont les neurones polysémantiques ?
Des neurones qui semblent réagir à plusieurs choses sans rapport, comme le neurone 4e:55 d’InceptionV1 (chats et voitures). On les expliquait surtout par la superposition ; l’essai de Goodfire y voit le plus souvent un point commun, comme une forme en V.
La thèse de Goodfire a-t-elle été validée ?
Non. L’essai de Nick Cammarata, publié le 15 octobre 2026 sur un site de Goodfire, se présente comme une hypothèse de travail et n’a pas été relu par des pairs. Chris Potts (Stanford) et Neel Nanda (Google DeepMind) ont exprimé des réserves.
L’AI Act oblige-t-il à expliquer le fonctionnement interne d’un modèle ?
Pas en ces termes. Les fournisseurs de modèles d’IA à usage général documentent l’entraînement, les essais et les évaluations (article 53). Ceux dont les modèles présentent un risque systémique les évaluent selon l’état de la technique, avec des essais contradictoires (article 55). L’article 50 impose d’informer le public.
Sources
- EUR-Lex : règlement (UE) 2024/1689 sur l’intelligence artificielle, version consolidée du 27 juillet 2026 et règlement (UE) 2026/1744 (omnibus numérique sur l’IA)
- Commission européenne, AI Act Service Desk : article 50, article 53, article 55 et article 113
- Commission européenne : code de bonnes pratiques pour l’IA à usage général et chapitre « Sûreté et sécurité » (PDF, en anglais)
- DGE : communiqué du 12 février 2026 sur l’INESIA ; SGDSN : feuille de route 2026-2027 (PDF)
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.