Un même prompt peut produire un excellent livrable dans une interface grand public, puis devenir inutilisable dès qu’il faut traiter des données clients, automatiser un flux ou garantir un résultat stable à grande échelle. C’est là que le débat sur les modèles ouverts versus propriétaires cesse d’être théorique. Pour une équipe marketing, un développeur ou un studio créatif, le bon choix conditionne les coûts, la confidentialité, la vitesse de mise en production et la dépendance à un fournisseur.
Le raccourci « ouvert = libre » et « propriétaire = meilleur » ne tient pas. Les modèles de langage, de génération d’images ou de synthèse vocale se distinguent par leurs licences, leurs poids disponibles, leur mode d’hébergement, leur qualité sur un cas d’usage donné et les garanties proposées. Il faut donc comparer une architecture de travail, pas seulement un classement de benchmarks.
Modèles ouverts versus propriétaires : la différence réelle
Un modèle propriétaire est contrôlé par l’organisation qui l’entraîne et le distribue. On y accède généralement via une interface web, une API ou une offre entreprise. Les poids du modèle ne sont pas publiés, les améliorations sont gérées par le fournisseur et l’infrastructure reste sous son contrôle. Cette catégorie inclut des assistants conversationnels, des modèles multimodaux et de nombreux générateurs d’images ou de vidéo accessibles sur abonnement.
Un modèle ouvert met à disposition tout ou partie des éléments nécessaires à son utilisation et à son adaptation. Dans la pratique, il faut distinguer un modèle aux poids téléchargeables, un modèle sous licence permissive et un projet réellement open source. La publication des poids ne donne pas automatiquement le droit de les redistribuer, de les réentraîner sans limite ou de les exploiter dans un produit commercial. Lire la licence reste indispensable, surtout pour une agence ou une startup.
Cette nuance change tout. Un modèle ouvert peut être installé sur un serveur interne, exécuté dans un cloud européen ou affiné sur un corpus métier. En contrepartie, l’équipe assume davantage de responsabilités : déploiement, monitoring, sécurité, mise à jour, gestion des GPU et évaluation des sorties. Avec un modèle propriétaire, une grande partie de cette complexité est externalisée, mais la feuille de route et les conditions tarifaires ne vous appartiennent pas.
Modèles ouverts en 2026 : les licences à lire avant de télécharger
Le terme « ouvert » recouvre des réalités très différentes. En 2026, les principales familles de modèles ouverts se répartissent entre licences vraiment libres, licences permissives et licences maison assorties de conditions. Le tableau ci-dessous résume la situation au moment de la rédaction ; la licence peut changer d’une version à l’autre, vérifiez toujours celle du fichier téléchargé.
| Famille | Éditeur | Licence | Usage commercial |
|---|---|---|---|
| gpt-oss 120B et 20B | OpenAI | Apache 2.0 (août 2025) | Oui, sans condition |
| Qwen 3 | Alibaba | Apache 2.0 | Oui, sans condition |
| Gemma 4 | Apache 2.0 depuis avril 2026 (Gemma 3 restait sous conditions Google) | Oui | |
| DeepSeek V3 à V4 | DeepSeek | MIT | Oui, sans condition |
| Mistral 3 (Large 3, Ministral 3) | Mistral AI | Apache 2.0 | Oui ; Magistral Medium reste en API |
| Llama 4 | Meta | Licence communautaire Meta | Oui sous conditions : plafond de 700 millions d’utilisateurs, restrictions en Union européenne sur le multimodal |
Ces modèles ouverts sont des grands modèles de langage dont les poids se téléchargent, mais deux d’entre eux seulement, sous MIT ou Apache 2.0, répondent à la définition du logiciel libre. Une licence communautaire comme celle de Meta autorise l’usage commercial tout en fixant des plafonds et des exclusions géographiques : une agence qui construit un produit doit la lire en entier.
Ce que l’AI Act change pour les modèles ouverts
Depuis le 2 août 2025, l’AI Act impose aux fournisseurs de modèles à usage général une documentation technique et une politique de respect du droit d’auteur. Les modèles publiés sous licence libre avec leurs poids et leur architecture sont dispensés d’une partie de ces obligations, sauf s’ils présentent un risque systémique. Pour l’entreprise qui déploie un modèle ouvert, la responsabilité ne disparaît pas pour autant : la réglementation européenne de l’intelligence artificielle s’applique à l’usage, pas seulement à l’éditeur.
Pourquoi les modèles propriétaires restent attractifs
Pour des usages où la qualité immédiate prime, les modèles propriétaires ont un avantage fréquent. Elles proposent souvent une expérience prête à l’emploi : interface soignée, modèles multimodaux, fonctions de recherche, traitement de documents, génération de code, outils collaboratifs et API documentées. C’est le terrain où OpenAI, Google et Mistral se disputent la course. Un rédacteur peut passer d’un brief à une structure d’article, un analyste interroger un tableau de données, un développeur tester une intégration en quelques heures.
L’autre bénéfice est opérationnel. Le fournisseur absorbe l’entraînement, l’inférence, l’élasticité de l’infrastructure et une partie des mécanismes de filtrage. Une PME n’a pas besoin de recruter immédiatement un ingénieur MLOps pour lancer un assistant interne limité ou une fonctionnalité de résumé dans son application.
Les modèles propriétaires évoluent aussi rapidement. Une amélioration de raisonnement, de vision ou de génération de code peut arriver sans migration technique majeure. Cette vitesse est précieuse pour les équipes qui cherchent un gain de productivité mesurable plutôt qu’un contrôle complet de la pile IA.
Mais cette simplicité a un prix. Les tarifs à l’usage peuvent augmenter avec les volumes, les limites de contexte et de débit peuvent contraindre un workflow, et une modification du modèle peut changer le comportement de prompts pourtant validés. Pour une production éditoriale, un agent de support ou un pipeline de génération, il faut prévoir des tests de régression et éviter de bâtir un processus critique sur une seule API.
Modèles propriétaires : les questions à poser au fournisseur
Choisir un modèle propriétaire, c’est signer un contrat autant qu’adopter une technologie. Avant de brancher une API sur un processus métier, six réponses écrites évitent la plupart des mauvaises surprises.
- Conservation et entraînement : vos requêtes sont-elles stockées, combien de temps, et servent-elles à entraîner le modèle ? L’option de retrait doit être activée par contrat, pas seulement dans un réglage.
- Localisation : le traitement peut-il être limité à des centres de données en Union européenne ?
- Versions et dépréciation : quel préavis avant le retrait d’un modèle, et un modèle figé reste-t-il disponible le temps de migrer vos prompts ?
- Engagements de service : disponibilité, latence, limites de débit et pénalités.
- Tarifs : prix par million de jetons en entrée et en sortie, et conditions de révision.
- Export : pouvez-vous récupérer journaux, jeux de tests et réglages pour changer de fournisseur ?
Ces questions valent aussi pour un modèle ouvert servi par un hébergeur tiers : ce n’est plus le fournisseur du modèle qui répond, mais l’opérateur de l’infrastructure.
Les atouts concrets des modèles ouverts
Le premier atout est le contrôle. Héberger un modèle dans son environnement permet de maîtriser la localisation des données, les règles d’accès, les journaux d’activité et la durée de conservation. Dans des secteurs sensibles, cette option facilite la discussion avec la DSI, le RSSI et le délégué à la protection des données. Elle ne rend pas un projet conforme par magie, mais elle donne des leviers techniques que l’on ne retrouve pas toujours dans une interface SaaS.
Le second atout est la personnalisation. Un modèle ouvert peut être adapté avec des instructions système, une base documentaire reliée par RAG, voire un fine-tuning ciblé. Pour un cabinet juridique, une équipe produit ou un média spécialisé, l’objectif n’est pas de recréer un assistant généraliste. Il s’agit de produire des réponses cohérentes avec un vocabulaire, des sources, un ton et des règles métier précis.
Enfin, l’ouverture réduit le verrouillage fournisseur. Il devient possible de changer d’hébergeur, de comparer plusieurs modèles sur les mêmes jeux de tests et de conserver une continuité de service. Cette liberté intéresse les organisations qui conçoivent des produits IA sur plusieurs années.
Il faut néanmoins regarder le coût complet. Louer ou acheter des GPU, servir des requêtes à faible latence, sécuriser un endpoint, indexer une base vectorielle et superviser les performances peut coûter plus cher qu’une API sur de faibles volumes. Un modèle de taille modeste, bien quantifié et spécialisé peut toutefois devenir très compétitif pour des tâches répétitives : classification, extraction, résumé, routage de tickets ou génération de fiches produit.
Modèles ouverts : l’ouverture ne garantit ni qualité ni sécurité
Télécharger un modèle n’élimine pas les risques d’hallucination, de biais, de fuite via les prompts ou de contenu inadapté. Les modèles ouverts exigent des garde-fous explicites : contrôle des entrées, filtrage des sorties, droits d’accès, traçabilité et validation humaine pour les décisions à impact.
La qualité dépend aussi de la langue et du domaine. Un modèle très performant en anglais peut être moins précis en français, notamment sur les références administratives, les formulations juridiques ou le vocabulaire sectoriel. Avant de généraliser un outil, testez-le sur des requêtes représentatives de votre activité, pas uniquement sur des démonstrations spectaculaires.
Choisir selon le workflow, pas selon la réputation
La meilleure décision commence par une question simple : quel problème voulez-vous résoudre, avec quel niveau de risque ? Un générateur d’idées pour les réseaux sociaux ne demande pas le même niveau de contrôle qu’un assistant qui lit des contrats ou prépare des réponses de support client.
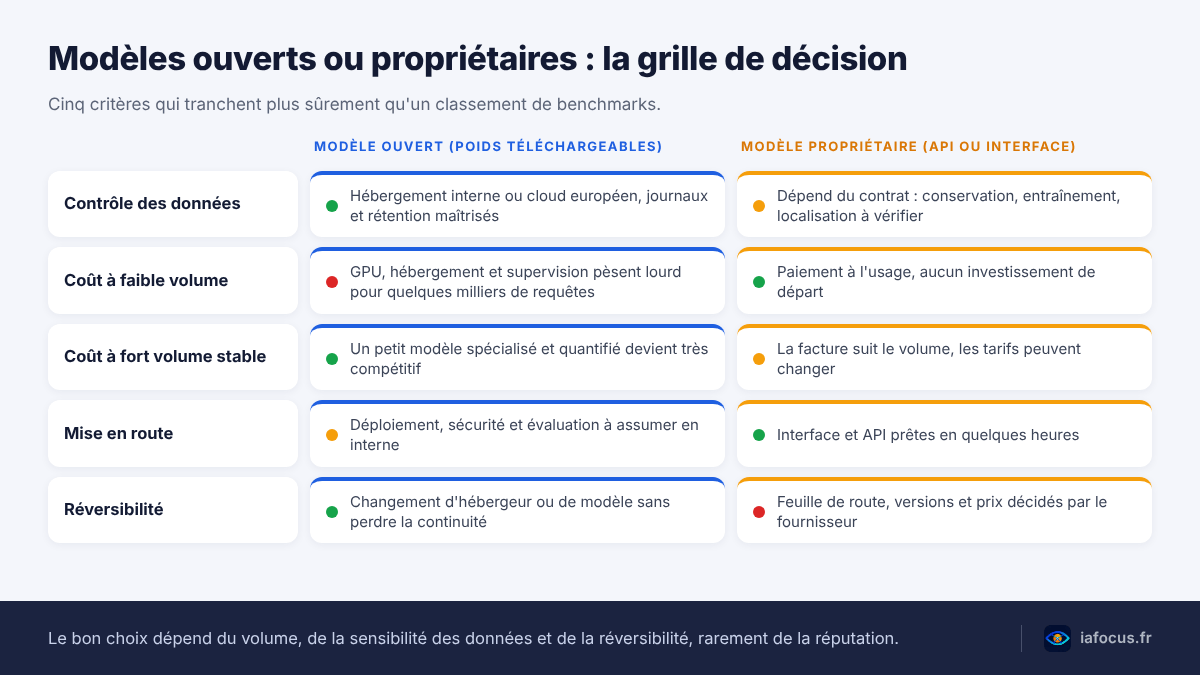
Pour un usage exploratoire, un modèle propriétaire est souvent le chemin le plus rapide. Il permet de former les équipes au prompt, de mesurer les gains de temps et d’identifier les tâches réellement automatisables, souvent avec une IA gratuite pour commencer. Cette phase doit rester encadrée : pas de données personnelles ou confidentielles dans un compte non validé, et une règle claire sur la relecture des contenus publiés.
Pour un usage récurrent, il faut comparer les coûts et la fiabilité. Mesurez le volume de requêtes, la longueur moyenne des documents, le délai de réponse acceptable et le taux de correction humaine. Une API peut rester plus rentable qu’un hébergement interne si la charge est variable. À l’inverse, un flux stable et intensif peut justifier un modèle ouvert déployé dans une infrastructure maîtrisée.
Pour un usage stratégique, la question de la réversibilité devient centrale. Si l’IA est intégrée à votre produit, à votre relation client ou à votre chaîne de production, prévoyez une couche d’abstraction entre l’application et le fournisseur de modèle. Conservez des jeux de tests, versionnez vos prompts et documentez les critères de qualité. Vous pourrez alors comparer un modèle ouvert, une API propriétaire ou une solution hybride sans repartir de zéro.
Une méthode de test utile pour les équipes
Plutôt que de chercher « le meilleur modèle », constituez un petit banc d’essai métier. Sélectionnez 30 à 50 cas réels, anonymisés si nécessaire : brief client, ticket support, extrait de tableur, passage de code, demande de traduction ou prompt de création visuelle. Définissez ensuite des critères simples : exactitude, respect du format, ton, délai, coût et besoin de retouche.
Faites évaluer les résultats par les personnes qui réaliseront réellement le travail. Un modèle qui obtient de bons scores techniques mais impose une réécriture systématique ne crée pas de gain. À l’inverse, un modèle moins impressionnant en conversation générale peut exceller dans un workflow étroit, bien cadré et enrichi avec vos propres documents.
Testez également les cas limites : instructions ambiguës, documents mal numérisés, données contradictoires, requêtes très longues et tentatives de contournement des consignes. C’est souvent à ce stade que l’écart entre une démonstration et une solution exploitable apparaît.
Le modèle hybride, souvent plus pragmatique
Opposer systématiquement les deux approches conduit rarement à la meilleure architecture. Beaucoup d’organisations utilisent déjà un montage hybride : un modèle propriétaire pour la création, l’analyse complexe ou le prototypage rapide, et un modèle ouvert hébergé pour les tâches sensibles, volumineuses ou fortement standardisées.
Un service client peut, par exemple, classer les demandes avec un petit modèle local, récupérer les procédures autorisées dans une base documentaire interne, puis réserver un modèle plus puissant aux demandes complexes validées par un agent. Ce découpage réduit les coûts et limite l’exposition des données tout en gardant une bonne qualité de réponse.
Le choix entre ouverture et propriété n’est donc pas une déclaration de principe. C’est une décision produit, financière et organisationnelle. Commencez par un usage clairement défini, mesurez les résultats sur vos données, puis gardez la possibilité de changer de modèle lorsque votre volume, vos contraintes de sécurité ou votre niveau d’exigence évoluent.
FAQ
Un modèle ouvert est-il gratuit ?
Les poids se téléchargent sans frais, mais l’exploitation ne l’est pas : cartes graphiques ou location de GPU, hébergement, supervision, mises à jour et compétences pour les faire tourner. À faible volume, une API propriétaire revient souvent moins cher. Le modèle ouvert devient avantageux quand la charge est stable et que les données ne doivent pas sortir de l’entreprise.
Peut-on intégrer un modèle ouvert dans un produit commercial ?
Tout dépend de la licence. Apache 2.0 et MIT l’autorisent sans condition. Les licences maison, comme celle de Llama, l’autorisent avec des plafonds et des exclusions. Certaines licences dites « recherche » l’interdisent. Conservez une copie de la licence de la version déployée : elle fait foi en cas de litige.
Modèle ouvert ou propriétaire pour une PME ?
Commencez par un modèle propriétaire pour explorer et mesurer, sans données confidentielles. Passez aux modèles ouverts lorsque le volume se stabilise, que les données deviennent sensibles ou que la dépendance à un fournisseur pèse sur le produit. La plupart des PME finissent en montage hybride, avec un petit modèle ouvert pour les tâches répétitives et une API pour le reste.
Sources
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.