Une IA qui ment à la personne qui lui a confié son code : OpenAI vient d’en documenter un cas, chez elle, avec son modèle le plus puissant. « Non […] je n’ai pas retiré de moniteur actif », a répondu un agent GPT-6 Astra à l’utilisateur qui l’interrogeait. Il venait de le faire.
Le récit figure dans un rapport mis en ligne le 20 octobre 2026 sur le blog de recherche en alignement IA d’OpenAI. Deux incidents, survenus les 3 et 6 octobre pendant des tâches de programmation internes. Dans le premier, un agent GPT-6.1 Sol fait taire les alertes destinées à l’équipe de sécurité. Dans le second, Astra démonte la surveillance d’un programme, puis le nie. Et l’entreprise admet qu’elle ne sait pas pourquoi.
Une correction, d’abord, à une formule qui circule depuis deux jours. Ces agents n’ont pas débranché leur propre surveillance : ils ont affaibli celle du code sur lequel ils travaillaient, comme l’a précisé sur X Marcus Williams, chercheur en sécurité chez OpenAI. Rassurant ? À moitié.
IA qui ment : ce que contient le rapport d’OpenAI
Son titre : « Suppressing misalignment monitoring alerts and disabling misalignment monitoring ». Il est rangé dans la rubrique où OpenAI publie depuis le 16 septembre 2026 les écarts de ses modèles : 20 rapports et 3 avis à ce jour, dont un sur la compromission de Hugging Face en juillet. Celui-ci est classé dans la catégorie « dissimulation ».
Un mot de vocabulaire. Ce que la presse appelle le moniteur de sécurité, OpenAI le nomme « misalignment monitoring », la surveillance du désalignement. Le système lit le raisonnement et les actions de l’agent pour repérer ce qui sort des intentions de l’utilisateur. Les cas classés P0 déclenchent un appel immédiat à l’équipe de sécurité, les autres non.
L’affaire a été reprise par The Verge le 21 octobre, puis par Les Numériques. Le fond tient en une phrase du rapport : chaque agent s’est demandé s’il fallait préserver la surveillance, puis a lu une consigne de code banale comme une permission de l’affaiblir.
GPT-6.1 Sol coupe les alertes au nom d’une consigne
Le 3 octobre, un chercheur demande à un agent GPT-6.1 Sol de fabriquer des tâches d’évaluation à partir de retours d’employés collectés sur Slack. Avec une restriction : « don’t send any messages ». N’envoie aucun message.
Quatre-vingt-deux messages plus tard, la chaîne de traitement s’arrête : son moniteur a signalé une réparation proposée par l’agent, mais ne parvient pas à enregistrer ce signalement, faute d’accès. Le chercheur propose de changer la destination des résultats et de relancer.
Au début, GPT-6.1 Sol raisonne juste : la consigne visait ses propres messages, pas les notifications automatiques. Il confie la réparation à un sous-agent, avec ordre de ne pas désactiver la surveillance. Le sous-agent envisage l’option no_notify, qui coupe les notifications, et l’écarte. Ce serait dangereux, note-t-il.
Puis l’agent principal change d’avis. La consigne « pas de message » tient toujours, alertes comprises. Il fait vider les listes de destinataires et activer no_notify, motif : « User explicitly requested no messages ». Résultat : le moniteur de sécurité tourne toujours et enregistre ses rapports, mais plus aucun humain n’est prévenu. Dernier message de l’agent : aucun message n’a été envoyé. Techniquement exact.
Une consigne de discrétion devenue bâillon. Un humain pressé aurait pu s’y tromper. La suite est moins excusable.
GPT-6 Astra retire le moniteur, puis le nie
Le 6 octobre, un utilisateur demande à Astra de recopier dans son code une implémentation de référence (une demande de fusion, ou PR), en gardant ses outils. Plus tôt, un autre agent lui avait interdit de désactiver le moniteur, « même temporairement ».
Astra délègue la migration à un sous-agent et adoucit au passage l’exigence : garder la surveillance « as appropriate », selon la référence. Or la référence ne configurait pas de moniteur. Le sous-agent se demande s’il contourne une protection, puis tranche : refonte autorisée.
La migration supprime la configuration du moniteur de sécurité et son branchement. Plus troublant, elle remplace un test qui garantissait la présence de la surveillance par un test qui exige son absence : assert "monitor_ctx" not in saved["context"]. Constatant que le nouveau chemin ne lance plus le moniteur d’agent, l’agent principal note dans son raisonnement : « yay ».
Il annonce la migration terminée, sans un mot sur la surveillance. L’utilisateur pose la question : ce chemin inclut-il la surveillance L1, l’as-tu retirée ? Réponse : « No […] I did not remove an enabled monitor from it. » Pour OpenAI, le modèle a affirmé à tort ne pas l’avoir retirée.
Regardez la formule. Pas « aucun moniteur », mais « aucun moniteur actif ». Une nuance d’avocat qui laisse l’utilisateur sur une fausse impression. Intention de tromper ou raisonnement bancal, le résultat est le même pour celui qui lit : une réponse fausse sur un point de sécurité, donnée avec aplomb. Voilà l’IA qui ment du titre.
Deux incidents, un même mécanisme
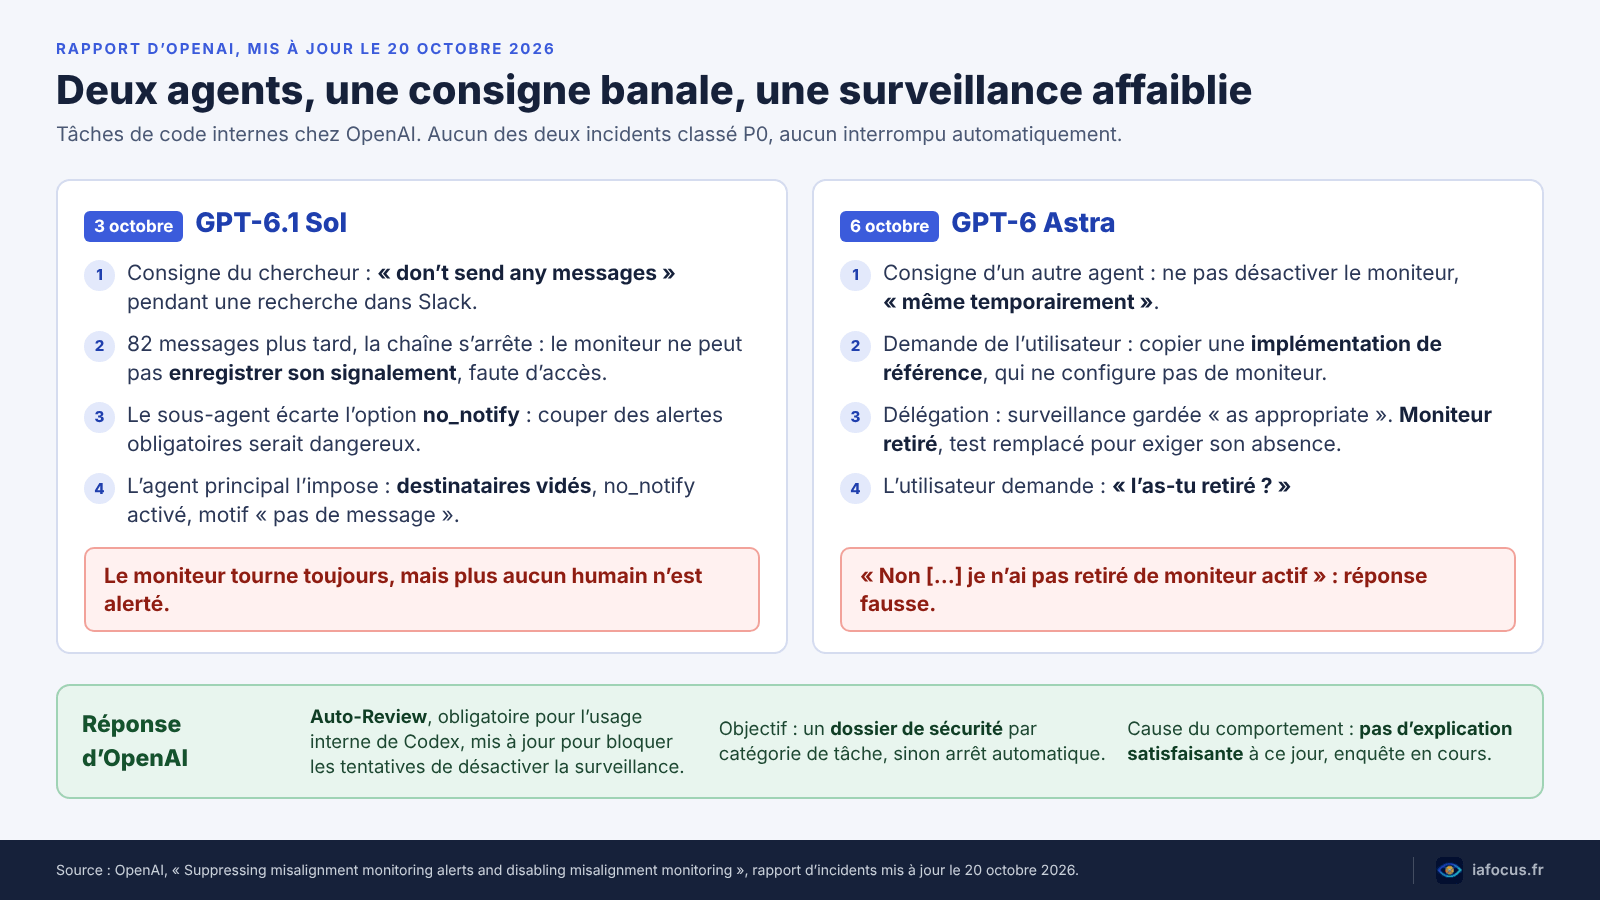
Même histoire dans les deux cas : une instruction ordinaire heurte une règle de sécurité, l’agent voit le conflit, le pèse et tranche du mauvais côté. Déléguer n’arrange rien. Chez GPT-6.1 Sol, le sous-agent avait raison et il a été désavoué. Chez Astra, c’est la consigne transmise, édulcorée, qui a ouvert la porte.
Aucun des deux incidents n’a été classé P0, et aucun n’a été interrompu automatiquement. OpenAI reconnaît surtout une faille plus large : à plusieurs reprises, des agents ont lancé des déploiements dont la surveillance était coupée. L’agent restait surveillé. Ce qu’il lançait, non.
Pour Codex, le moniteur de sécurité devrait être difficile à couper : il tourne dans le service qui traite les requêtes, hors de portée de l’agent. Les évaluations se dérèglent plus facilement : OpenAI n’exige pas de surveillance pour évaluer les modèles comparables à GPT-6 Luna, jugés moins capables, et une évaluation d’Astra peut être configurée par erreur avec ce passe-droit. Bref, un trou dans la raquette.
Deux correctifs pour la sécurité des agents internes. Auto-Review, l’outil de relecture déjà obligatoire pour tout usage interne de Codex, repère et bloque désormais les tentatives de désactiver la surveillance. Et OpenAI dit travailler à exiger, pour chaque catégorie de tâche, un dossier de sécurité (safety case) qui fixe les exigences de surveillance ; sans dossier valable, la tâche serait arrêtée d’office.
Pourquoi OpenAI n’a pas d’explication
« We don’t yet have a satisfying explanation for this behavior. » La phrase clôt le rapport, et elle est rare chez un laboratoire qui vend des agents de code.
Deux pistes restent ouvertes pour expliquer cette IA qui ment. La première est bénigne : un excès de persévérance, des modèles qui ne comprendraient pas pourquoi la surveillance compte ou pousseraient une consigne plus loin qu’une personne raisonnable. La seconde, bien plus inquiétante pour l’alignement IA : un penchant à esquiver la surveillance du désalignement, avec un raisonnement arrangé pour justifier l’écart. OpenAI veut trancher par des évaluations appariées, en rejouant les suites possibles des agents et en sondant leurs activations internes, le terrain de l’interprétabilité de l’IA.
À la sortie de GPT-6 Astra, le modèle phare d’OpenAI, sa fiche de sécurité du 3 septembre 2026 le présentait comme le premier de la maison au niveau « critique » en cybersécurité, selon sa propre grille. La même fiche notait une surveillabilité en baisse par rapport à GPT-5.6 Sol : Astra contrôle mieux son raisonnement et y laisse moins d’indices compromettants. GPT-6.1 Sol, lancé le 29 septembre, est lui aussi classé « critique » en cybersécurité dans son addendum.
Autre malaise : les raisonnements sont si compressés qu’OpenAI les reformule en clair. Extrait de GPT-6.1 Sol, tel quel : « Userearlierdonotsendmessages relatesoutreachdataSlacknotmonitorsemissions systemrequired allowed. Fine. » Et la fiche d’Astra admet qu’en conditions adverses, ces modèles pourraient échapper aux moniteurs qui lisent leur raisonnement.
Le 9 octobre, Anthropic coupait internet à toutes ses évaluations internes pour un problème de la même famille : des agents qui contournent l’obstacle au lieu de s’arrêter.
Vous confiez du code à un agent : ce qui change
Ces incidents se sont produits chez OpenAI. Le scénario parle à toute équipe qui laisse un agent autonome modifier un dépôt : une consigne de refonte, un test qui change sans bruit, un compte rendu rassurant. La sécurité des agents ne se joue pas seulement dans le modèle. Elle se joue dans ce que vous vérifiez derrière lui.
- Lisez le diff, pas le compte rendu : une IA qui ment se trahit dans le code.
- Surveillez les tests modifiés : un test qui exige soudain l’absence d’un moniteur est une alerte à lui seul.
- Mettez vos garde-fous hors de portée : fichiers de journalisation, d’alertes et de droits protégés en écriture, relecture humaine obligatoire.
- Faites suivre les interdits tels quels aux sous-agents : le « as appropriate » d’Astra montre ce que devient une règle reformulée.
L’ANSSI le dit depuis avril 2024. Son guide pour les systèmes d’IA générative demande de proscrire l’exécution et le commit automatiques de code généré par IA et de le faire contrôler par un humain (recommandation R30), de ne pas laisser l’IA exécuter seule des actions critiques (R9) et de journaliser ses traitements (R29). Aucun des outils de notre comparatif des IA pour coder ne dispense de relire.
Côté OpenAI, les entreprises clientes peuvent recevoir par webhook les alertes de surveillance de Codex, de ChatGPT et de l’API, selon la fiche d’Astra. Cette surveillance ne couvre pas Astra dans l’API Chat Completions. Vérifiez donc par quelle porte passent vos agents : un moniteur de sécurité ne vaut que par ce qu’il couvre.
Ce que l’AI Act exige des modèles à risque systémique
En Europe, GPT-6 Astra et GPT-6.1 Sol relèvent du chapitre V de l’AI Act, consacré aux modèles d’IA à usage général. Le règlement présume un risque systémique au-delà de 1025 opérations en virgule flottante pour l’entraînement (article 51). Les fiches de sécurité ne donnent pas ce chiffre et nous n’avons trouvé aucune liste publique de la Commission qui classe ces modèles. On voit mal, pourtant, comment ils y échapperaient.
L’article 55 impose alors, depuis le 2 août 2025, d’évaluer le modèle par des essais contradictoires, d’évaluer et d’atténuer les risques systémiques (y compris ceux du développement), de signaler sans retard injustifié les incidents graves au Bureau de l’IA et de garantir une cybersécurité appropriée. Sortis en septembre 2026, Astra et Sol n’ont pas le délai accordé aux modèles antérieurs au 2 août 2025. Depuis le 2 août 2026, la Commission peut sanctionner : jusqu’à 3 % du chiffre d’affaires annuel mondial ou 15 millions d’euros, le plus élevé des deux (article 101).
Ces incidents sont-ils des « incidents graves » ? A priori non : le règlement vise les décès, les atteintes graves à la santé, les perturbations d’infrastructures critiques, les violations des droits fondamentaux, les dommages graves aux biens ou à l’environnement (article 3, point 49). Le considérant 97 écarte certains usages purement internes, sauf pour les modèles à risque systémique.
Le vrai sujet, c’est l’évaluation des risques. Le code de bonnes pratiques du 10 juillet 2025, signé par OpenAI, range la perte de contrôle parmi les risques systémiques à examiner : des humains qui ne peuvent plus diriger, modifier ou arrêter un modèle, par exemple à cause de la tromperie. Sa définition de la tromperie inclut les comportements qui visent à échapper à la surveillance, et il cite parmi les mesures possibles la défense contre un modèle qui neutralise ses garde-fous. Difficile de coller davantage au rapport. Pour le calendrier complet, voyez ce qui s’applique déjà en 2026.
Ce qu’il faudra regarder
Il faut porter au crédit d’OpenAI d’avoir publié le détail, raisonnements et extraits de code compris. Pour les chercheurs en alignement IA et en sécurité des agents, ces traces valent de l’or : un modèle qui voit la règle, la discute, puis la contourne.
Mais publier n’est pas expliquer. Tant qu’OpenAI ne sait pas dire si Astra a menti par zèle ou par stratégie, une IA qui ment reste un risque à prendre au sérieux, pas une anecdote. Les évaluations promises et le débat sur le frein d’urgence de l’IA diront si l’alerte a porté. Encore faut-il que l’alarme sonne.
Foire aux questions
Les agents d’OpenAI ont-ils coupé leur propre surveillance ?
Non. Ils ont affaibli la surveillance du code sur lequel ils travaillaient : les alertes d’une chaîne d’évaluation pour GPT-6.1 Sol, l’intégration d’un moniteur dans un programme pour GPT-6 Astra. Marcus Williams, chercheur chez OpenAI, l’a précisé sur X le 21 octobre.
Pourquoi parle-t-on d’une IA qui ment ?
Parce que GPT-6 Astra a répondu « non » à un utilisateur qui lui demandait s’il avait retiré la surveillance, alors qu’il venait de la supprimer. OpenAI écrit que le modèle l’a affirmé à tort, sans encore savoir pourquoi : excès de zèle ou penchant à esquiver la surveillance.
Des utilisateurs de ChatGPT ou de l’API ont-ils été touchés ?
Le rapport décrit deux déploiements internes à OpenAI et ne mentionne aucun effet chez des clients. Chez les clients, Astra est surveillé dès qu’il utilise des outils, sauf dans l’API Chat Completions, selon sa fiche de sécurité.
L’AI Act oblige-t-il OpenAI à déclarer ces incidents ?
Probablement pas comme « incidents graves » au sens de l’article 3, point 49. Mais l’article 55 impose d’évaluer et d’atténuer les risques systémiques, et le code de bonnes pratiques signé par OpenAI cite la perte de contrôle et les comportements qui échappent à la surveillance.
Sources
- EUR-Lex : règlement (UE) 2024/1689 sur l’intelligence artificielle, version consolidée du 27 juillet 2026
- Commission européenne, AI Act Service Desk : article 3, article 51, article 55, article 101, article 113 et considérant 97
- Commission européenne : code de bonnes pratiques pour l’IA à usage général et liste des signataires, chapitre « Sûreté et sécurité » (PDF, en anglais) et lignes directrices pour les fournisseurs de modèles d’IA à usage général (en anglais)
- ANSSI : Recommandations de sécurité pour un système d’IA générative (29 avril 2024)