Un devis non publié, des données RH, un export CRM ou le code d’un produit : rien de tout ça ne devient anodin parce qu’on l’a collé dans une fenêtre de chat. Quand on associe IA et données sensibles, il faut donc chercher un cadre d’usage vérifiable plutôt qu’un nom de modèle miracle. Où part la donnée ? Qui peut y accéder ? Combien de temps reste-t-elle stockée, et sert-elle (ou non) à entraîner le système ?
Le choix change d’un métier à l’autre. Pour un rédacteur, la priorité peut être de ne pas divulguer la stratégie éditoriale d’un client. Une équipe produit jongle parfois avec des spécifications, des tickets et des logs. Un cabinet de conseil peut manipuler des informations contractuelles ou personnelles. Mais dans tous les cas, l’IA n’est qu’une pièce du dispositif. La protection repose sur l’édition du service, son contrat, ses paramètres, l’identité des utilisateurs et les règles internes de l’organisation.
IA et données sensibles : de quoi parle-t-on exactement ?
Attention au mot « sensible » : il recouvre deux réalités qu’il vaut mieux distinguer. En droit, les données sensibles forment une catégorie particulière de données personnelles, définie par l’article 9 du RGPD : origine prétendument raciale ou ethnique, opinions politiques, convictions religieuses ou philosophiques, appartenance syndicale, données génétiques, biométriques, de santé, vie sexuelle ou orientation sexuelle. Leur traitement est interdit par principe, sauf exceptions limitées (la définition de la CNIL le rappelle).
En entreprise, on parle plutôt de données confidentielles : un contrat en négociation, une marge, une feuille de route produit, un code source, un dossier client, une vulnérabilité non corrigée. Ces informations ne sont pas forcément personnelles, mais leur fuite peut coûter cher. Un projet sérieux associant IA et données sensibles doit traiter les deux familles, et pour cause : un même document mélange souvent les deux. Un dossier d’aménagement de poste, par exemple, associe organisation interne et informations de santé.
Quel type d’IA choisir pour vos données sensibles selon l’usage ?
La réponse la plus prudente ? Des garanties explicites sur la non-utilisation des contenus pour l’entraînement, une gestion sérieuse des accès, des conditions de conservation maîtrisables et un cadre juridique compatible avec votre activité : une IA qui coche ces cases est adaptée aux données sensibles. Les offres grand public gratuites atteignent rarement ce niveau d’exigence. Pour des exercices sans conséquence, des prompts fictifs ou de la veille, elles restent utiles. Mais elles ne doivent pas devenir le canal par défaut pour des données confidentielles : notre guide pour sécuriser ses données dans les outils IA détaille les réglages et les règles d’usage qui l’évitent.
Vos équipes travaillent déjà dans Microsoft 365 ou Google Workspace ? Les assistants intégrés à ces environnements peuvent alors être pertinents. Au-delà du modèle, leur intérêt tient à l’administration centralisée, à la gestion des comptes professionnels, aux politiques de sécurité et aux droits déjà définis dans l’entreprise. C’est la logique de Microsoft Copilot (anciennement Microsoft 365 Copilot) et de Gemini dans Google Workspace. Encore faut-il vérifier de près les licences, les périmètres de données indexés et les réglages activés par l’administrateur.
Autre voie : les éditions professionnelles de ChatGPT, de Claude ou d’autres assistants généralistes. Pour la rédaction, l’analyse documentaire, le code ou la synthèse, elles sont souvent plus pratiques. Mais attention : « offre entreprise » ne veut pas dire automatiquement « conforme à tous les cas d’usage ». Lisez donc les engagements contractuels : entraînement sur les données clients, durée de rétention, localisation des traitements, sous-traitants, journalisation et modalités de suppression. Notre méthode pour choisir un assistant IA pour l’entreprise détaille cette grille de lecture.
Enfin, la voie qui donne le plus de maîtrise : des modèles déployés dans un environnement que vous contrôlez. Prenez un modèle à poids ouverts (open weight), comme certaines familles Mistral, Llama ou Qwen : il peut être exécuté sur une infrastructure interne ou chez un hébergeur sélectionné, par exemple pour faire tourner un agent IA open source sous votre contrôle. Cette approche se justifie pour les données sensibles les plus critiques, les contraintes de souveraineté ou les workflows métier spécifiques. Le revers de la médaille est bien réel : l’entreprise doit financer l’infrastructure, sécuriser les API, gérer les mises à jour, évaluer le modèle et entretenir les compétences techniques nécessaires.
IA et données sensibles : ce que garantissent les offres professionnelles en 2026
Les promesses varient d’un éditeur à l’autre. Et surtout, chez un même éditeur, d’une formule à l’autre. Ci-dessous, ce que disent les documentations officielles, consultées en septembre 2026, sur le sort des données confidentielles de leurs clients professionnels. Elles changent régulièrement : relisez-les au moment de signer, et faites valider le contrat par votre DPO.
ChatGPT : Business, Enterprise et API
OpenAI indique que les contenus des formules ChatGPT Business, Enterprise et Edu, comme ceux de son API, ne servent pas par défaut à entraîner ses modèles, sauf adhésion explicite du client. Pour ChatGPT Enterprise, ChatGPT Edu et l’API, des options de résidence des données en Europe existent. Sur les comptes personnels Free, Plus et Pro, c’est l’inverse : le partage pour l’entraînement est activé par défaut, et il se coupe dans les paramètres de contrôle des données, via l’option « Améliorer le modèle pour tout le monde », comme l’explique le centre d’aide d’OpenAI.
Claude : comptes personnels et offres commerciales
Anthropic, lui, a revu le 28 août 2025 les conditions de ses offres grand public Claude Free, Pro et Max : c’est désormais l’utilisateur qui choisit si ses conversations servent à améliorer les modèles. S’il accepte, la conservation passe à cinq ans. S’il refuse, elle reste de 30 jours. Selon l’annonce officielle d’Anthropic, ce changement ne touche pas les offres régies par les conditions commerciales : les formules Team et Enterprise, l’API et l’accès via Amazon Bedrock ou Google Cloud Vertex AI. Autrement dit, un abonnement Pro payé à titre personnel n’est pas un canal adapté aux données confidentielles de l’entreprise.
Microsoft Copilot et Gemini dans Google Workspace
Microsoft 365 Copilot est devenu Microsoft Copilot. Microsoft n’a annoncé, à cette occasion, aucun changement sur la sécurité ni la confidentialité. Sa page sur la protection des données d’entreprise précise que prompts et réponses bénéficient des mêmes engagements contractuels que les courriels d’Exchange ou les fichiers de SharePoint, et que ni eux ni les données consultées via Microsoft Graph ne servent à entraîner les modèles de fondation.
Cette même page pose deux réserves. Les requêtes web envoyées à Bing relèvent d’un autre cadre. Et les modèles d’Anthropic proposés dans Copilot sont, pour l’instant, exclus de la limite de données de l’UE (EU Data Boundary). Autre point à ne pas rater : ces engagements valent pour Copilot utilisé par une organisation, avec un compte professionnel. Pas pour l’application Copilot grand public ouverte avec un compte Microsoft personnel.
Côté Google, vos contenus ne sont ni relus par des humains ni utilisés pour entraîner les modèles en dehors de votre domaine sans autorisation : c’est ce que précise le centre de confidentialité de l’IA générative dans Workspace. Attention au périmètre, là encore : cet engagement vaut pour les éditions Workspace éligibles. Un compte Gmail personnel n’est pas couvert : il relève des règles des applications Gemini grand public.
Ces deux assistants respectent les droits d’accès existants : ils ne voient que ce que l’utilisateur peut déjà ouvrir. Une force, oui. Et un révélateur. Un dossier RH contenant des données sensibles a été partagé par erreur avec toute l’entreprise ? D’un coup, une simple question suffit à le trouver. Avant d’activer un assistant de ce type, commencez donc par traquer les partages trop larges : c’est souvent le chantier le plus rentable.
Mistral : Vibe, l’ancien Le Chat
Longtemps, l’assistant de Mistral AI s’appelait Le Chat. Il a été rebaptisé Vibe en 2026. L’éditeur a beau être européen, il faut quand même régler les paramètres avant d’y déposer des données confidentielles. Selon le centre d’aide de Mistral, sur Vibe hors offre Enterprise, les entrées et les réponses servent par défaut à l’entraînement, sauf désactivation, et seuls les clients Enterprise en sont exclus par défaut. Piège à connaître : cliquer sur « pouce levé » ou « pouce baissé » autorise l’usage de l’échange noté, quel que soit le plan.
Ne confondez pas modèle, hébergement et politique de données
Deux outils peuvent reposer sur un modèle similaire et présenter pourtant des risques très différents. L’un peut tourner en SaaS, avec des données transmises à un fournisseur hors de votre périmètre. L’autre peut passer par une instance dédiée, une région européenne ou un cloud privé. Le nom du modèle ne suffit donc pas à trancher. Et le débat entre modèles ouverts et propriétaires ne dit rien, à lui seul, de l’endroit où vos fichiers seront traités.
La première question est simple : les prompts, les fichiers joints et les réponses servent-ils à entraîner les modèles ? Dès que des données confidentielles sont en jeu, la réponse attendue est non, engagement documenté à l’appui. Méfiez-vous aussi des options activées par défaut et des différences entre l’interface grand public, une API et une formule entreprise. Et une politique de confidentialité générale ne remplace pas un accord de traitement des données adapté à votre organisation.
Deuxième question, moins spectaculaire : la rétention. Certains services conservent les échanges pendant une période limitée, pour la sécurité ou le débogage. D’autres laissent régler cette durée, la réduire ou l’encadrer par contrat. Pour une équipe juridique, financière ou médicale qui manipule des données confidentielles, ce point pèse souvent plus lourd qu’un léger écart de qualité rédactionnelle entre deux modèles.
La troisième touche à la localisation et aux transferts. Héberger en Europe peut faciliter la gouvernance. Mais ce n’est pas un label absolu de conformité. Regardez aussi l’entité contractante, les accès de support, les sous-traitants et les mécanismes prévus en cas de transfert international. Le RGPD, lui, impose une analyse contextualisée dès que des données personnelles sont concernées, et le règlement européen sur l’IA s’y ajoute sans le remplacer.
Le cadre français et européen à connaître
Le socle ne change pas : c’est le RGPD. Dès qu’un usage de l’IA touche des données personnelles, il faut une finalité définie, une base légale, une minimisation des données envoyées et une information des personnes. Si le traitement présente un risque élevé (par exemple s’il porte sur des données de santé ou sur des personnes vulnérables), une analyse d’impact relative à la protection des données (AIPD) s’impose. La CNIL a publié en 2024 et 2025 des fiches pratiques consacrées au développement des systèmes d’IA, dont une sur l’analyse d’impact. Elles visent d’abord les concepteurs. Mais une entreprise utilisatrice y trouvera la méthode de l’AIPD.
Pour l’hébergement, la qualification SecNumCloud de l’ANSSI place la barre haut. En plus des critères techniques, elle vise à protéger les données sensibles et les traitements associés face à l’application de lois extraterritoriales. Parmi elles, le CLOUD Act américain de 2018, qui permet aux autorités des États-Unis de demander des données à un fournisseur soumis à leur droit, même stockées hors du territoire américain. Les offres qualifiées sont listées par l’ANSSI sur sa page consacrée au cloud.
La santé, elle, ajoute sa propre règle. En France, l’hébergement de données de santé collectées lors d’activités de prévention, de diagnostic, de soins ou de suivi social et médico-social pour le compte d’un tiers exige un hébergeur certifié HDS, en application de l’article L1111-8 du Code de la santé publique. Les comptes rendus médicaux sont des données sensibles au sens du RGPD. Un assistant d’IA généraliste qui en reçoit doit donc être examiné sous cet angle, en plus des règles générales de protection des données. Dans tous ces cas, une politique de gouvernance des données écrite évite de trancher au coup par coup.
Les critères à vérifier avant de confier des données sensibles à une IA
Pour comparer des plateformes, partez du flux de données, pas des promesses marketing. Quelles données sensibles ou confidentielles entrent dans l’outil ? Qui peut les déposer ? Que produit l’IA ? Où le résultat est-il ensuite enregistré ? Une fois le flux dessiné, le point faible saute souvent aux yeux : un export téléchargé sur un poste non géré, un connecteur trop permissif ou un compte partagé entre plusieurs collaborateurs.
À vérifier ensuite : l’authentification et les droits. SSO, authentification multifacteur, gestion des rôles, provisionnement automatique : non, ce ne sont pas des détails réservés aux grands groupes. Ils évitent qu’un ancien collaborateur garde un accès à l’historique des conversations ou aux espaces partagés. Et les journaux d’audit ? Tout aussi utiles, pour savoir quel fichier a été envoyé, par qui et dans quel workflow.
Le chiffrement en transit et au repos est devenu un prérequis : il ne départage plus les offres. Il faut donc creuser. Le fournisseur propose-t-il une isolation logique ou une instance dédiée ? Dans certaines configurations, les clés sont-elles gérées par le client ? Les données peuvent-elles être supprimées à la demande ? Et un administrateur peut-il désactiver l’historique, les connecteurs ou le partage externe ?
Dès qu’il y a des données personnelles, et a fortiori des données sensibles, demandez aussi un accord de traitement des données, la liste des sous-traitants et les modalités d’exercice des droits. Les secteurs régulés, eux, doivent ajouter leurs exigences propres : secret professionnel, hébergement de données de santé, exigences bancaires, règles de défense ou clauses contractuelles de leurs donneurs d’ordre. Dans ces environnements-là, la validation du DPO, du RSSI ou du service juridique doit précéder le déploiement. Pas intervenir après les premiers usages.
Trois architectures pour concilier productivité et confidentialité
La plus accessible : l’IA SaaS en formule professionnelle. Elle convient aux contenus internes à sensibilité modérée, aux notes de réunion, à la rédaction assistée et à l’analyse de documents préalablement nettoyés. Son atout, c’est la rapidité de déploiement. Sa limite ? Vous dépendez des garanties du fournisseur et de la rigueur de vos utilisateurs.
Au deuxième niveau, on utilise un modèle via une API ou un cloud d’entreprise, avec une région choisie, des identités gérées et des règles réseau. Vous gagnez en contrôle sur les applications et sur les données envoyées au modèle. Pour un chatbot interne, un assistant de recherche documentaire ou un workflow de génération connecté au SI, c’est bien adapté. Le prix à payer, c’est une équipe capable de construire des garde-fous techniques.
Troisième niveau, le déploiement privé ou auto-hébergé. Quand des données sensibles ne doivent jamais quitter un périmètre déterminé, c’est le choix le plus cohérent. En prime, on peut y combiner un modèle avec une base documentaire interne via RAG (génération augmentée par la recherche documentaire), sans confier cette base à un assistant public. Reste que l’auto-hébergement ne protège rien par magie : une API exposée, un serveur mal configuré ou des traces de logs non purgées peuvent annuler l’avantage initial.
Un workflow sûr commence avant le prompt
Classez l’information avant de l’envoyer à une IA : c’est le meilleur réflexe. Les contenus publics ou déjà publiés peuvent circuler avec peu de contraintes. Pour les données internes, il faut une offre professionnelle et un compte administré. Quant aux données confidentielles, personnelles, médicales, financières ou couvertes par un secret, elles doivent suivre un processus validé, souvent avec anonymisation, pseudonymisation ou environnement dédié.
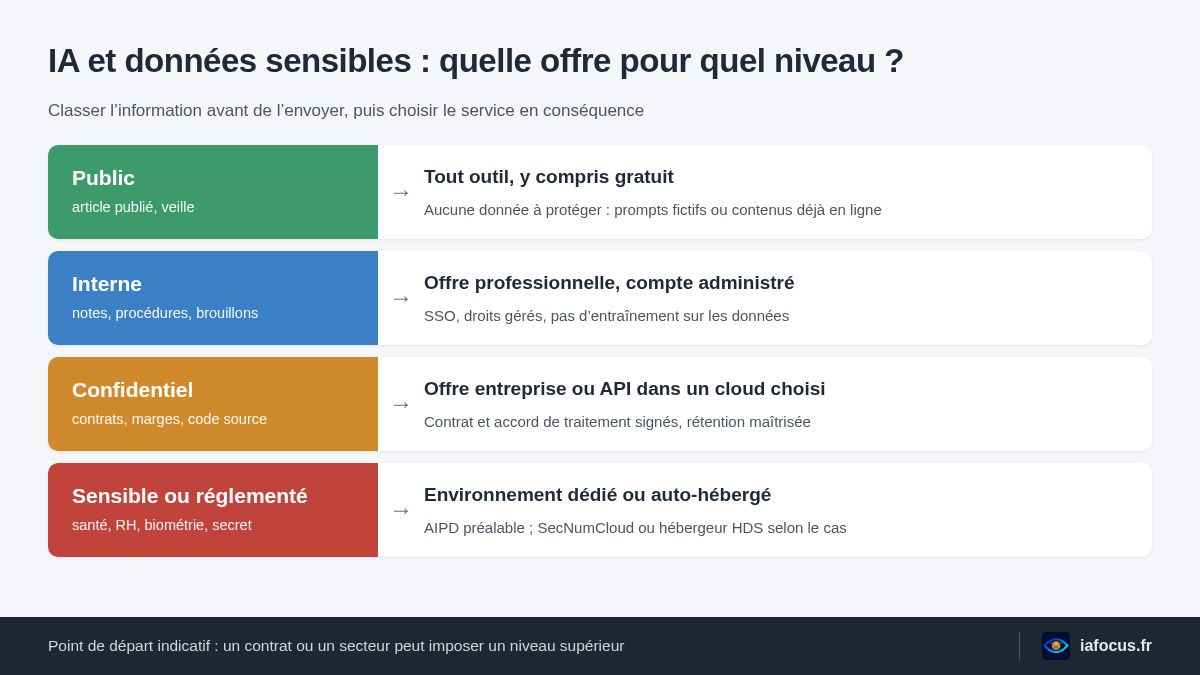
Le tableau ci-dessous décline ces quatre niveaux en exemples concrets. Voyez-le comme un point de départ, pas comme une règle universelle : un contrat, un secteur ou une clause client peut imposer un niveau supérieur.
| Niveau de sensibilité | Exemples | Type d’offre acceptable |
|---|---|---|
| Public | Article publié, fiche produit en ligne, veille | Tout outil, y compris gratuit |
| Interne | Notes de réunion, procédures, brouillons | Offre professionnelle avec compte administré |
| Données confidentielles | Contrats, marges, code source, feuille de route | Offre entreprise sans entraînement, contrat et accord de traitement des données (DPA) signés, ou API dans un cloud choisi |
| Données sensibles ou réglementées | Santé, RH, données biométriques, secret professionnel | Environnement dédié ou auto-hébergé (SecNumCloud, HDS selon le cas), après AIPD |
Un cas concret. Une équipe marketing veut analyser les retours de clients pour préparer une campagne. La tentation serait de copier des verbatims bruts, avec noms, e-mails et références de commande. À éviter. L’équipe peut plutôt supprimer les identifiants directs, regrouper les commentaires dans un document contrôlé et demander une analyse thématique. Le résultat garde le gros de la valeur métier, avec une exposition réduite.
Même logique pour le code, qui contient souvent plus de données confidentielles qu’il n’y paraît. Évitez donc d’envoyer des clés API, des secrets, des fichiers de configuration de production ou des extraits qui trahissent une vulnérabilité non corrigée. Côté développement, le risque baisse fortement avec un filtre automatique avant envoi et des règles de détection de secrets dans le pipeline (nous le rappelons dans notre tour des usages de l’IA pour les développeurs). Dans les équipes éditoriales, des modèles de prompts peuvent rappeler d’anonymiser les noms de clients, les budgets, les clauses contractuelles et les autres données confidentielles.
Reste la question des règles internes. Une charte courte bat une interdiction générale que personne ne respecte : elle liste les outils autorisés, les catégories de données confidentielles à ne jamais saisir et la personne à consulter en cas de doute. Ce qu’une charte doit contenir et ce que l’employeur peut encadrer : notre article sur l’usage de l’IA au travail le détaille.
FAQ : IA et données sensibles
Peut-on coller des données confidentielles dans ChatGPT ou Claude gratuit ?
Déconseillé. Sur les comptes personnels, l’entraînement sur vos échanges est activé par défaut chez OpenAI et Mistral. Chez Anthropic, il relève d’un choix de l’utilisateur. Et même si vous le désactivez, vous n’avez ni contrat de traitement des données ni administration centralisée. Ces comptes, gardez-les pour les contenus publics ou fictifs.
Une IA hébergée en Europe suffit-elle pour des données sensibles ?
Non. La localisation aide, c’est vrai. Mais l’entité contractante, les sous-traitants, les accès de support et l’exposition à des lois extraterritoriales comptent tout autant. Pour les besoins les plus stricts, la qualification SecNumCloud apporte une garantie que l’hébergement européen, à lui seul, ne donne pas.
Faut-il une AIPD pour utiliser un assistant IA ?
Pas systématiquement. Elle devient nécessaire quand le traitement de données personnelles présente un risque élevé : données sensibles comme la santé, profilage ou surveillance des salariés, personnes vulnérables ou croisement de fichiers. Qui tranche ? Le responsable du traitement. Il doit recueillir l’avis du DPO (article 35 du RGPD) et décide en s’appuyant sur la liste des traitements pour lesquels la CNIL exige une AIPD.
Quelle est la solution la plus sûre pour des données de santé ?
Ce sont les données sensibles par excellence : il leur faut un environnement maîtrisé. Si un prestataire héberge ces données pour vous, il doit être certifié HDS, le modèle doit tourner dans ce périmètre et une AIPD doit être réalisée en amont. Un assistant grand public, même payant, n’est tout simplement pas conçu pour ce cas.
Conclusion : la bonne IA est celle d’un workflow maîtrisé
Pour concilier IA et données sensibles, l’outil le plus protecteur, c’est celui qui s’insère dans un workflow maîtrisé, avec le bon niveau de service pour le niveau de risque. Avant d’ouvrir un nouveau compte ou de brancher une base documentaire, faites tester un cas réel (mais anonymisé), validez les paramètres d’administration et dites clairement quelles données ne doivent jamais franchir la frontière de votre organisation. Le doute persiste sur des données sensibles ? La règle la plus sûre reste de ne pas les envoyer.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.