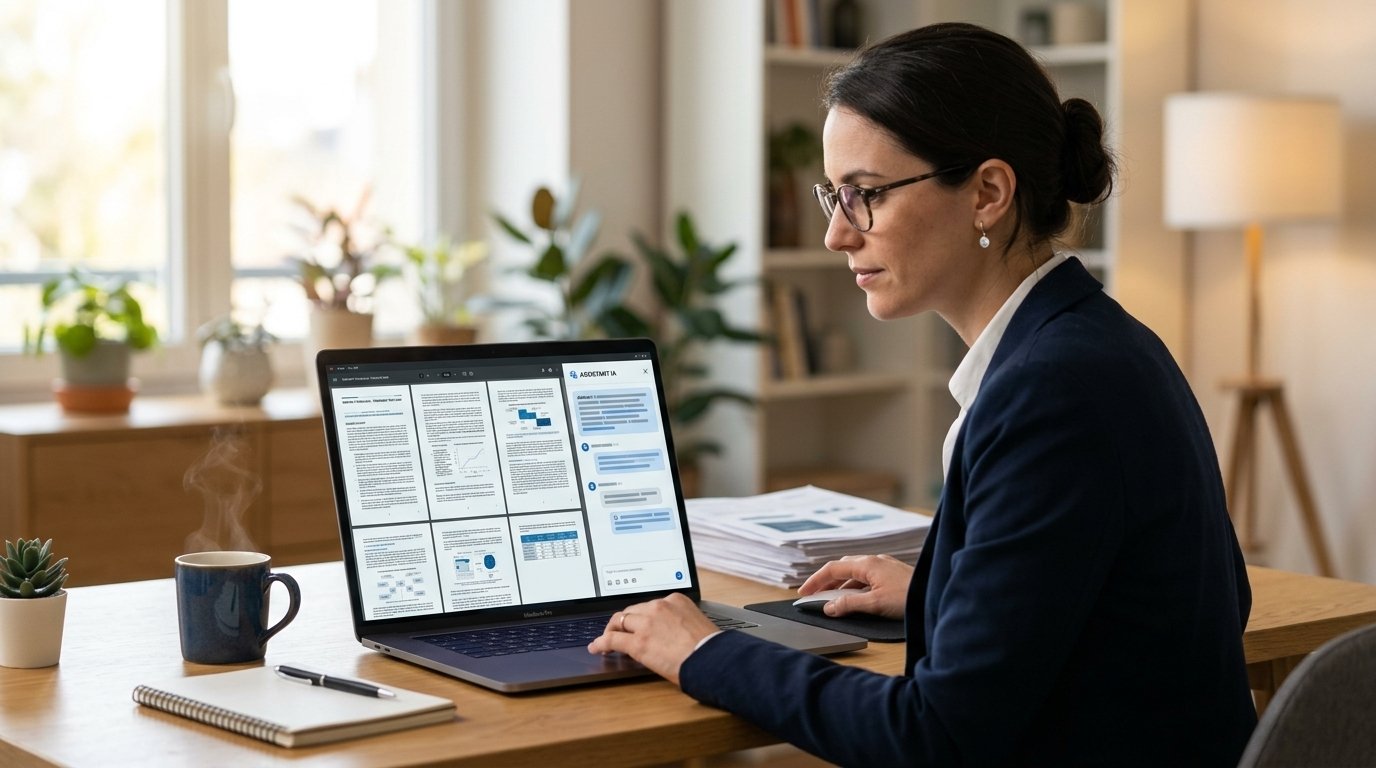
Analyser un PDF avec l’IA bouleverse la manière dont professionnels et particuliers traitent leurs fichiers. Face à l’afflux de documents numériques dans tous les secteurs, savoir extraire efficacement l’information centrale d’un PDF devient essentiel. Les solutions récentes offrent aujourd’hui bien plus que la simple lecture : elles réalisent le résumé de documents, facilitent l’extraction d’informations complexes, automatisent des tâches fastidieuses et ouvrent la voie au chat avec PDF ou à un assistant intelligent PDF capable de dialoguer sur la base du contenu.
Mais comment fonctionne réellement ce traitement automatisé grâce à l’intelligence artificielle ? Dans quels contextes en tirer profit, et quelles précautions adopter concernant la confidentialité des données ? Ce guide donne la méthode en cinq étapes pour analyser un PDF sans se faire raconter d’histoires par la machine.
Prenons le temps de découvrir ces technologies, leurs usages clés et l’impact du cadre réglementaire, notamment le RGPD, sur la gestion de vos fichiers PDF avec l’aide de l’IA.
Pourquoi analyser un PDF avec l’IA change la gestion documentaire
L’émergence de solutions pour analyser un PDF avec l’IA répond à la croissance exponentielle des volumes de documents numériques, aussi bien dans les entreprises qu’auprès du grand public. Rapporter, traiter, organiser ou extraire manuellement du contenu d’un ensemble volumineux de fichiers n’a plus vraiment lieu d’être depuis que des outils intelligents assistent ces manipulations.
Le recours à ces assistants intelligents PDF permet non seulement l’optimisation de documents dans les processus internes, mais aussi une amélioration visible de la collaboration sur PDF entre collègues ou partenaires. Cette automatisation redéfinit la gestion documentaire dans de nombreux secteurs, faisant évoluer l’efficacité, la précision et même la créativité des équipes. Elle s’inscrit dans le mouvement plus large des agents IA et de l’automatisation intelligente qui gagne les entreprises.
- Gain de temps considérable sur la recherche d’informations pertinentes dans un corpus imposant
- Fiabilisation des synthèses et résumés produits automatiquement
- Accélération de la prise de décision grâce à une meilleure compréhension de documents
- Meilleure exploitation pour le traitement de documents volumineux et complexes
Comment fonctionne un outil pour analyser un PDF avec l’IA ?
Les outils capables d’analyser un PDF avec l’IA exploitent différentes techniques issues du machine learning et du traitement automatique du langage naturel (TALN). Leur objectif principal : donner du sens au contenu textuel, parfois enrichi de schémas, tableaux ou images, et offrir à l’utilisateur des fonctionnalités avancées selon ses besoins. Le format PDF est au cœur de ces innovations, car il constitue le standard universel pour l’échange de documents numériques.
Derrière ces solutions opèrent généralement plusieurs étapes : extraction préliminaire du texte depuis le PDF, analyse sémantique des paragraphes, puis génération d’un résumé de documents ou création d’un moteur de questions-réponses sur PDF. Certains outils permettent même de mettre en place un assistant intelligent PDF qui dialogue directement avec l’utilisateur, offrant une interactivité proche d’un chatbot mais spécialisée sur des contenus variés. Les grands modèles généralistes le font nativement : notre comparatif entre Claude et GPT-4o détaille ce que chacun lit dans un document.
Étapes principales du traitement par IA
L’analyse commence souvent par une conversion du contenu PDF en format manipulable, c’est-à-dire un texte brut intégrant preuves, titres, sous-titres, tableaux ou listes. Les étapes suivantes incluent :
- Séparation logique du contenu : repérage des chapitres, auteurs, dates
- Repérage de motifs récurrents ou de mots-clés stratégiques selon la demande
- Extraction d’informations précises : montants, numéros, noms propres ou concepts
- Génération automatisée de synthèses et de rapports ciblés
Grâce à ces mécanismes, il est possible d’automatiser la compréhension de documents même pour des textes complexes, scientifiques ou juridiques.
Personnalisation via questions-réponses et chat avec PDF
Un aspect novateur consiste à poser directement des questions ciblées afin d’obtenir des réponses contextualisées. L’utilisateur formule des requêtes comme « quel est le chiffre d’affaires indiqué en page trois » ou « quels risques figurent dans la section deux ». Le moteur adapte alors sa réponse au vocabulaire et au contexte du document analysé, évitant ainsi un tri manuel chronophage.
La possibilité d’interagir avec un assistant intelligent PDF transforme fondamentalement la relation à la donnée documentaire : chaque utilisateur gagne en autonomie et personnalise son expérience selon ses contraintes métiers ou personnelles. La qualité des réponses dépend directement de la formulation des demandes, et les principes pour rédiger des prompts efficaces s’appliquent mot pour mot.
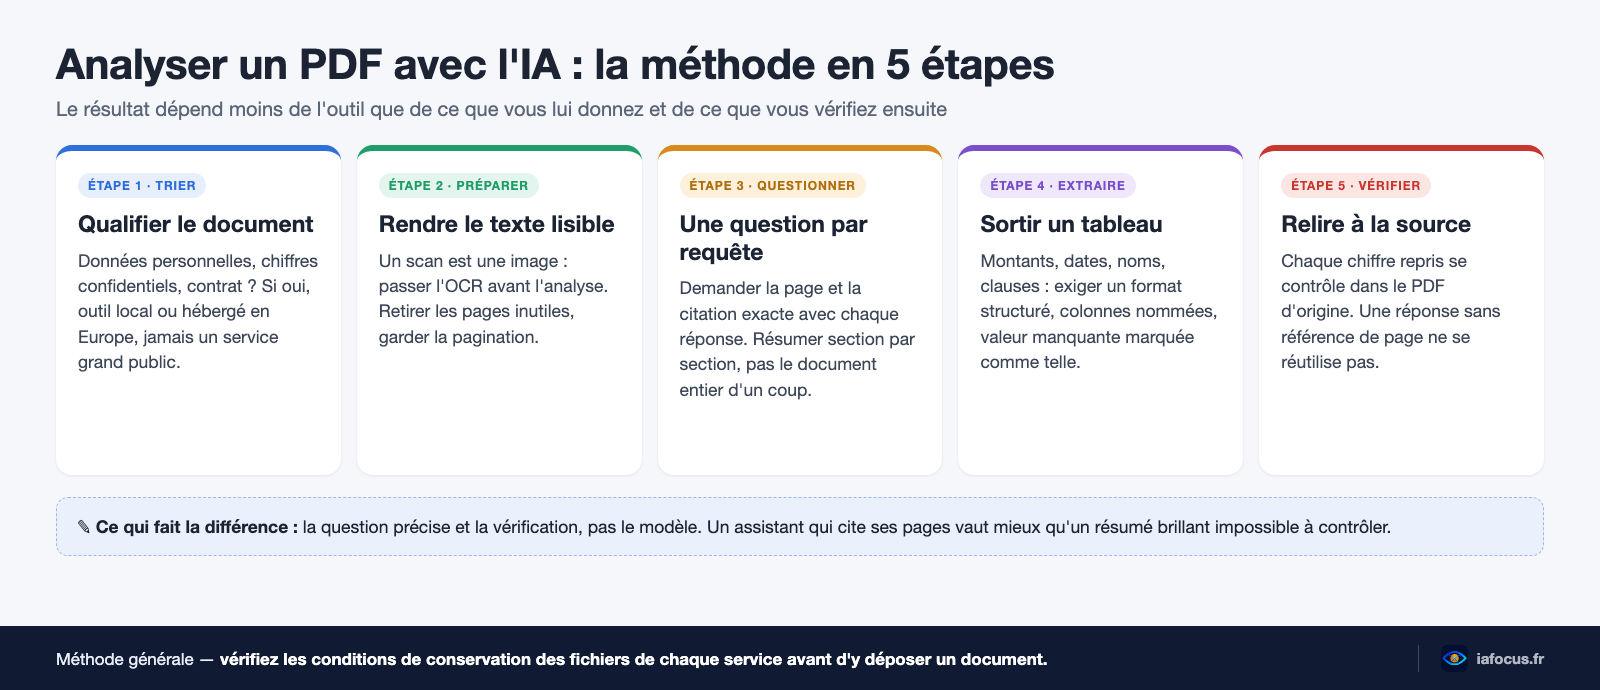
Analyser un PDF avec l’IA : la méthode en cinq étapes
Le résultat dépend moins de l’outil que de ce que vous lui donnez et de ce que vous vérifiez ensuite. Voici la méthode que nous appliquons pour analyser un PDF, quel que soit l’assistant retenu.
Étape 1 : qualifier le document avant de le téléverser
Un rapport public et un contrat de travail ne se traitent pas au même endroit. Si le fichier contient des données personnelles, des chiffres confidentiels ou des clauses sensibles, il relève d’un outil local ou hébergé en Europe, jamais d’un service grand public gratuit. La section RGPD ci-dessous détaille les critères. Pour un document public, en revanche, un chatbot IA gratuit suffit largement : notre comparatif indique lequel lit le mieux les PDF.
Étape 2 : rendre le texte lisible par la machine
Un PDF scanné n’est qu’une image : sans reconnaissance de caractères, l’assistant ne lit rien ou invente. Passez l’OCR en amont, retirez les pages inutiles pour économiser le contexte, et conservez la pagination d’origine, car c’est elle qui permettra de vérifier les réponses.
Étape 3 : poser une question à la fois, en exigeant la page
« Résume ce document » produit un texte lisse et invérifiable. « Quel est le montant total engagé, avec la page et la phrase exacte qui le mentionne » produit une réponse contrôlable. Pour un long rapport, demandez un résumé section par section plutôt qu’un résumé global, puis assemblez. Les réglages de longueur et de format qui rendent une IA pour résumer un texte vraiment utile sont détaillés dans notre guide dédié.
Étape 4 : extraire dans un format structuré
Montants, dates, noms, clauses : demandez un tableau avec des colonnes nommées, et une mention explicite quand une valeur manque. C’est ce format qui rend l’extraction réutilisable dans un tableur ou un logiciel métier, et qui fait apparaître les trous.
Étape 5 : relire chaque chiffre à la source
Les modèles de langage restent capables d’affirmer avec aplomb une donnée absente du document. Tout chiffre repris dans une décision se contrôle dans le PDF d’origine, et une réponse sans référence de page ne se réutilise pas. Cette règle simple élimine la quasi-totalité des erreurs constatées en usage réel.
Pour quels usages l’IA est-elle la plus pertinente ?
De nombreux publics bénéficient déjà concrètement de la possibilité d’analyser un PDF avec l’IA. Les applications dépassent largement la bureautique ou le champ académique ; elles touchent les RH, cabinets juridiques, secteur financier, gestion de projet ou encore veille technique et scientifique.
Une entreprise souhaitant optimiser son traitement de documents volumineux comme factures, contrats ou rapports annuels voit ses délais réduits, tout en améliorant la précision lors de l’extraction d’informations clés. Les chercheurs disposent d’outils capables de générer la synthèse rapide de dizaines d’études PDF en un instant. Les étudiants, quant à eux, utilisent ces technologies pour créer des fiches de révision ou supports de présentation à partir d’un simple glisser-déposer.
Automatisation et optimisation de documents administratifs
L’assistant intelligent PDF adapté aux ressources humaines peut classer, trier, relancer ou attribuer différentes parties d’un dossier : suivi des candidatures, contrôle des pièces jointes, vérification de conformité… Autant de tâches auparavant sources d’erreurs ou chronophages. Pour équiper une équipe, notre guide pour choisir un assistant IA professionnel compare les offres et leurs garanties.
Dans le domaine juridique, la capacité à réaliser une extraction d’informations fiable accélère la recherche de clauses contractuelles ou de jurisprudence. Quant au secteur comptable, il profite d’une analyse ultra-rapide des mouvements financiers listés dans des tableaux complexes intégrés en PDF.
Amélioration de la collaboration sur PDF et partage de connaissances
Au-delà de l’usage individuel, ces plateformes favorisent la collaboration sur PDF. Plusieurs personnes peuvent travailler simultanément sur l’analyse sémantique d’un même rapport, commenter des passages précis ou agréger différents points de vue, toujours pilotés par les capacités cognitives de l’intelligence artificielle.
Cette approche renforce la transmission de savoir puisque chacun bénéficie des apports et annotations partagés, tout en allant droit à l’essentiel grâce aux extraits et résumés générés. Cela optimise la répartition du travail à distance et permet de garder une trace structurée des décisions prises.
RGPD : quelles données peut-on confier à un outil en ligne ?
Confier ses fichiers à un service en ligne pour analyser un PDF implique une vigilance accrue autour de la confidentialité et la protection des données. Le Règlement général sur la protection des données (RGPD) impose aux entreprises comme aux particuliers de respecter certaines règles dès lors qu’ils transmettent des informations sensibles à un service tiers, surtout si celui-ci est accessible en ligne.
Certaines solutions fonctionnent entièrement dans le cloud, ce qui signifie que le fichier PDF envoyé transite vers des serveurs externes, parfois situés hors territoire national. Avant toute utilisation, il est important de vérifier plusieurs éléments essentiels :
- Nature des données contenues dans le PDF : présence éventuelle de données personnelles, financières, médicales, stratégiques…
- Niveau de chiffrement proposé par la plateforme lors du transfert et du stockage
- Garantie d’effacement après traitement, politique de non-conservation des documents
- Déclaration explicite du fournisseur sur la conformité RGPD et la sécurité informatique
Si les fichiers comportent des données sensibles (identités, adresses, numéros bancaires), privilégier des solutions locales ou proposant un mode « on-premise » limite le risque de fuite ou piratage. Un usage responsable commence donc toujours par une analyse précise du type de données déposé sur la plateforme choisie. Les modèles ouverts exécutés sur vos propres machines, présentés dans notre dossier sur les agents IA open source, répondent à ce besoin de contrôle, et l’AI Act ajoute depuis 2026 ses propres obligations de transparence.
Quelles perspectives pour l’intelligence artificielle appliquée aux PDF ?
L’avenir du traitement de documents volumineux par IA promet l’intégration de nouvelles formes de multimodalité : croisement automatique du texte, des images et graphiques présents dans un même PDF. L’assistant intelligent PDF apprend progressivement à reconnaître ce qui est écrit, mais aussi l’ensemble du contexte visuel et sémantique.
À moyen terme, la question de la transparence algorithmique et du respect total des droits sur la donnée occupera le centre des débats. Tirer parti de cette puissance technologique exige un équilibre entre efficacité dans l’extraction d’informations et responsabilité dans la maîtrise du cycle de vie des documents.
| Fonctionnalité | Bénéfices |
|---|---|
| Résumé automatique de documents | Lecture accélérée, gain de productivité et meilleure vue d’ensemble |
| Questions-réponses sur PDF | Recherche personnalisée, interaction dynamique, pertinence renforcée |
| Extraction d’informations ciblées | Fiabilité accrue dans la récupération de données clés |
| Collaboration sur PDF | Centralisation, annotation partagée, transparence et traçabilité |
| Optimisation de documents volumineux | Gestion efficace de gros volumes, réduction des erreurs liées au traitement manuel |
Savoir analyser un PDF avec l’IA revient aujourd’hui à ouvrir la porte à une bibliothèque immense où chaque livre s’ouvre instantanément à la page la plus importante. Prendre le temps de se former, comparer les plateformes et anticiper les obligations légales constitue le trio gagnant pour profiter durablement de l’intelligence artificielle au service du PDF.
FAQ
Quel outil choisir pour analyser un PDF avec l’IA ?
Les assistants généralistes comme ChatGPT, Claude ou NotebookLM acceptent un PDF en pièce jointe et répondent à des questions dessus. Les services spécialisés ajoutent le surlignage des passages cités et la gestion de bibliothèques entières. Le bon choix dépend d’abord de la sensibilité du document, puis du volume à traiter.
L’IA peut-elle se tromper en résumant un PDF ?
Oui, et sans prévenir. Elle peut omettre une réserve importante, mélanger deux tableaux ou attribuer un chiffre à la mauvaise année. C’est pourquoi la méthode impose de demander la page source avec chaque réponse et de relire à la source tout ce qui sert à décider.
Comment analyser un PDF scanné ou une photo de document ?
Il faut d’abord une reconnaissance de caractères. Certains assistants l’intègrent, d’autres attendent un texte déjà extrait. Contrôlez le résultat sur les tableaux et les chiffres, où l’OCR commet le plus d’erreurs, avant de lancer l’analyse.
Peut-on analyser un PDF confidentiel avec un outil en ligne ?
Seulement si le fournisseur s’engage contractuellement sur l’hébergement, la durée de conservation et l’absence d’entraînement sur vos fichiers, et si les personnes concernées en sont informées. À défaut, un modèle exécuté localement reste la seule option conforme.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.