Un collaborateur colle un compte rendu client dans un chatbot pour en extraire les actions à mener. Un designer importe une maquette non publiée dans un générateur d’images. Un développeur demande à un assistant de corriger un extrait de code contenant une clé d’API. Ces gestes font gagner du temps, mais ils posent la même question : comment sécuriser ses données dans les outils IA sans bloquer les usages qui créent réellement de la valeur ?
La réponse ne tient ni dans une interdiction générale ni dans une case à cocher. Elle dépend du type de données envoyé, de l’offre souscrite, des réglages activés et des règles appliquées par les équipes. Pour une PME comme pour une direction marketing ou produit, l’objectif est de construire un workflow IA utile, mais maîtrisé.
Sécuriser ses données : pourquoi les prompts sont devenus un sujet de sécurité
Dans un outil d’IA générative, la donnée ne se limite pas au fichier joint. Elle peut apparaître dans le prompt, l’historique de conversation, une instruction système, une capture d’écran ou les métadonnées d’un document. Une demande anodine peut révéler un nom de client, un tarif, une stratégie de lancement, des données RH ou des éléments de propriété intellectuelle.
Le risque varie selon le service. Un outil grand public gratuit, un abonnement individuel, une offre professionnelle et un environnement déployé sur une infrastructure cloud dédiée n’offrent pas les mêmes garanties. Certains fournisseurs précisent que les contenus des offres entreprise ne servent pas à entraîner leurs modèles par défaut. D’autres conservent temporairement les journaux pour la sécurité ou le diagnostic. La nuance est essentielle : « non utilisé pour l’entraînement » ne signifie pas automatiquement « jamais conservé » ni « inaccessible dans aucun cadre ».
Il faut aussi distinguer la confidentialité de la sécurité d’accès. Une plateforme peut protéger les données en transit et au repos, tout en laissant un espace partagé trop largement ouvert à tous les membres d’une organisation. À l’inverse, un compte personnel très bien protégé ne règle pas la question contractuelle liée à l’usage de contenus clients.
Sécuriser ses données commence par les cartographier
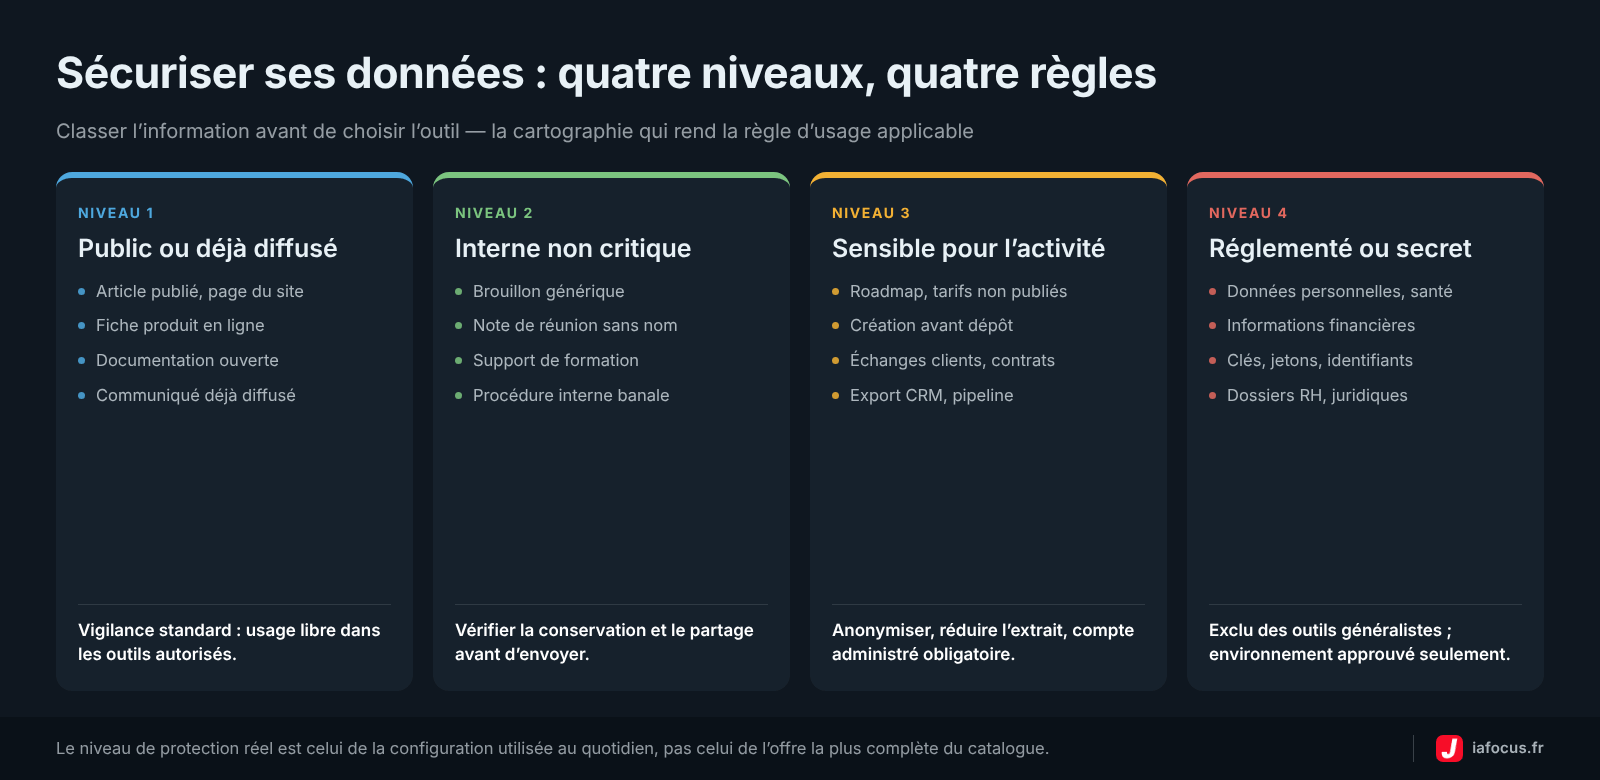
Avant de choisir un modèle ou de rédiger une charte, classez les informations manipulées. Cette étape évite les règles vagues du type « ne mettez pas de données sensibles », difficiles à appliquer quand personne ne sait précisément ce que recouvre le terme — la question de savoir quelle IA protège les données sensibles se pose d’ailleurs avant celle du choix d’un abonnement.
Les données publiques ou déjà validées pour diffusion – un article publié, une fiche produit visible, une documentation open source – peuvent généralement être utilisées avec un niveau de vigilance standard. Les données internes non critiques, comme un brouillon de présentation générique, exigent déjà de vérifier les paramètres de conservation et de partage.
Le traitement devient plus sensible pour les informations commerciales non publiées, les roadmaps produit, les créations avant dépôt, les sources propriétaires, les contrats ou les échanges avec des clients. Enfin, les données personnelles, les données de santé, les informations financières, les secrets d’affaires et les identifiants techniques doivent faire l’objet de règles spécifiques, voire être exclus des outils IA généralistes.
Sécuriser ses données suppose enfin d’adapter cette cartographie aux métiers. Un rédacteur n’expose pas les mêmes éléments qu’un analyste data, un cabinet de recrutement ou une équipe de développement. Pour un marketeur, le danger peut être l’import d’un export CRM. Pour un développeur, ce sera un fichier de configuration, un jeton d’accès ou du code lié à un produit non annoncé.
Minimiser avant d’envoyer
Pour protéger ses données, la mesure la plus efficace est souvent la plus simple : ne transmettre que le contexte nécessaire. Remplacez les noms par des variables, retirez les coordonnées, réduisez les extraits de documents et supprimez les identifiants. Demander à un assistant de reformuler « le client A » suffit souvent, sans fournir le nom réel, le chiffre d’affaires et le contenu intégral des échanges.
L’anonymisation n’est cependant pas magique. Une combinaison de fonction, de date, de secteur et de détail géographique peut permettre de réidentifier une personne ou une entreprise. Lorsqu’un dossier est particulièrement sensible, préférez un jeu de données synthétique, un extrait très réduit ou un environnement approuvé par l’organisation.
Sécuriser ses données selon le type d’outil
La même question — que devient ce que j’écris ? — n’appelle pas la même réponse selon l’endroit où le prompt arrive. Quatre configurations coexistent dans la plupart des organisations, et elles n’offrent ni les mêmes garanties ni les mêmes réglages.
Le compte gratuit grand public est le plus exposé : l’historique est conservé par défaut, il sert souvent à améliorer le service, et aucune administration ne permet de savoir qui l’utilise dans l’entreprise. L’abonnement individuel payant ouvre des options de désactivation plus fines, mais le compte reste personnel : au départ du salarié, ni les conversations ni les fichiers ne reviennent à l’organisation.
L’offre équipe ou entreprise change la nature du problème. Le contrat encadre l’usage des contenus, l’authentification unique et la gestion des membres deviennent possibles, la durée de conservation se paramètre. L’API et les modèles auto-hébergés vont plus loin : la donnée ne transite que par votre code, mais la responsabilité se déplace vers vos propres journaux, vos sauvegardes et votre hébergement.
| Configuration | Ce qui part | Conservation | Réglage décisif |
|---|---|---|---|
| Chatbot gratuit | Prompt, pièces jointes, historique | Longue par défaut | Désactiver historique et amélioration du service |
| Abonnement individuel | Idem, sur un compte personnel | Paramétrable | Rattacher l’usage à un compte administré |
| Offre équipe ou entreprise | Prompts et documents connectés | Contractuelle, souvent réglable | Authentification unique, périmètre des connecteurs |
| API ou modèle auto-hébergé | Ce que votre code envoie | Vos propres journaux | Purge des journaux applicatifs |
Cette grille évite l’erreur la plus courante : croire qu’un fournisseur réputé dispense de sécuriser ses données côté usage. Le niveau de protection réel est celui de la configuration employée au quotidien par les équipes, pas celui de l’offre la plus complète du catalogue.
Elle sert aussi d’argument budgétaire. Passer d’un usage dispersé sur des comptes gratuits à une offre administrée coûte quelques euros par personne et par mois ; reconstituer un incident sur des comptes personnels, retrouver qui a partagé quoi et prévenir un client coûte bien davantage, en temps comme en confiance.
Sécuriser ses données avec les bons réglages
Sécuriser ses données passe d’abord par un compte professionnel administré, et non une adresse personnelle dispersée entre plusieurs services. L’entreprise doit pouvoir gérer les membres, retirer les accès au départ d’un salarié et connaître les espaces où circulent les documents.
Activez l’authentification multifacteur, idéalement avec une application d’authentification ou une clé matérielle. Vérifiez aussi le mode de connexion disponible : l’authentification unique via le fournisseur d’identité de l’entreprise facilite le contrôle des accès et limite les mots de passe réutilisés.
Les paramètres de partage méritent une revue régulière : c’est là que se perd le bénéfice des réglages précédents. Dans un espace collaboratif, un lien ouvert, un GPT personnalisé, un agent ou un projet partagé peut exposer des conversations et des fichiers à un périmètre plus large que prévu. Les droits doivent respecter le principe du moindre privilège : un prestataire n’a pas besoin d’accéder aux mêmes espaces qu’une équipe produit, et un stagiaire n’a pas à administrer les connecteurs.
Pour les outils qui proposent des connecteurs vers la messagerie, le stockage documentaire, le CRM ou les dépôts de code, examinez les autorisations une par une. Un agent IA capable de rechercher des documents internes est utile, mais il faut savoir quels dossiers il indexe, qui peut l’interroger et s’il peut agir, par exemple créer un ticket ou envoyer un message. La lecture et l’exécution ne présentent pas le même niveau de risque.
Sécuriser ses données côté fournisseur : au-delà de la promesse marketing
Avant un déploiement, sécuriser ses données suppose de lire les conditions applicables à l’offre exacte envisagée, pas seulement la page d’accueil du fournisseur. Cherchez notamment la finalité des données, leur durée de conservation, les sous-traitants, les lieux d’hébergement, les mécanismes de suppression et les modalités d’export.
Pour les organisations soumises au RGPD, le sujet ne se résume pas à la localisation des serveurs. Il faut clarifier les rôles respectifs, le traitement des données personnelles, les transferts éventuels hors de l’Espace économique européen et les mesures contractuelles prévues. Le délégué à la protection des données, la DSI et les équipes métiers doivent se parler tôt : attendre qu’un workflow soit devenu indispensable rend les arbitrages plus coûteux.
Les certifications et rapports d’audit peuvent éclairer la maturité d’un fournisseur, sans remplacer l’analyse de votre cas d’usage. Une grande plateforme bien sécurisée ne compense pas un prompt contenant une liste de patients ou une clé de production. À l’inverse, une équipe peut accepter un niveau de risque raisonnable pour générer des variantes de titres à partir de contenus publics.
Sécuriser ses données par une règle d’usage qui ne finit pas dans un tiroir
Une charte qui aide vraiment à sécuriser ses données tient sur quelques principes concrets. Elle indique quels outils sont autorisés, quelles catégories de données sont interdites, quand anonymiser, qui contacter en cas de doute et comment signaler un incident. Elle doit aussi préciser le cas des comptes gratuits : ils sont souvent utilisés dans l’urgence, en dehors du cadre validé.
Accompagnez cette règle d’exemples proches du terrain. « Ne copiez pas un export CRM » est plus utile que « protégez les informations confidentielles ». « Retirez les noms, adresses et numéros de dossier avant de résumer un entretien » donne immédiatement un geste à appliquer. Les équipes éditoriales peuvent conserver une bibliothèque de prompts avec des variables comme [CLIENT], [PRODUIT] ou [DATE], plutôt que de coller les données brutes à chaque demande.
Sécuriser ses données oblige aussi à regarder les sorties du modèle, pas seulement les entrées. Une IA peut inventer une référence, reproduire un ton inadapté ou révéler dans sa réponse des éléments présents dans le contexte fourni. Toute production destinée à un client, à une publication ou à une décision opérationnelle nécessite donc une relecture humaine et, selon le sujet, une validation métier ou juridique.
Sécuriser ses données après l’incident : préparer la réponse
Même avec de bons réglages, sécuriser ses données n’élimine pas l’erreur de manipulation. Un collaborateur peut envoyer le mauvais fichier, partager un lien publiquement ou connecter un agent à une source non prévue. La rapidité de réaction compte : conservez un canal clair pour signaler l’incident sans crainte de sanction automatique.
L’équipe concernée doit pouvoir identifier l’outil, le compte, les données impliquées, la date, les destinataires éventuels et les actions déjà réalisées. Selon le service, il peut être possible de supprimer une conversation, révoquer un lien, désactiver un connecteur ou retirer une autorisation. Documenter ces procédures avant l’incident évite de chercher les réglages au moment où chaque minute compte.
Quatre semaines pour sécuriser ses données sans bloquer les équipes
Un plan court vaut mieux qu’un chantier annuel jamais terminé. Le découpage ci-dessous tient dans un mois et n’exige ni budget ni outil supplémentaire.
Semaine 1, observer. Recensez les outils réellement utilisés, y compris ceux que personne n’a déclarés. Un questionnaire anonyme donne une image plus juste que la liste des licences payées. Notez pour chaque outil qui s’en sert, sur quel type de contenu et avec quel compte.
Semaine 2, réduire l’exposition. Basculez les usages professionnels vers des comptes administrés, activez l’authentification multifacteur, désactivez l’entraînement et l’historique là où c’est possible, puis passez en revue les liens de partage ouverts et les connecteurs installés. C’est la semaine qui permet de protéger ses données le plus vite, pour un effort modeste.
Semaine 3, écrire la règle. Une page suffit : outils autorisés, catégories de données interdites, gestes d’anonymisation, contact en cas de doute. Ajoutez trois exemples tirés du métier de vos équipes. Cette page n’a de sens que reliée à une gouvernance des données plus large, qui dit qui décide et qui arbitre.
Semaine 4, répéter l’incident. Simulez une erreur : un export client collé dans un chatbot public. Qui prévient-on, où se supprime la conversation, comment révoque-t-on le lien, que note-t-on dans le registre ? Une répétition d’une heure révèle les réglages introuvables bien mieux qu’une procédure écrite.
À l’issue de ce mois, sécuriser ses données cesse d’être un principe pour devenir une habitude mesurable : nombre de comptes administrés, part des outils couverts par la règle, délai de réaction constaté pendant l’exercice. Ces trois chiffres suffisent à montrer une progression à une direction, et à décider si l’effort suivant porte sur les connecteurs, sur la formation ou sur le contrat.
FAQ : sécuriser ses données dans les outils IA
Peut-on sécuriser ses données avec un compte gratuit ?
Partiellement. Désactiver l’historique et l’amélioration du service réduit l’exposition, mais l’organisation ne garde aucune visibilité sur l’usage et ne récupère rien au départ du salarié. Le compte gratuit convient aux contenus déjà publics ; dès qu’un document interne entre en jeu, un compte administré s’impose.
Faut-il interdire les outils IA pour sécuriser ses données ?
L’interdiction générale produit l’effet inverse : les équipes basculent sur leurs comptes personnels, hors de toute visibilité. Mieux vaut autoriser un nombre restreint d’outils, dire clairement ce qui ne doit jamais y entrer et fournir une alternative pour les cas sensibles.
Une donnée confidentielle a déjà été envoyée : que faire ?
Supprimez la conversation et les fichiers associés, révoquez les liens de partage, puis vérifiez les réglages de conservation du service. Notez l’incident, sa date et les personnes concernées : selon la nature des informations, une notification peut être requise. C’est exactement le scénario que l’exercice de la quatrième semaine sert à répéter.
Sécuriser ses données n’est pas un frein à la productivité. C’est ce qui permet d’intégrer les modèles dans les workflows de rédaction, d’analyse, de développement ou de création avec assez de confiance pour aller au-delà du simple test. Le meilleur prochain pas consiste à prendre un outil déjà utilisé par votre équipe, examiner les données qui y entrent réellement, puis corriger un réglage ou une habitude dès cette semaine.
Sources
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.