Faire tourner une IA en local, c’est-à-dire sur votre propre Mac ou PC, sans envoyer une ligne de texte à un serveur distant, n’a plus rien d’un passe-temps de développeur. Les logiciels se sont simplifiés, les modèles ouverts se sont multipliés, et les constructeurs vantent désormais leurs machines pour cet usage. Reste à savoir par où commencer, avec quel matériel, et ce que vous y gagnez vraiment.
Ce guide fait le point en octobre 2026 : la mémoire nécessaire, les deux ou trois logiciels qui suffisent, les familles de modèles à essayer, et ce que le local change (ou pas) pour la confidentialité des données au regard du RGPD.
Pourquoi passer à l’IA en local
La première raison est simple : vos requêtes restent chez vous. Un contrat confidentiel, un tableau de paie, un brouillon sous embargo, rien de tout cela ne quitte le disque. Le journaliste Antonio G. Di Benedetto le résume bien dans un carnet de tests publié par The Verge le 11 octobre 2026 : certaines tâches, il ne les aurait jamais confiées à un service en ligne, et c’est le local qui a fait la différence entre utiliser l’outil ou non.
Deuxième raison, le coût. Une fois la machine achetée, chaque requête est gratuite : pas d’abonnement, pas de facturation au jeton. Troisième raison, l’autonomie. Un modèle local fonctionne dans le train, en zone blanche, ou le jour où le service américain que vous utilisez change ses conditions. Et il ne disparaît pas du catalogue du jour au lendemain. Le lieu de traitement pèse aussi dans le débat sur les modèles chinois : voyez pourquoi l’on trouve DeepSeek interdit dans l’administration américaine, et ce qu’il en est en France.
Mais soyons clairs : vous n’aurez pas l’équivalent du meilleur modèle du moment sur un ordinateur portable. Le débat entre modèles ouverts et propriétaires ne se tranche pas d’un mot. Le local est un compromis, souvent excellent, parfois frustrant.
Le matériel : la mémoire décide de tout
Oubliez la fréquence du processeur. Pour un modèle local, la question est : le fichier du modèle tient-il en mémoire, avec un peu de marge pour la conversation ? Sinon, il ne se charge pas, ou il rame au point d’être inutilisable.
Sur Mac, la puce Apple partage une mémoire unifiée entre processeur et carte graphique, ce qui rend toute la RAM disponible pour le modèle. D’où l’argument d’Apple. Le Mac Studio actuel démarre à 36 Go avec la puce M5 Max, et la version M5 Ultra part de 96 Go, configurable jusqu’à 512 Go, selon la fiche technique d’Apple. La bande passante mémoire annoncée atteint 1,2 To/s sur l’Ultra, un chiffre qui compte autant que la capacité pour la vitesse de réponse.
Sur PC, c’est surtout la mémoire de la carte graphique (la VRAM) qui fait foi. Un modèle qui déborde de la carte graphique peut basculer en partie sur la RAM classique, mais la vitesse s’effondre. Franchement, si vous achetez une machine pour l’IA en local, regardez d’abord ce chiffre-là.
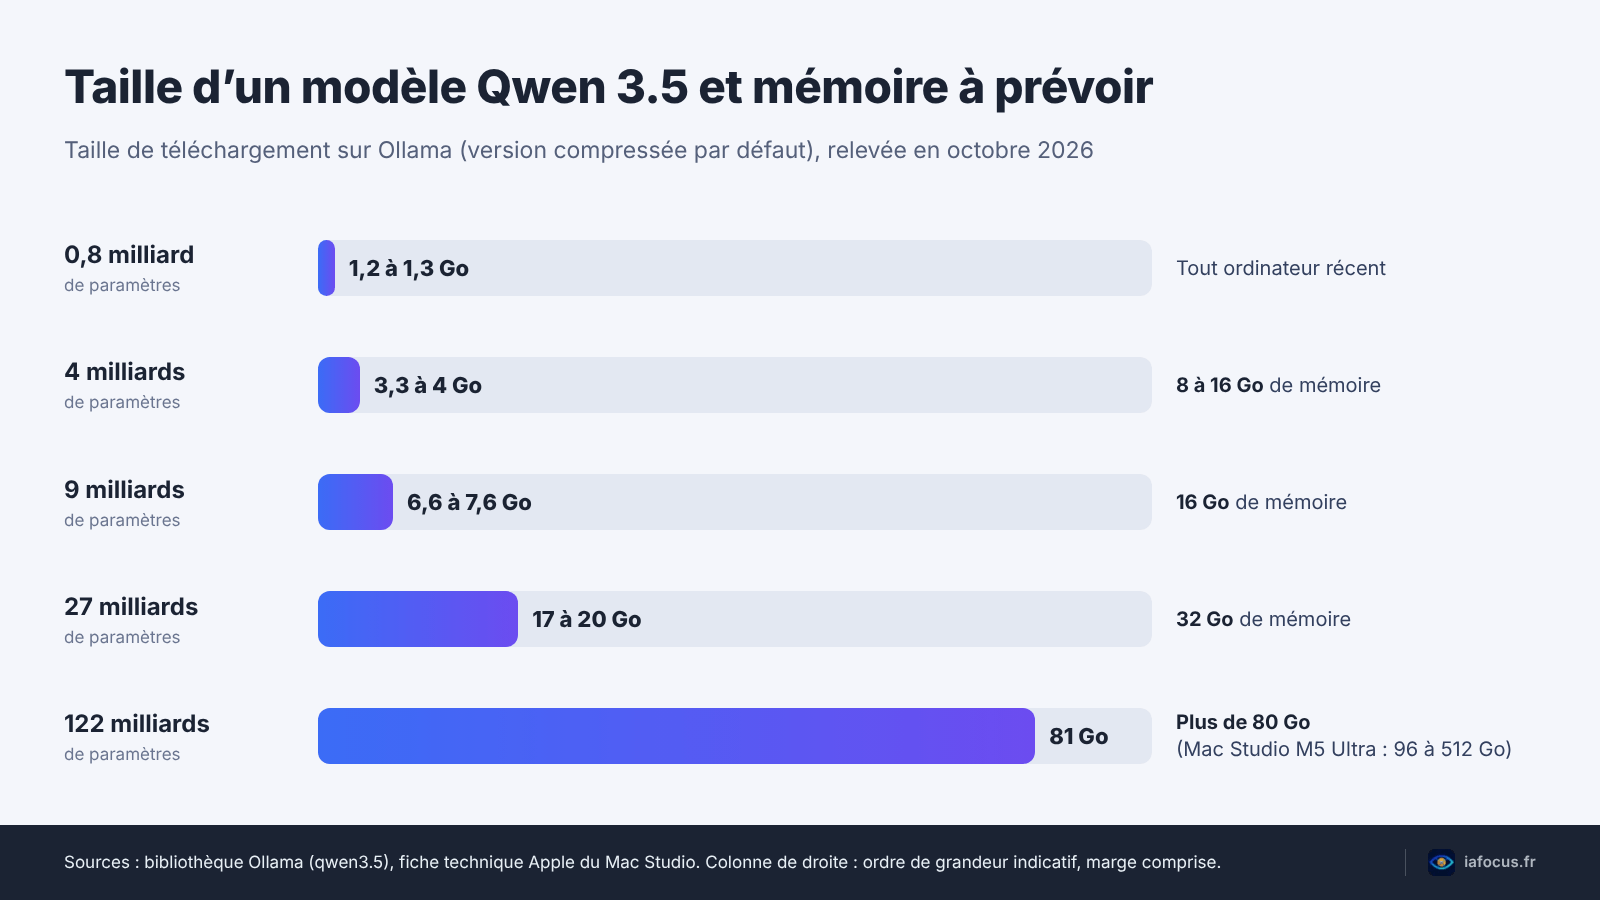
Pour fixer les idées, voici les tailles de téléchargement relevées sur la bibliothèque d’Ollama pour la famille Qwen 3.5 (versions compressées par défaut) :
- 0,8 milliard de paramètres : 1,2 à 1,3 Go ;
- 4 milliards : 3,3 à 4 Go ;
- 9 milliards : 6,6 à 7,6 Go ;
- 27 milliards : 17 à 20 Go ;
- 122 milliards : 81 Go.
En clair, avec 16 Go de mémoire, vous visez les modèles de 4 à 9 milliards de paramètres. À 32 Go, la catégorie des 27 milliards devient jouable. Au-delà de 80 Go, on entre dans la cour des grands modèles. Le testeur de The Verge, lui, a chargé un modèle Qwen d’environ 105 Go sur un Mac Studio doté de 256 Go : un cas d’école, pas un point de départ.
Les logiciels pour installer un modèle local
Deux outils couvrent l’essentiel des besoins, et ils sont gratuits tant que le modèle local tourne sur votre machine.
Ollama est le plus répandu. Son code est publié sur GitHub, il s’installe sur macOS, Windows et Linux, et une seule commande télécharge puis lance un modèle (par exemple ollama run gemma4). Il sert aussi de moteur à de nombreuses interfaces graphiques et à des agents. Attention à un détail : Ollama propose désormais des modèles « cloud » à côté des modèles locaux. Ceux-là tournent sur ses serveurs. Vérifiez donc le nom exact de ce que vous lancez.
LM Studio mise sur l’interface. Vous cherchez un modèle, vous cliquez, vous discutez. Son offre gratuite, d’après sa page de tarifs, comprend l’exécution de modèles locaux par les moteurs llama.cpp et MLX (ce dernier optimisé pour les puces Apple) et une transcription vocale hors ligne. Les formules payantes ajoutent des modèles hébergés aux États-Unis : là encore, ce n’est plus du local.
Pour les plus techniques, llama.cpp reste la brique de base sur laquelle s’appuient beaucoup d’outils. Utile si vous voulez tout régler à la main. Pas indispensable pour commencer.
Quels modèles ouverts choisir : Qwen en local, Gemma, Mistral
Le choix est vertigineux, et c’est le vrai piège du débutant. Le journaliste de The Verge l’avoue d’ailleurs : il y a plus de modèles qu’il ne peut en compter. Trois familles suffisent pour démarrer.
Qwen, développé par Alibaba Cloud, est devenu la référence des usages locaux. La génération Qwen 3.5 va de 0,8 à 122 milliards de paramètres, accepte texte et images, et ses versions publiées sur Hugging Face sont sous licence Apache 2.0, qui autorise l’usage commercial. Installer Qwen en local, c’est aujourd’hui le choix par défaut de beaucoup de guides, et pour cause : il existe une taille pour chaque machine. Avec un bémol : un modèle chinois répond parfois de façon orientée sur certains sujets politiques. Pour résumer un PDF, cela ne change rien.
Gemma 4, de Google, se décline de petites versions pour portable jusqu’à 31 milliards de paramètres dans la bibliothèque d’Ollama. Bon compromis sur les machines modestes.
Mistral AI, l’acteur français, publie plusieurs modèles sous licence Apache 2.0 selon sa documentation officielle : la série Ministral 3 en 3, 8 et 14 milliards de paramètres, et Mistral Small 4. Pour un usage en français, l’option mérite le détour, et elle pèse dans la balance si la rivalité entre Mistral AI et OpenAI vous intéresse sous l’angle de la souveraineté.
Notre conseil ? Commencez petit, avec un seul modèle local. Un modèle de 4 à 9 milliards de paramètres répond vite, vous permet de juger l’intérêt de la démarche, et vous montera assez tôt ses limites. Vous monterez ensuite en taille si votre machine suit. Pour suivre les sorties, notre sélection des nouveaux modèles d’IA à suivre en 2026 est mise à jour régulièrement.
Premiers pas avec une IA en local : la méthode en cinq étapes
Concrètement, une demi-heure suffit pour avoir un premier modèle qui répond.
- Vérifiez la mémoire de votre machine (sur Mac : menu Pomme, « À propos de ce Mac » ; sur PC : la VRAM de la carte graphique dans le gestionnaire des tâches).
- Installez Ollama ou LM Studio depuis leur site officiel, jamais depuis un miroir douteux.
- Téléchargez un modèle adapté à votre mémoire, par exemple un Qwen 3.5 de 4 ou 9 milliards de paramètres : c’est la façon la plus simple d’essayer Qwen en local.
- Coupez le Wi-Fi et posez une question : si le modèle répond, il tourne bien chez vous.
- Testez-le sur vos vraies tâches (résumé, reformulation, tri d’e-mails) avant d’aller plus loin.
L’étape 4 a l’air anecdotique. Elle ne l’est pas : c’est la seule façon simple de vous assurer qu’aucun appel ne part vers un serveur.
Et ensuite ? Les agents, ces programmes qui agissent sur votre ordinateur à votre place, fonctionnent aussi avec un modèle local. Le testeur de The Verge a ainsi fait trier une bibliothèque de plus de 400 jeux. Mais il a dû fournir une clé d’accès à un service tiers, qu’il a révoquée ensuite. Bonne pratique. Pour aller plus loin, notre article sur les agents IA open source détaille les solutions qui gardent le contrôle chez vous.
À quoi sert un modèle local au quotidien ? Aux tâches répétitives et privées, surtout. Résumer un compte rendu de réunion, reformuler un courrier délicat, extraire les dates d’un contrat, classer une pile de notes, traduire un document interne : autant d’usages où la confidentialité des données compte plus que la virtuosité du modèle.
Les petits modèles s’en sortent très bien sur ce terrain. Là où ils peinent, c’est sur les questions d’actualité (ils ne savent que ce qu’ils ont appris, sans accès au web par défaut) et sur les raisonnements longs. Gardez donc un service en ligne pour ces cas-là, et réservez l’IA en local à ce qui ne doit pas sortir de votre bureau. Ce partage des rôles, simple à tenir, évite la déception des premiers jours.
Confidentialité des données : ce que le local change, et ce qu’il ne change pas
La confidentialité des données est l’argument numéro un, et il est solide. Avec une IA en local, les données ne sont pas transmises à un fournisseur, donc pas de question de sous-traitant, pas de transfert hors de l’Union européenne au sens du chapitre V du RGPD, pas de risque que vos prompts servent à entraîner un modèle tiers. Pour un cabinet, une PME ou un indépendant qui manipule des dossiers clients, c’est un gain net en confidentialité des données.
Mais le RGPD ne s’arrête pas à la porte de votre bureau. Traiter des données personnelles sur votre propre machine reste un traitement au sens de l’article 4 du règlement. Les obligations de base demeurent : finalité définie, données limitées au nécessaire, sécurité du poste. Un ordinateur portable non chiffré, volé dans un train, avec l’historique des conversations sur le disque, c’est une violation de données comme une autre. La CNIL publie des fiches pratiques sur l’IA qui aident à cadrer ces usages, et notre guide sur l’IA et les données sensibles liste ce qu’il vaut mieux ne jamais confier à un outil, local ou non.
Côté sécurité, l’ANSSI a publié des recommandations pour les systèmes d’IA générative. Elles visent d’abord les organisations, mais deux réflexes valent pour tous : télécharger les modèles depuis des sources identifiées, et limiter les droits accordés à un agent. Nos conseils pour sécuriser ses données dans les outils d’IA complètent la liste.
Un mot enfin sur l’AI Act : utiliser un modèle ouvert chez soi ne dispense pas une entreprise de ses éventuelles obligations de déployeur, selon l’usage qu’elle en fait. Notre point sur l’AI Act pour les entreprises fait le tri.
Les limites à connaître avant d’acheter
L’IA en local a ses angles morts. Un modèle de 9 milliards de paramètres se trompe plus souvent qu’un grand modèle en ligne, invente plus volontiers des références, et raisonne moins loin. Il faut vérifier ses réponses. Toujours.
La vitesse ensuite. Sur une machine modeste, un gros modèle peut produire ses réponses au rythme d’une lecture lente. Supportable pour un résumé, pénible pour une longue conversation.
Le prix, aussi. Le Mac Studio du test de The Verge coûte environ 12 000 dollars, selon le journaliste lui-même, qui admet qu’il n’en faut pas autant pour ses premiers usages. Acheter 128 Go de mémoire « au cas où » est rarement une bonne idée : testez d’abord sur votre machine actuelle.
Et puis la maintenance. Les tâches automatiques cassent, les mises à jour changent les réglages, et l’ordinateur doit être allumé (et réveillé) pour qu’un agent fasse son travail. Le testeur l’a appris à ses dépens avec un briefing matinal qui échouait parce que le Mac dormait. Rien de grave, mais une IA en local reste un logiciel à entretenir, pas un assistant magique.
Foire aux questions
Faut-il une carte graphique puissante pour une IA en local ?
Pas pour débuter un modèle local. Un Mac à puce Apple avec 16 Go de mémoire unifiée fait tourner des modèles de 4 à 9 milliards de paramètres. Sur PC, une carte graphique avec 8 Go de VRAM ou plus rend l’expérience nettement plus fluide, mais un petit modèle fonctionne aussi sur le processeur, plus lentement.
Une IA en local est-elle vraiment hors ligne ?
Oui, une fois le modèle téléchargé, s’il s’agit bien d’un modèle local. Ollama et LM Studio proposent aussi des modèles hébergés : vérifiez ce que vous lancez. Le test le plus simple consiste à couper la connexion et à poser une question.
Le RGPD s’applique-t-il à un modèle local ?
Oui, dès que vous traitez des données personnelles. Le local supprime le transfert vers un fournisseur, mais les principes de finalité, de minimisation et de sécurité restent valables. Chiffrez le disque et effacez les historiques inutiles.
Quel modèle choisir pour écrire en français ?
Les modèles Qwen 3.5 et Gemma 4 se débrouillent bien en français. Les modèles de Mistral AI, conçus par une équipe française et sous licence Apache 2.0 pour plusieurs d’entre eux, sont une bonne option à comparer sur vos propres textes.
Sources
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.