Claude Haiku 5.5 coûte 0,10 dollar le million de tokens en entrée. Dix fois moins que son prédécesseur, sur le papier. Anthropic l’a lancé le 7 octobre 2026 en annonçant pourtant une facture « environ 75 % » plus basse en moyenne, pas 90 %. L’écart tient à une ligne discrète de la documentation, sur la façon dont le modèle découpe le texte. Voici le calcul, puis ce que ce petit modèle sait faire (piloter un ordinateur, surtout) et pour qui il vaut le coup.
Claude Haiku 5.5, qu’est-ce que c’est exactement ?
C’est le plus petit des trois modèles de la gamme 5.5 d’Anthropic, sous Sonnet 5.5 et Opus 5.5. Sa page d’annonce le présente comme le petit modèle le moins cher, le plus rapide et le plus capable de la maison. Rapide, c’est vérifiable : Claude Haiku 5.5 devient le modèle Anthropic le plus véloce à vitesse standard (les Opus en mode Fast vont plus vite, précise une note). Moins cher, on y vient. Les petits modèles posent aussi une question de sécurité, illustrée par une expérience de l’équipe rouge d’Anthropic sur des box Android.
Sur la fiche technique, trois changements sautent aux yeux. Le contexte passe à 1 million de tokens (200 000 pour Haiku 4.5) et la sortie maximale à 128 000 tokens au lieu de 64 000. C’est aussi le premier Haiku doté d’un réglage d’effort, réglé sur « medium » par défaut. Enfin, la réflexion adaptative est active d’office : Claude Haiku 5.5 décide seul quand il pense, et combien. Retenez ce détail. Il pèse sur la facture.
Le modèle est accessible dans l’application Claude pour toutes les formules, gratuite comprise, dans Claude Code, sur l’API (identifiant claude-haiku-5-5) et chez Amazon Bedrock, Google Cloud et Microsoft Foundry, d’après sa fiche technique. Ses connaissances s’arrêtent à juin 2026. Il s’ajoute à une année chargée, que notre récapitulatif des nouveaux modèles IA de 2026 suit sortie par sortie.
Prix Claude Haiku 5.5 : la grille, en dollars et en euros
Toute la nouveauté tient en un seuil : 100 000 tokens de prompt (un token est un fragment de mot, l’unité de compte de ces modèles). En dessous, Claude Haiku 5.5 coûte 0,10 $ par million de tokens en entrée et 0,50 $ en sortie. Au-dessus, 0,50 $ et 2,50 $. Haiku 4.5 facturait 1 $ et 5 $, quelle que soit la longueur. Au cours de référence de la Banque centrale européenne du 9 octobre 2026 (1 € pour 1,1206 $), cela donne :
- prompt jusqu’à 100 000 tokens : environ 0,09 € en entrée et 0,45 € en sortie, par million de tokens ;
- prompt au-delà : environ 0,45 € et 2,23 € ;
- pour mémoire, Haiku 4.5 : environ 0,89 € et 4,46 €.
Le reste suit. La lecture en cache (un début de prompt déjà envoyé, réutilisé) tombe à 0,01 $ le million sous le seuil. Le traitement par lots, quand la réponse peut attendre, divise tout par deux : 0,05 $ et 0,25 $. Et la mise en cache démarre à 512 tokens, contre 4 096 sur Haiku 4.5, ce qui profite aux petites consignes répétées. Le détail figure sur la page des tarifs.
Un point moins visible : sur l’API d’Anthropic, forcer le calcul aux États-Unis (paramètre inference_geo sur « us ») multiplie les prix par 1,1, le routage mondial par défaut restant au tarif standard. Aucune variante européenne n’est listée pour l’API directe ; pour une région européenne, il faut passer par un cloud partenaire et vérifier modèle par modèle. Si l’hébergement des données en Europe compte pour vous, comparez aussi les tarifs de l’API Mistral face à ceux d’OpenAI.
Moins 90 % ou moins 75 % : la subtilité du calcul
D’où sortent les 75 % ? D’une note de bas de page d’Anthropic. Le prix baisse de 90 % pour les requêtes courtes et de 50 % pour les longues, et 90 % des requêtes envoyées à Haiku 4.5 restaient sous les 100 000 tokens. Sur le papier, la remise frôle donc les 90 % pour presque tout le monde. Sauf que Claude Haiku 5.5 utilise un nouveau tokenizer, qui produit environ 30 % de tokens en plus pour un même texte, selon la page des nouveautés. Vous payez le token moins cher. Mais vous en payez davantage.
Faites le calcul sur une même tâche. Requête courte : un dixième du prix, multiplié par 1,3 tokens, donne environ 13 % de l’ancienne facture, soit une économie proche de 87 %. Requête longue : la moitié du prix fois 1,3 donne 65 %, donc 35 % d’économie seulement. La moyenne annoncée pour Claude Haiku 5.5, autour de 75 %, se situe entre les deux.
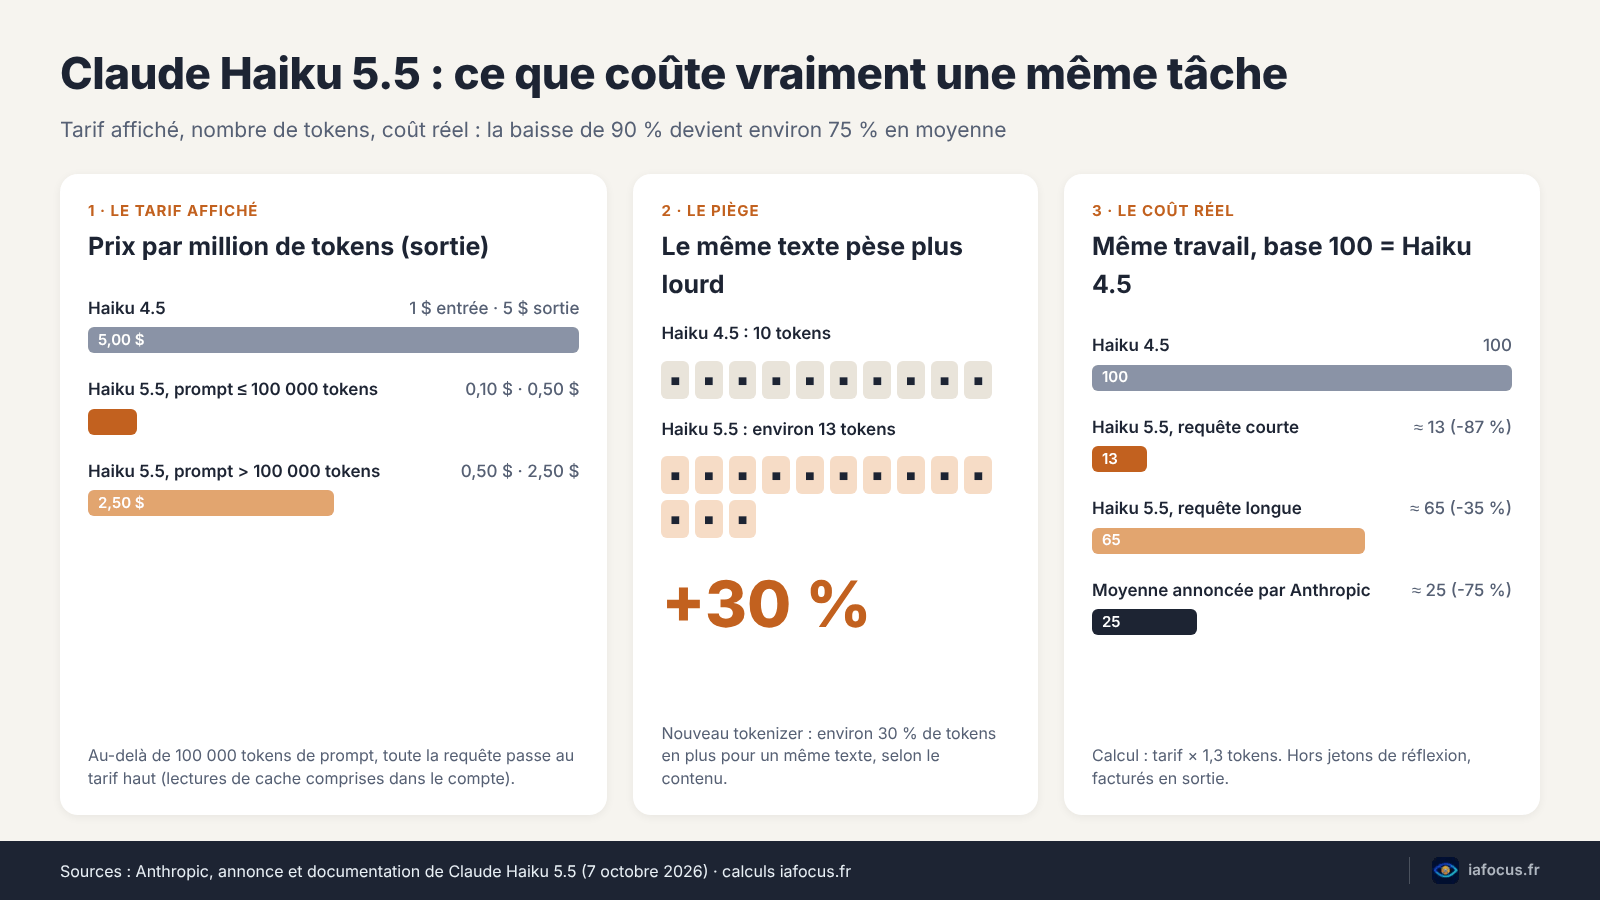
Le piège est là. Un prompt d’environ 77 000 tokens sur Haiku 4.5 peut franchir la barre des 100 000 sur Claude Haiku 5.5 sans que vous ayez changé une virgule. Et le seuil vaut pour toute la requête : dès qu’un prompt le dépasse, entrée comme sortie passent au tarif haut, cache compris. Pour qui envoie de longs documents (contrats, rapports annuels, historiques de conversation), recompter ses tokens n’a rien d’optionnel.
Seconde subtilité, la réflexion. Les tokens que le modèle consacre à « penser » sont facturés comme des tokens de sortie, donc au tarif le plus élevé, comme l’explique la documentation sur la réflexion adaptative. Activée par défaut, elle peut alourdir une question banale. Le réglage d’effort sert précisément à ça : effort bas, moins de réflexion, facture plus légère.
Un exemple chiffré. Prenez un service qui traite un million de requêtes par mois, chacune avec 2 000 tokens en entrée et 300 en sortie (comptés avec le nouveau tokenizer). Avec Claude Haiku 5.5, la facture atteint 350 $, environ 312 €. Le même travail sur Haiku 4.5, avec 30 % de tokens en moins, aurait coûté près de 2 700 $ (environ 2 400 €). Hors tokens de réflexion, certes, mais l’ordre de grandeur est clair : on tient là un modèle IA pas cher.
Performances : ce que montrent les benchmarks d’Anthropic
Tous ces chiffres viennent d’Anthropic. À prendre comme tels, en attendant des tests indépendants. Le saut depuis Haiku 4.5 reste frappant.
Sur GDPval-AA v2.1, un test d’Artificial Analysis qui note des agents sur du travail professionnel dans 44 métiers, Claude Haiku 5.5 obtient 1 620 points, contre 735 pour Haiku 4.5. GPT-6 Luna, le petit modèle d’OpenAI, en affiche 1 437 et Sonnet 5.5 1 840. Sur Humanity’s Last Exam, des questions de niveau expert, il passe de 10,2 % à 45,9 % sans outils. Et sur OSWorld 2.1, qui mesure la capacité à manier un vrai ordinateur, de 15,7 % à 72,4 %.
Mais il y a une limite, qu’Anthropic reconnaît. En programmation agentique, sur Terminal-Bench 4.0 (des tâches longues en ligne de commande), Claude Haiku 5.5 plafonne à 39,2 % quand Sonnet 5.5 atteint 70,6 %. Pour le code complexe, l’éditeur renvoie vers Sonnet et Opus. Haiku sert aux tâches étroites : résumer, classer, aiguiller une demande, compacter un contexte trop long, ou travailler comme sous-agent d’un modèle plus gros qui, lui, planifie.
Les premiers clients de Claude Haiku 5.5 vont dans le même sens, avec une précaution : ces témoignages sont choisis par l’éditeur. Asana mesure une latence réduite de plus de 30 %, Box 11 points gagnés sur Haiku 4.5 pour environ moitié moins de latence. Pour mesurer le chemin parcouru, notre comparatif Claude 3.5 Sonnet contre GPT-4o reste un bon repère.
Piloter un ordinateur : le vrai point fort de Claude Haiku 5.5
Le chiffre le plus spectaculaire de l’annonce, c’est OSWorld : 72,4 % sur le sous-ensemble hors ligne de ce test, où l’agent enchaîne des actions sur un vrai bureau (ouvrir des fenêtres, cliquer, remplir des champs) pour finir des tâches longues. Haiku 4.5 en réussissait 15,7 %. GPT-6 Luna, dans le tableau d’Anthropic, 48,9 %. Sonnet 5.5 reste devant avec 83,9 %, mais pour un modèle facturé vingt fois moins, l’écart surprend.
Concrètement, Anthropic vise la saisie de données, les formulaires, le transfert d’informations d’une application à l’autre. Le genre de travail qu’on confie aujourd’hui à des scripts fragiles, qui cassent au premier bouton déplacé. Les kits de développement Python et TypeScript intègrent le pilotage d’ordinateur et de navigateur, en bêta. Si le sujet est neuf pour vous, notre méthode pour automatiser ses tâches avec des agents IA pose les bases.
Attention au coût caché. Déclarer la boîte à outils de pilotage d’ordinateur ajoute environ 4 500 tokens d’entrée à chaque requête, celle du navigateur environ 6 600, et chaque capture d’écran est facturée comme une image. À 0,10 $ le million, ça reste modeste. Sur une boucle de cinquante actions avec captures, en revanche, le compteur tourne vite (et le seuil des 100 000 tokens arrive plus tôt qu’on ne le croit).
Pour qui Claude Haiku 5.5 vaut-il le coup face aux grands modèles ?
Pour la plupart des particuliers, la question du prix ne se pose pas : Claude Haiku 5.5 figure dans l’application Claude, version gratuite comprise, où l’on ne paie pas au token. Si vous comparez les assistants sans abonnement, notre comparatif des chatbots IA gratuits donne le contexte. Le vrai sujet, c’est l’API. Donc les entreprises et les développeurs.
Avec Claude Haiku 5.5, plusieurs profils s’en sortent gagnants. Les produits à fort volume : tri de courriels, classement de tickets, extraction de champs dans des factures. Les interfaces en temps réel, où chaque dixième de seconde compte, comme le chat, l’assistant vocal ou le support en direct. Une PME qui monte un agent IA de service client coche souvent ces deux cases. Et les architectures à plusieurs agents, où un gros modèle planifie puis délègue des sous-tâches à des Haiku lancés en parallèle.
À l’inverse, gardez un grand modèle pour le code complexe, le raisonnement long ou la rédaction exigeante. Sonnet 5.5 coûte 2 $ et 10 $ le million de tokens, Opus 5.5 4 $ et 20 $ : vingt et quarante fois plus que Claude Haiku 5.5 sous le seuil. Avec un tel écart, un mauvais aiguillage coûte cher dans les deux sens. Trop de Sonnet, et vous payez pour rien. Trop de Haiku sur des tâches qu’il rate, et vous payez en reprises. Et pour une tâche de pure décision, sans texte à rédiger, une IA non textuelle comme Jev promet d’aller encore plus vite.
Reste la concurrence. Côté prix, Claude Haiku 5.5 s’aligne exactement sur GPT-6 Luna, facturé 0,10 $ et 0,50 $ d’après la fiche du modèle chez OpenAI. La différence se joue sur les longs prompts : Luna ne double son prix d’entrée (et ne multiplie sa sortie que par 1,5) qu’au-delà de 272 000 tokens, quand Haiku multiplie les siens par cinq dès 100 000. Pour des documents longs, le calcul peut basculer. Pour des requêtes courtes, vos propres tests trancheront, pas un tableau publié par l’un des deux concurrents.
Deux annonces annexes comptent aussi. Les lectures de cache de Sonnet 5.5 passent de 0,20 $ à 0,10 $ le million, soit environ 20 % d’économie sur la plupart des tâches agentiques selon Anthropic. Et les abonnés Max et Team reçoivent un crédit API mensuel de 100 $ (Max 5x), 200 $ (Max 20x) ou jusqu’à 500 $ mutualisés (Team). De quoi tester un modèle IA pas cher sans sortir la carte bancaire. Pour mesurer ce que Claude Max donne face à ChatGPT Pro, voyez notre comparatif des deux abonnements.
Côté code, un programme écrit pour Haiku 4.5 ne passera pas tel quel sur Claude Haiku 5.5 : temperature, top_p, top_k, budget_tokens et le préremplissage de la réponse renvoient désormais une erreur.
Données, AI Act : ce qu’il faut savoir côté français
Anthropic sert l’Union européenne par sa filiale irlandaise, Anthropic Ireland Limited. Ça ne règle pas la question des données. Dans ses questions-réponses sur l’IA générative, la CNIL rappelle qu’avec un modèle utilisé par API, la maîtrise du système reste presque entièrement chez le fournisseur. Elle conseille d’éviter d’y envoyer des données personnelles et de regarder de près les clauses de transfert hors de l’UE. Un modèle bon marché incite à tout lui faire avaler, courriels clients, tickets, CV. Notre dossier sur les IA qui protègent les données sensibles détaille les garde-fous.
Côté réglementation, Claude Haiku 5.5 entre dans la catégorie des modèles d’IA à usage général visée par l’AI Act, dont les obligations s’appliquent aux fournisseurs depuis le 2 août 2025, rappelle la Commission européenne. Anthropic a signé le code de bonnes pratiques publié le 10 juillet 2025, l’outil volontaire qui permet de démontrer cette conformité. Pour l’entreprise qui l’intègre, d’autres obligations s’ajoutent selon son rôle : notre guide de l’AI Act pour les entreprises les résume.
Foire aux questions
Combien coûte Claude Haiku 5.5 ?
Sur l’API, 0,10 $ par million de tokens en entrée et 0,50 $ en sortie tant que le prompt reste sous 100 000 tokens, soit environ 0,09 € et 0,45 € au cours du 9 octobre 2026. Au-delà, 0,50 $ et 2,50 $ pour toute la requête. Le traitement par lots divise ces tarifs par deux.
Claude Haiku 5.5 est-il gratuit ?
Dans l’application Claude, oui : Anthropic le propose à toutes les formules, offre gratuite comprise, sur le web, iOS et Android, dans les limites d’usage de chaque formule. Sur l’API, il est payant au token.
Pourquoi 75 % de baisse et pas 90 % ?
Parce que le nouveau tokenizer compte environ 30 % de tokens en plus pour un même texte. Sur une requête courte, l’économie réelle avoisine 87 % ; sur une requête de plus de 100 000 tokens, elle tombe vers 35 %. La moyenne d’Anthropic mélange les deux selon la répartition observée sur Haiku 4.5.
Claude Haiku 5.5 peut-il remplacer Sonnet 5.5 ?
Pour les tâches courtes et répétitives, souvent, et pour vingt fois moins cher. Pour le code complexe, non : 39,2 % sur Terminal-Bench 4.0 contre 70,6 % pour Sonnet 5.5, selon Anthropic. Le bon usage consiste à les combiner, le grand modèle planifiant et Claude Haiku 5.5 exécutant.
Sources
- Commission européenne, The General-Purpose AI Code of Practice.
- Commission européenne, General-Purpose AI Models in the AI Act : questions et réponses.
- CNIL, Les questions-réponses de la CNIL sur l’utilisation d’un système d’IA générative.
- CNIL, Comment déployer une IA générative ? La CNIL apporte de premières précisions.
- Banque centrale européenne, taux de change de référence de l’euro en dollar (cours du 9 octobre 2026).
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.