L’essentiel à retenir : la rivalité entre Claude 3.5 Sonnet et GPT-4o est désormais historique, laissant place aux familles Claude Fable 5.1 et GPT-5.6. Pour vos projets, privilégiez OpenAI pour l’audio natif et Anthropic pour les documents longs. Ce choix stratégique, fondé sur vos données propriétaires, optimise vos coûts grâce à la mise en cache des tokens.
Claude 3.5 Sonnet affiche un score de 49 % sur le benchmark SWE-bench Verified, surpassant les 38 % de GPT-4o dans la résolution de problèmes d’ingénierie logicielle réelle. Mais comment choisir entre ces deux géants alors que leurs cycles de vie, parfois limités à treize mois, redéfinissent déjà les standards de performance ?
Le marché évolue si vite que ces modèles ont cédé la place aux familles Claude Fable 5.1 et GPT-5.6, rendant la comparaison classique claude 3.5 sonnet vs gpt-4o obsolète au profit d’une approche multimodèle stratégique. Nous analysons les critères de modalité, de coût et de conformité pour vous aider à bâtir une architecture IA résiliente et agnostique.
- Claude 3.5 Sonnet vs GPT-4o : bilan technique d’une ère révolue
- Claude 3.5 Sonnet vs GPT-4o : le raisonnement et le code
- Claude 3.5 Sonnet vs GPT-4o : audio et vision, l’avantage multimodal
- Claude 3.5 Sonnet vs GPT-4o : la gestion du contexte
- Claude 3.5 Sonnet vs GPT-4o : le coût réel des API
- Après Claude 3.5 Sonnet vs GPT-4o : bâtir une architecture agnostique
Claude 3.5 Sonnet vs GPT-4o : bilan technique d’une ère révolue
Sur Claude 3.5 Sonnet vs GPT-4o, le premier dominait le raisonnement de niveau diplômé avec 59,4 % de précision, tandis que GPT-4o restait maître du calcul mathématique (76,6 %) et de l’interaction vocale native ultra-rapide. Ces performances orientent désormais le choix vers des architectures hybrides selon les flux métiers.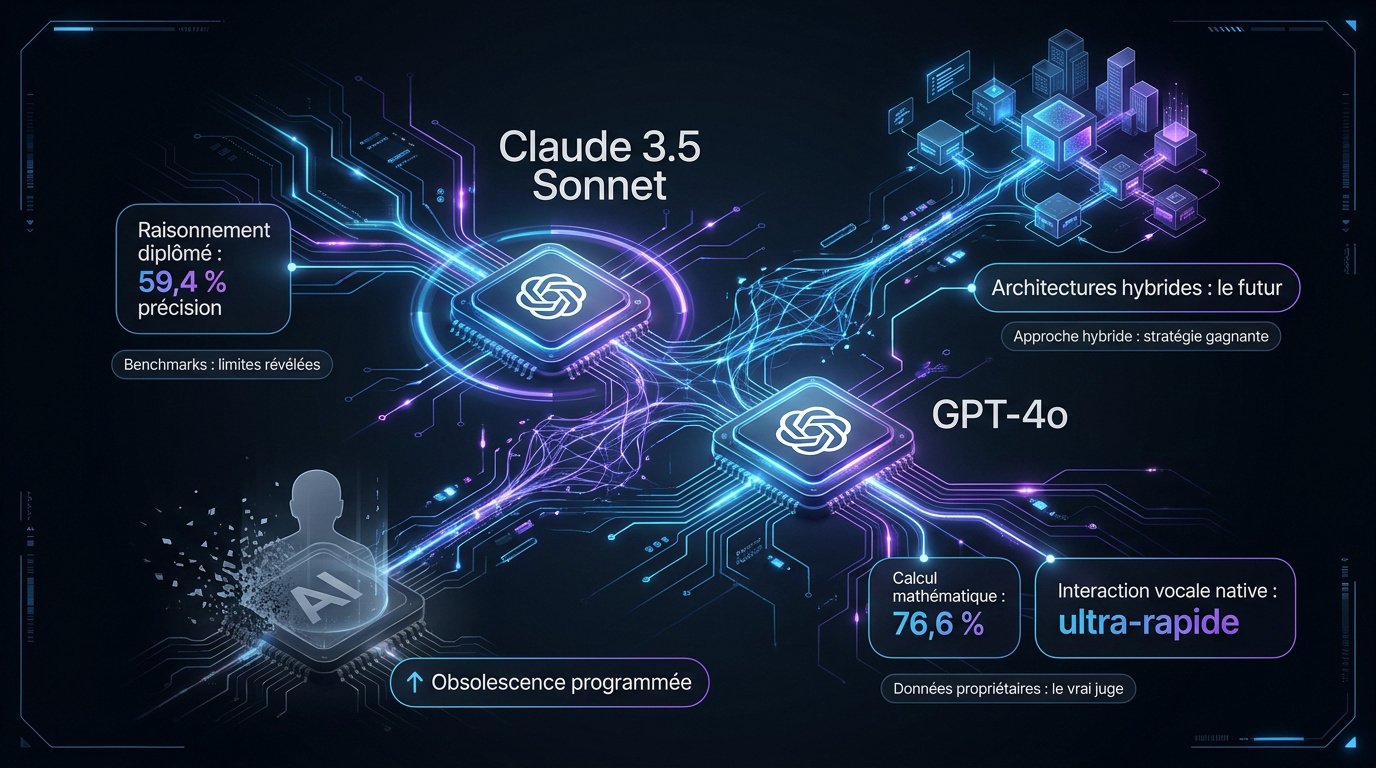
L’obsolescence programmée des anciens fleurons de l’IA
Claude 3.5 Sonnet et GPT-4o ont cédé leur place. Les architectures comme Claude Fable 5.1, sortie le 1er septembre 2026, ou GPT-5.6 redéfinissent les standards actuels. Le marché de l’intelligence artificielle progresse à une vitesse fulgurante.
Ces modèles servent maintenant de base historique. Les entreprises les utilisent comme étalons. Cela permet de mesurer les gains réels des futurs systèmes.
La transition est inévitable. Les cycles de vie des modèles se raccourcissent drastiquement. La course à la puissance ne laisse aucun répit aux anciennes versions.
Pourquoi les benchmarks publics ne reflètent plus la réalité
Les scores MMLU ou HumanEval sont souvent saturés. Les données d’entraînement polluent parfois les tests. Restez donc prudents face aux annonces marketing trop flatteuses. La réalité du terrain est souvent bien différente.
L’usage de scaffolds et d’outils internes modifie les résultats. Chaque laboratoire optimise ses mesures. Le véritable juge reste votre propre jeu de données confidentielles.
L’importance de l’évaluation continue sur des données propriétaires plutôt que sur des benchmarks publics devient le standard industriel pour garantir la fiabilité.
La fin du modèle unique au profit de l’approche hybride
On observe une convergence des capacités brutes. Les écarts se resserrent sur les tâches standards. Le choix entre OpenAI et Anthropic devient plus subtil pour vos équipes.
Testez les modèles sur vos flux réels. Un classement général ne prédit pas votre efficacité opérationnelle. C’est un fait établi par les experts du secteur.
L’hybridation permet de tirer le meilleur de chaque moteur. C’est la stratégie gagnante pour les développeurs exigeants. Découvrez d’ailleurs les nouveaux modèles IA de 2026 pour anticiper vos prochains déploiements.
Claude 3.5 Sonnet vs GPT-4o : le raisonnement et le code
Si les performances globales convergent, c’est dans le cambouis du code et la logique pure que les vraies différences éclatent.
Claude 3.5 Sonnet vs GPT-4o en génération de code
Claude 3.5 Sonnet brillait par sa précision syntaxique en backend. Il identifiait des bugs complexes là où d’autres échouaient, et son approche des patterns idiomatiques était remarquable. Les développeurs appréciaient cette rigueur.
GPT-4o restait très compétitif sur les scripts rapides, sa vitesse d’exécution compensant une analyse moins fine. Mais sur le débogage profond, Claude 3.5 Sonnet vs GPT-4o tranchait clairement en faveur d’Anthropic. Selon les chiffres d’Anthropic, ce modèle résout 64% des problèmes de codage lors de tests agentiques. Pour aller plus loin, consultez notre comparatif des IA pour coder.
Logique mathématique et résolution de problèmes complexes
Sur le benchmark MATH, GPT-4o gardait une avance notable et résolvait des équations complexes avec une stabilité supérieure. C’est son terrain de prédilection.
Claude 3.5 Sonnet excellait pourtant en raisonnement de niveau universitaire et surpassait son rival sur le test GPQA/Diamond.
La fiabilité des chaînes de pensée prolongées varie. Tout dépend de la structure du problème posé initialement. Les tableaux de benchmarks publiés par les deux laboratoires confirment cette dualité entre précision MATH et supériorité GPQA.
Qualité de l’interaction et aspect humain des réponses
L’aspect humain des réponses change la donne pour l’utilisateur. Claude proposait souvent des explications plus pédagogiques, sur un ton moins robotique.
GPT-4o misait sur la concision extrême, avec des instructions directes et efficaces pour un expert pressé.
Une interaction fluide réduit la fatigue cognitive. Choisissez selon votre préférence pour le style rédactionnel généré.
Claude 3.5 Sonnet vs GPT-4o : audio et vision, l’avantage multimodal
Mais le texte n’est plus le seul champ de bataille, car les capacités sensorielles redéfinissent l’usage professionnel.
Claude 3.5 Sonnet vs GPT-4o en analyse visuelle
Sur le terrain de la vision, Claude 3.5 Sonnet vs GPT-4o tournait à l’avantage d’Anthropic. Le modèle extrayait des données de graphiques avec une précision chirurgicale, et les schémas techniques ne lui faisaient pas peur.
Il comprenait les relations spatiales mieux que ses prédécesseurs, un atout majeur pour l’analyse de documents complexes.
GPT-4o restait solide mais s’inclinait sur la transcription d’images imparfaites. La différence est notable sur le terrain, comme le confirme cette analyse de performance vision.
Latence et réactivité des flux audio natifs
OpenAI écrasait la concurrence avec sa pile vocale native « Omni ». Via l’API Realtime, la réponse à une entrée audio tombait à environ 320 millisecondes en moyenne, contre 2 à 3 secondes sur les modèles précédents. On a l’impression de parler à un humain. C’est une prouesse technique impressionnante pour les centres d’appels.
Anthropic accusait un retard sur ce point précis, ses modèles nécessitant des couches supplémentaires pour l’audio. Cela nuit à la fluidité immédiate, impactant directement le déploiement d’un agent autonome efficace.
Claude 3.5 Sonnet vs GPT-4o : vitesse et temps de traitement
La latence du premier token est cruciale pour l’expérience utilisateur. Sur Claude 3.5 Sonnet vs GPT-4o, GPT-4o rendait la main environ 24 % plus vite que son concurrent sur une requête texte courte. C’était son avantage pour le temps réel.
Claude 3.5 Sonnet, lui, était deux fois plus véloce que Claude 3 Opus — un gain mesuré face à son propre prédécesseur, et non face à GPT-4o. Les deux chiffres ne se comparent pas.
La stabilité du débit lors des pics de charge varie. OpenAI semble mieux encaisser les volumes massifs.
Claude 3.5 Sonnet vs GPT-4o : la gestion du contexte
Au-delà de la vitesse, c’est la capacité à « digérer » des bibliothèques entières qui sépare les experts des amateurs.
Claude 3.5 Sonnet vs GPT-4o sur les documents longs
Dans le duel Claude 3.5 Sonnet vs GPT-4o, Anthropic proposait une fenêtre de 200 000 tokens, idéale pour analyser des rapports techniques denses sans perte. La mémoire de travail était vaste.
GPT-4o gérait des volumes importants mais montrait des signes de fatigue au-delà de ses 128 000 tokens. La perte d’information au milieu du contexte était réelle.
Pour des bases de connaissances complètes, la tenue de Claude 3.5 Sonnet sur la longueur était exemplaire, et c’est l’héritage que les modèles Claude actuels ont conservé.
Fiabilité de la compréhension contextuelle profonde
Maintenir la cohérence sur des sessions prolongées est un défi. Claude 3.5 Sonnet excellait dans le rappel d’informations nichées. Il ne se laissait pas distraire par le bruit ambiant. C’est une force pour les analyses juridiques.
GPT-4o faisait preuve d’une méta-conscience intéressante et structurait ses réflexions de manière autonome. Cela aide à suivre le fil logique du raisonnement.
Sur ce point précis, Claude 3.5 Sonnet vs GPT-4o penchait vers Anthropic : longs contextes mieux tenus et abstractions plus claires, donc une fiabilité supérieure sur les projets de développement complexes.
Impact de la fenêtre de contexte sur les flux métiers
La taille du contexte modifie votre préparation de données. Un large contexte réduit le besoin de segmentation RAG complexe. C’est un gain de temps.
Les limites opérationnelles restent réelles pour les bases géantes. Il faut savoir quand passer au traitement par lots.
L’optimisation de la fenêtre impacte directement vos coûts. Ne chargez que le nécessaire pour rester efficace.
Claude 3.5 Sonnet vs GPT-4o : le coût réel des API
L’excellence technique ne vaut rien si elle ruine votre budget d’exploitation, d’où l’importance d’une analyse financière pointue.
Tarifs de Claude 3.5 Sonnet vs GPT-4o et mise en cache
La mise en cache des tokens réduit drastiquement vos factures. OpenAI et Anthropic proposent des solutions pour optimiser ces coûts. C’est un levier financier majeur.
Claude 3.5 Sonnet coûtait 3 $ par million de tokens en entrée, contre 2,50 $ pour GPT-4o. Ces tarifs ne valent plus que comme repère historique.
Le traitement par lots permet des économies substantielles. Utilisez-le pour toutes vos tâches de fond non urgentes.
| Critère | Claude 3.5 Sonnet | GPT-4o |
|---|---|---|
| Prix Entrée (1M tokens) | 3,00 $ | 2,50 $ |
| Prix Sortie (1M tokens) | 15,00 $ | 10,00 $ |
| Fenêtre Contexte | 200 000 tokens | 128 000 tokens |
| Latence texte (relative) | Référence | ~24 % plus rapide |
| API audio native | Non | Oui (Realtime, ~320 ms) |
Sécurité des données et conformité pour les entreprises
La résidence des données est un point non négociable. Anthropic classait alors ses modèles au niveau ASL-2 de sa politique de mise à l’échelle responsable : c’est un repère de sûreté du modèle, à ne pas confondre avec une certification de sécurité des données. Les entreprises régulées apprécient cette transparence.
Les politiques de non-rétention via API protègent votre propriété intellectuelle. Vérifiez toujours les conditions de vos partenaires cloud.
La conformité RGPD reste le socle de toute intégration. Ne faites aucun compromis sur la vie privée.
Pour aller plus loin, découvrez comment un agent IA open source garantit votre souveraineté numérique.
Différences entre besoins temps réel et traitement différé
L’urgence de la réponse dictait souvent le choix final. Sur Claude 3.5 Sonnet vs GPT-4o, un chatbot client allait vers la latence de GPT-4o, une analyse de fond vers la précision de Claude. L’arbitrage se pose dans les mêmes termes avec leurs successeurs. Il faut arbitrer entre vitesse et profondeur.
Évaluez le rapport performance-prix pour chaque cas d’usage. L’automatisation asynchrone permet d’utiliser des modèles plus lourds à moindre coût. C’est stratégique.
Après Claude 3.5 Sonnet vs GPT-4o : bâtir une architecture agnostique
Pour ne pas rester prisonnier d’un seul écosystème, il est temps de concevoir une infrastructure flexible et résiliente.
L’importance des couches d’abstraction technique
Une interface commune limite votre dépendance à un fournisseur. Ne vous enfermez pas dans des SDK propriétaires trop rigides. L’agilité est votre meilleure arme technique.
Mettez en place des tests A/B permanents. Comparez les sorties en temps réel pour détecter les dérives.
Cette couche d’abstraction facilite la migration vers de futurs modèles plus performants. Anticipez dès aujourd’hui les sorties de demain.
Couplage des modèles pour maximiser les performances
Utilisez simultanément OpenAI pour l’audio et Anthropic pour le texte complexe. Ce routage intelligent maximise l’efficacité globale de votre application. Chaque requête trouve son moteur idéal. C’est une approche moderne et pragmatique. Le résultat est souvent bluffant.
Analysez les gains en routant les demandes selon leur complexité. Les tâches simples vont au moins cher. Les problèmes ardus vont au plus intelligent.
- Utiliser GPT-4o pour la voix et la vision rapide
- Utiliser Claude 3.5 Sonnet pour le code complexe et les documents longs
- Router les tâches simples vers des modèles mini pour réduire les coûts
Évaluation continue sur données propriétaires
Créez vos propres jeux de tests internes. Ne validez pas une mise à jour sur la base de simples benchmarks publics. Votre domaine est unique.
La performance réelle dépend de votre vocabulaire métier. Un modèle excellent en médecine peut faillir en finance.
L’évaluation continue garantit la stabilité de vos services. Soyez proactif dans la mesure de la qualité de vos sorties IA en utilisant un correcteur orthographique IA adapté.
L’arbitrage entre Claude 3.5 Sonnet et GPT-4o est désormais révolu au profit d’architectures hybrides intégrant Claude Fable 5.1 et GPT-5.6. Privilégiez OpenAI pour l’audio natif et Anthropic pour les analyses documentaires complexes, tout en bâtissant des couches d’abstraction pour sécuriser vos futurs déploiements. Optimisez dès maintenant vos flux métiers grâce à une évaluation continue sur vos données propriétaires.
FAQ
Pourquoi la comparaison Claude 3.5 Sonnet vs GPT-4o est-elle devenue inutile ?
La comparaison directe entre ces deux modèles est désormais obsolète, car ils ont été retirés du marché pour laisser place à une nouvelle génération. Claude 3.5 Sonnet a été retiré par Anthropic le 28 octobre 2025, tandis qu’OpenAI a sorti GPT-4o du sélecteur de ChatGPT le 13 février 2026, puis de l’API quelques jours plus tard. La compétition se joue désormais entre leurs successeurs respectifs, tels que Claude Fable 5.1, sortie le 1er septembre 2026, et la famille GPT-5.6 (Luna, Terra, Sol), lancée le 9 juillet 2026. Pour un face-à-face à jour entre les deux géants, lisez notre comparatif Gemini vs ChatGPT.
Ces nouveaux systèmes affichent des performances et des tarifs extrêmement proches, rendant les anciens benchmarks comme HumanEval ou MMLU peu pertinents. Le choix d’une solution ne repose plus sur une supériorité globale, mais sur une analyse fine des besoins spécifiques en multimodalité et en intégration métier.
Quelle IA choisir pour des applications nécessitant une interaction vocale ?
Pour vos projets intégrant de l’audio en temps réel, OpenAI conserve un avantage concurrentiel décisif grâce à sa pile vocale native « Omni ». Via son API Realtime, GPT-4o offrait déjà une latence moyenne de 320 millisecondes, simulant parfaitement une conversation humaine. Cette architecture de bout en bout permet un chemin d’implémentation beaucoup plus court pour les centres d’appels et les assistants vocaux.
À l’inverse, Anthropic n’offre pas d’API audio native, nécessitant l’ajout de couches logicielles supplémentaires pour traiter le son. Cela induit une latence plus élevée et une complexité technique accrue. Si la réactivité vocale est votre priorité absolue, les solutions d’OpenAI demeurent le standard industriel.
Claude 3.5 Sonnet vs GPT-4o : lequel traitait le mieux le code ?
Claude 3.5 Sonnet s’est illustré par une précision remarquable en développement logiciel, résolvant 64 % des problèmes lors des tests de codage agentique. Il surpassait nettement les capacités de raisonnement de ses concurrents sur des bugs complexes et des migrations de bases de code. Sa capacité à écrire et exécuter du code de manière autonome en a fait un outil privilégié pour les ingénieurs exigeants.
Bien que GPT-4o soit resté très efficace pour la génération de scripts rapides, la rigueur syntaxique et la compréhension des nuances structurelles de Claude offraient une fiabilité supérieure. Cette force se retrouve aujourd’hui dans les modèles Claude Fable 5.1 et Opus 5, qui maintiennent cette avance sur les documents techniques denses et le raisonnement de niveau universitaire.
Quelle est l’importance de la fenêtre de contexte pour les entreprises ?
La gestion du contexte est cruciale pour traiter des volumes massifs de données sans perte d’information. Avec une fenêtre de 200 000 tokens, Claude 3.5 Sonnet permettait d’analyser des rapports techniques complets ou des bases juridiques complexes avec une stabilité exemplaire. Cette vaste mémoire de travail réduit considérablement le besoin de segmentations RAG complexes, simplifiant ainsi vos flux métiers.
Cependant, les modèles actuels des deux fournisseurs proposent désormais des fenêtres dépassant le million de tokens. Le différenciateur ne réside donc plus dans la taille brute, mais dans la fidélité du rappel des informations nichées au cœur du document, où les modèles d’Anthropic excellent traditionnellement par leur cohérence sur les sessions prolongées.
Comment optimiser les coûts lors de l’utilisation de ces API ?
Le prix par million de tokens est un indicateur souvent trompeur s’il est pris isolément. Pour une rentabilité réelle, vous devez intégrer les mécanismes de mise en cache des jetons et le traitement par lots (batching), qui permettent de réduire drastiquement les factures d’exploitation. Par exemple, Claude 3.5 Sonnet était positionné à 3 $ par million de tokens en entrée, contre 2,50 $ pour GPT-4o.
Une modélisation financière précise doit également tenir compte des différences de tokenizers entre OpenAI et Anthropic. L’utilisation stratégique du routage intelligent, envoyant les tâches simples vers des modèles « mini » et réservant les modèles phares pour le raisonnement complexe, reste la meilleure méthode pour maximiser votre retour sur investissement.
Pourquoi faut-il privilégier une architecture IA agnostique ?
Compte tenu de la brièveté des cycles de vie des modèles, parfois limitée à 13 mois, il est impératif de construire vos infrastructures derrière une couche d’abstraction technique. Cela vous permet de migrer rapidement d’un fournisseur à l’autre sans réécrire l’intégralité de votre code. L’agilité est votre meilleure protection contre l’obsolescence programmée des technologies actuelles.
En adoptant une approche multimodèle, vous pouvez coupler les forces de chaque acteur : utiliser OpenAI pour la vision rapide et l’audio, tout en sollicitant les modèles d’Anthropic pour l’analyse de documents longs et le code complexe. Cette stratégie garantit une résilience opérationnelle et une performance optimale sur le long terme.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.