Cinq millions de téléchargements sur Hugging Face, d’après ses auteurs : Apertus n’est plus une curiosité de laboratoire. Apertus 1.5 est sorti le 24 juillet 2026, mais c’est en octobre qu’il a livré son dossier complet, avec un rapport technique déposé le 11 et des notes de version mises en ligne le 14. Ce LLM open source de l’EPFL, de l’ETH Zurich et du CSCS (le Centre suisse de calcul scientifique) lit maintenant des images, entend un peu, réfléchit sur demande. Et il parle français.
Bien ? Tout dépend de ce que vous lui demandez. Ses concepteurs ne prétendent pas rivaliser avec les modèles de pointe du privé. Leur pari est ailleurs : tout publier, des poids aux données d’entraînement, pour que chacun puisse vérifier et refaire.
Apertus 1.5 : ce qui change depuis la première version
Apertus 1.0, sorti le 2 septembre 2025, ne traitait que du texte. La nouvelle version garde la même architecture et les deux mêmes tailles (8 et 70 milliards de paramètres), puis prolonge l’entraînement : 4 000 milliards de jetons de plus pour le petit modèle, 2 000 milliards pour le grand, soit 19 000 et 17 000 milliards de jetons au total. Plus de la moitié de ce supplément reste du texte seul, pour ne rien abîmer de l’acquis.
Les nouveautés tiennent en quatre points :
- Images et audio en entrée : un schéma, un PDF scanné, un enregistrement. L’audio reste expérimental, de l’aveu même de l’équipe, et les réponses sont toujours du texte.
- Un mode réflexion, éteint par défaut, sur le principe des modèles de raisonnement. D’après le rapport technique, il fait gagner jusqu’à 20 points en raisonnement mathématique sur le 8B.
- Une fenêtre de contexte de 262 144 jetons, quatre fois celle de la 1.0 : de quoi charger un long rapport d’un bloc.
- Un meilleur suivi des consignes, et des appels d’outils (API, fonctions) plus fiables.
Pas de module de vision greffé à côté : images et sons sont découpés en jetons, comme les mots. Une image de 512 × 512 pixels devient 1 024 jetons, une seconde d’audio en donne 40. Seul le vocabulaire s’est allongé.
Une limite à connaître avant de bâtir un agent : réflexion et appels d’outils ne se combinent pas, et les fournisseurs proposent l’un ou l’autre. Le rapport l’admet, ce post-entraînement n’a pas été pensé pour les agents.
Qui fabrique ce modèle, et pourquoi on parle d’IA souveraine
Apertus sort d’un projet de recherche public, la Swiss AI Initiative, porté par les deux écoles polytechniques fédérales (l’EPFL à Lausanne, l’ETH à Zurich) et par le CSCS. Martin Jaggi et Antoine Bosselut le dirigent côté lausannois, Imanol Schlag côté zurichois. L’entraînement a eu lieu sur Alps, le supercalculateur du CSCS à Lugano.
Le mot d’ordre, c’est l’IA souveraine : une infrastructure ouverte que les administrations, les chercheurs et les entreprises peuvent inspecter et faire tourner chez eux, au lieu de dépendre d’un modèle commercial fermé. Imanol Schlag le résume à sa façon : pas question de concurrencer les modèles de pointe du privé, l’idée est d’offrir une base transparente sur laquelle construire en confiance. La même logique pousse des entreprises vers les agents IA open source qui gardent les données en interne.
Des usages existent déjà, tous bâtis sur la première version. Le canton du Tessin traduit ses documents sensibles avec un outil interne fondé sur Apertus 8B, affiné par la société Artificialy (90 % à son propre test avant affinage, 94 % après, d’après l’entreprise). À Bâle, le média en ligne Bajour fait tourner le modèle en local dans sa rédaction. Et le CSCS ouvre un service d’inférence Apertus 1.5 à toute la communauté académique suisse.
Côté énergie, le rapport chiffre le pré-entraînement continu à environ 2 millions d’heures de GPU, soit 1,1 GWh, contre environ 5 GWh pour la première version. Alps tourne à l’hydroélectricité et se refroidit à l’eau du lac. La suite est annoncée : un Apertus 2.0 à architecture MoE (mélange d’experts), autour de 600 milliards de paramètres au total, centré sur les agents, les maths et le code.
Données d’entraînement publiées : ce que « entièrement ouvert » veut dire
Beaucoup de modèles se disent ouverts parce que leurs poids se téléchargent. C’est utile, mais vous ignorez sur quoi ils ont appris. Le rapport technique range d’ailleurs ses concurrents en deux familles : les modèles entièrement ouverts, qui publient poids, données et recettes d’entraînement, et les modèles à poids ouverts.
Apertus joue la première carte jusqu’au bout. Chaque jeu de données, avec sa version et sa licence, figure dans le dépôt public de transparence des données. Les étapes intermédiaires de l’entraînement (modèle de base, ajustement supervisé, renforcement, alignement) se téléchargent une à une. Un chercheur peut ainsi mesurer ce que chaque étape change. C’est un LLM open source au sens fort.
Le tri des données mérite qu’on s’y arrête, surtout si vous publiez sur le web. Seules des sources publiques sous licence permissive ont été retenues. Les sites qui bloquaient au moins un robot d’IA en janvier 2025 ont été retirés de toutes les collectes, jusqu’à celles de 2013 : un opt-out rétroactif. Pour limiter la recopie mot à mot, l’entraînement masque en moyenne un jeton sur 50. Si la question du droit d’auteur et des créations générées par IA vous occupe, c’est un argument sérieux.
Revers de la médaille : les connaissances du modèle s’arrêtent pour l’essentiel en mars 2024, avec quelques documents plus récents (jusqu’en avril 2026). Ne lui demandez pas l’actualité. L’équipe conseille aussi de retélécharger les poids tous les six mois, car les demandes de suppression de données personnelles sont prises en compte à chaque version.
Le français et les autres langues : promesse tenue, avec des réserves
Apertus 1.0 avait appris sur plus de 1 000 langues, avec environ 40 % de données non anglophones, suisse allemand et romanche compris. La FAQ officielle parle aujourd’hui de plus de 1 800 langues vues à l’entraînement. Mais elle ajoute aussitôt que le modèle ne converse vraiment bien que dans quelques dizaines d’entre elles.
Le français a droit à un traitement de faveur, pour une raison simple : c’est une langue nationale suisse. Les évaluations de traduction du rapport suivent de près l’allemand, le suisse allemand, le français, l’italien et le romanche, et les tests de sécurité ont été passés en français aussi. Sur le Last Translation Benchmark, une batterie de traductions difficiles dans plus de 100 langues, Apertus 1.5 8B fait jeu égal avec GPT-OSS-20B d’OpenAI et devance Claude Haiku 4.5 comme Google Traduction. Curiosité : le 70B y fait moins bien que le petit.
Le romanche montre la méthode. Cette langue compte six variétés écrites, que la première version mélangeait. L’équipe a ajouté des textes traduits vers l’allemand puis retraduits dans chaque variété, et le 8B dépasse désormais nettement les modèles comparables de l’allemand vers le romanche.
Tout n’est pas rose. En reconnaissance vocale du français, Apertus 1.5 affiche au test FLEURS un taux d’erreur de 22,2 % sur les mots (8B) et de 21 % (70B), quand Qwen2.5-Omni descend à 10,6 %. Pour transcrire une réunion, un outil spécialisé reste préférable. Le modèle se trompe aussi parfois sur sa propre identité, surtout dans les langues moins dotées. Et face à des questions factuelles courtes, il tente une réponse plus de huit fois sur dix et invente dans six à sept cas sur dix. Vérifiez tout.
Apertus et l’AI Act : des documents publiés, pas de conformité revendiquée
Le règlement européen sur l’IA s’applique aux fournisseurs de modèles d’IA à usage général depuis le 2 août 2025, et les amendes de la Commission sont possibles depuis le 2 août 2026 (le point sur ce que l’AI Act impose déjà en 2026). L’article 53 fixe quatre obligations : documentation technique, informations pour les intégrateurs, politique de droit d’auteur et résumé public des données d’entraînement. Les deux premières ne visent pas les modèles sous licence libre publiés avec leurs poids, sauf risque systémique.
L’équipe fournit ces pièces sans revendiquer de conformité. Avec Apertus 1.5 sont parus un résumé public des données d’entraînement, sur le modèle de la Commission, et un code de bonnes pratiques livré à titre volontaire. Les deux écoles n’ont pas signé le formulaire d’adhésion du Bureau de l’IA, et le rapport précise qu’aucun de ces documents n’affirme qu’une obligation est remplie. Bref, aucune conformité revendiquée, mais une documentation en accès libre.
La FAQ du projet se montre plus confiante : le modèle a été conçu avec le règlement en tête, et une évaluation de LatticeFlow AI l’a jugé prêt pour l’AI Act. L’équipe le classe comme modèle sans risque systémique prévisible. Pour une entreprise française qui l’intègre dans un service, le RGPD et ses propres obligations au titre du règlement restent à sa charge, comme avec n’importe quel modèle.
Comment essayer Apertus : en ligne, par API ou en local
En ligne, sans rien installer
Le plus rapide, c’est Public AI, une initiative à but non lucratif qui permet de discuter tout de suite avec le 8B. Pour le 70B ou une API, il faut un compte. Apertus 1.5 est aussi intégré à Lumo, l’assistant de Proton, et à Euria, celui d’Infomaniak.
Par API, avec un hébergement en Suisse
Swisscom, Infomaniak, Phoeniqs et Safe Swiss Cloud facturent le 70B au jeton depuis des centres de données suisses, Public AI et Featherless depuis plusieurs régions du monde. Le guide officiel de septembre 2026 tient la liste.
En local, sur votre machine
Les poids sont sur la fiche Hugging Face du modèle 8B, derrière un accès contrôlé : vous acceptez la licence Apache 2.0 et la politique d’usage, et vous partagez votre e-mail et votre nom d’utilisateur. La validation est automatique et immédiate.
Le 8B tourne sur beaucoup d’ordinateurs portables et de stations de travail ; le 70B réclame une machine de serveur (l’exemple de la fiche le répartit sur quatre GPU). Côté logiciels :
- LM Studio : tapez « Apertus 1.5 » dans le catalogue et prenez une version communautaire, au format MLX sur un Mac à puce Apple.
- Ollama : passez par une version GGUF communautaire, l’équipe en a vérifié une pour le 8B.
- Transformers ou vLLM : la prise en charge n’est pas encore dans les versions publiées, il faut la branche de l’équipe ou son image Docker.
L’équipe ne garantit pas les versions communautaires. Si vous débutez, notre guide pour installer une IA en local sur Mac ou PC détaille le matériel.
Apertus face à Mistral : deux idées de l’ouverture
Mistral AI publie lui aussi des modèles à poids ouverts sous Apache 2.0, comme Mistral Small 4 ou la gamme Ministral 3. Son pendant à taille égale s’appelle Ministral 3 8B : il lit les images, accepte 256 000 jetons de contexte, parle des dizaines de langues dont le français et tient dans 12 Go de mémoire graphique en FP8.
La différence se joue ailleurs. La fiche de Ministral 3 décrit le modèle et son déploiement, pas les jeux de données qui l’ont formé. Apertus publie tout. Pour une administration, un labo ou un média qui doit justifier ses choix, ça change la nature du dossier. Pour qui veut seulement la meilleure réponse, beaucoup moins.
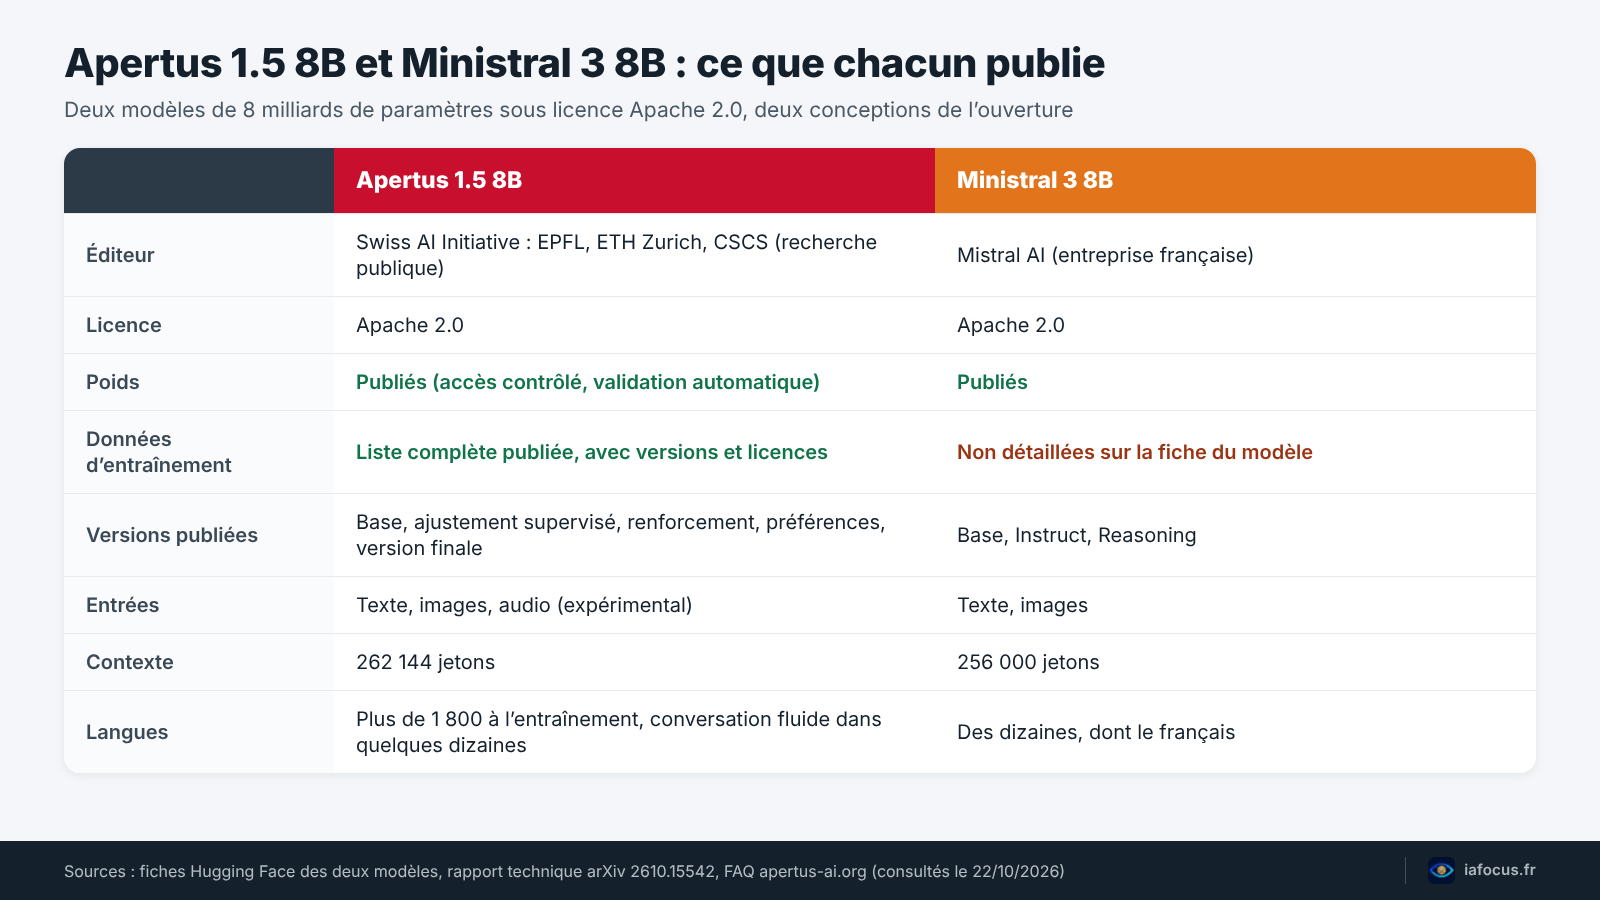
Sur les performances brutes, le modèle suisse reste derrière, et ses auteurs l’écrivent. Sur Global-MMLU, un test de connaissances multilingue, Apertus 1.5 8B obtient 59,4 contre 74,6 pour Qwen3.5 9B. Il se rattrape sur le suivi de consignes en plusieurs langues (Multi-IF : 83,7 contre 80). Le rapport a aussi glissé Ministral 3 8B dans son évaluation humaine de traduction, où le 8B suisse évite les erreurs graves sur les paires de langues suisses.
En clair, Mistral garde l’avantage d’un éditeur commercial, d’une gamme large et d’une API européenne ; notre comparatif Mistral AI ou OpenAI détaille ses modèles et ses prix. Si la traçabilité des données compte plus que quelques points de score, Apertus se défend bien : parmi les modèles entièrement ouverts de sa taille, le rapport place le 8B en tête sur les connaissances et le suivi des consignes.
Foire aux questions
Apertus est-il gratuit pour un usage commercial ?
Oui. Les poids sont sous licence Apache 2.0, qui autorise la recherche comme l’usage commercial, sans redevance. Il faut seulement respecter la licence et la politique d’usage acceptée au téléchargement. Passer par un hébergeur (Swisscom, Infomaniak, Public AI…) est en revanche facturé selon ses tarifs, le plus souvent au jeton.
Apertus parle-t-il bien français ?
Le français est une langue nationale suisse et fait partie des langues suivies de près dans ses évaluations. En traduction de textes difficiles, le 8B rivalise avec des modèles plus gros. Sa reconnaissance vocale du français reste bien moins précise que celle des outils spécialisés, et ses connaissances s’arrêtent pour l’essentiel en mars 2024.
Quel ordinateur faut-il pour faire tourner le modèle en local ?
Le 8B fonctionne sur beaucoup d’ordinateurs portables et de stations de travail, via LM Studio ou Ollama et une version communautaire compressée. Le 70B demande un serveur à plusieurs cartes graphiques : la fiche officielle donne un exemple sur quatre GPU.
Apertus est-il conforme à l’AI Act ?
L’équipe ne le revendique pas. Elle publie le résumé des données d’entraînement prévu par l’article 53 et un code de bonnes pratiques volontaire, mais précise qu’aucun de ces documents n’affirme qu’une obligation est remplie. Sous licence libre, le modèle échappe à une partie des obligations de documentation. Votre usage, lui, reste soumis au règlement et au RGPD.
Sources
- EPFL, communiqué de lancement de la version 1.5 (24 juillet 2026)
- ETH AI Center, communiqué de lancement (24 juillet 2026)
- CSCS, communiqué et service d’inférence (24 juillet 2026)
- CSCS, l’outil de traduction du canton du Tessin (17 mars 2026)
- EPFL, lancement de la première version, en français (2 septembre 2025)
- Swiss AI Initiative, notes de version (14 octobre 2026)
- Swiss AI Initiative, foire aux questions du projet
- Rapport technique de la version 1.5, arXiv 2610.15542 (11 octobre 2026)
- Commission européenne, AI Act Service Desk : article 113, dates d’application