Pour transcrire une interview d’une heure, une API de reconnaissance vocale facture aujourd’hui entre 0,21 et 0,36 dollar selon le modèle, et Whisper ne coûte rien s’il tourne sur votre ordinateur. Le prix a cessé d’être un sujet. Le vrai travail se trouve ailleurs : avant l’enregistrement, pendant la relecture, et au moment de décider où dorment les fichiers audio.
Ce tutoriel s’adresse aux journalistes, aux étudiants et aux chercheurs, des gens qui vont citer quelqu’un. Il montre comment transcrire une interview de bout en bout : consentement, transcription verbatim ou texte nettoyé, identification des locuteurs, cinq outils, relecture, RGPD. Vous montez de la vidéo ? Voyez plutôt notre comparatif du meilleur outil de transcription IA pour monteurs. Pour les comptes rendus de réunion, notre test des IA de prise de notes en réunion répond mieux.
Avant d’enregistrer : consentement et qualité du son
Avant de transcrire une interview, encore faut-il l’avoir enregistrée dans les règles. Capter sans son consentement des paroles qu’une personne prononce à titre privé ou confidentiel est un délit : l’article 226-1 du Code pénal prévoit un an d’emprisonnement et 45 000 euros d’amende. Le consentement est présumé si l’enregistrement se fait au vu et au su de la personne, qui ne s’y oppose pas alors qu’elle le pouvait. Une présomption ne vaut pas une preuve.
La parade tient en trente secondes : lancez l’enregistrement, puis faites dire à voix haute le nom de la personne, la date, l’objet de l’entretien et son accord. Si l’audio part ensuite chez un service en ligne, dites-le aussi.
Côté technique, un micro par personne vaut mieux qu’un excellent micro au milieu de la table. Deux micros-cravates sur deux pistes séparées, et la moitié du travail d’attribution des voix disparaît : ElevenLabs traite chaque canal à part et lui attribue un locuteur, jusqu’à cinq canaux selon sa documentation. Ajoutez une pièce calme et un test réécouté au casque.
Dernier réflexe : notez l’orthographe des noms propres, des sigles et du jargon. Ces listes nourrissent les outils qui acceptent un vocabulaire imposé, jusqu’à 1 000 termes chez ElevenLabs ; chez Mistral AI, Voxtral 3 n’impose plus de nombre fixe, tant que la liste tient dans sa fenêtre de contexte. Un nom de commune mal transcrit dix fois, ce sont dix corrections à la main.
Transcription verbatim ou texte nettoyé : à trancher avant de lancer l’outil
Trois niveaux existent, et les mélanger produit des documents inutilisables. Le verbatim intégral garde tout : les « euh », les répétitions, les phrases abandonnées, les rires, les silences notés entre crochets. Le verbatim nettoyé retire ces scories mais respecte la syntaxe et les mots de la personne. La version éditée, enfin, réécrit pour la lecture, comme un entretien en questions-réponses dans un magazine.
Qui a besoin de quoi ? Une sociologue qui analyse un discours veut la transcription verbatim, hésitations comprises, parce qu’une hésitation est une donnée. L’étudiant en master demandera la convention attendue à son directeur de mémoire avant la première minute (refaire vingt entretiens parce que les annexes devaient être intégrales, c’est une semaine perdue). Le journaliste publie souvent une version éditée, mais il vérifie chaque citation entre guillemets sur le verbatim.
Les outils ont suivi. Scribe v2, le modèle d’ElevenLabs, livre une transcription verbatim par défaut et propose une option qui supprime mots de remplissage, faux départs et disfluences. Concrètement, gardez toujours la retranscription d’entretien la plus brute possible comme référence, et tirez-en la version propre. L’inverse ne marche pas : un « euh » effacé ne revient jamais.
Quel outil pour transcrire une interview ?
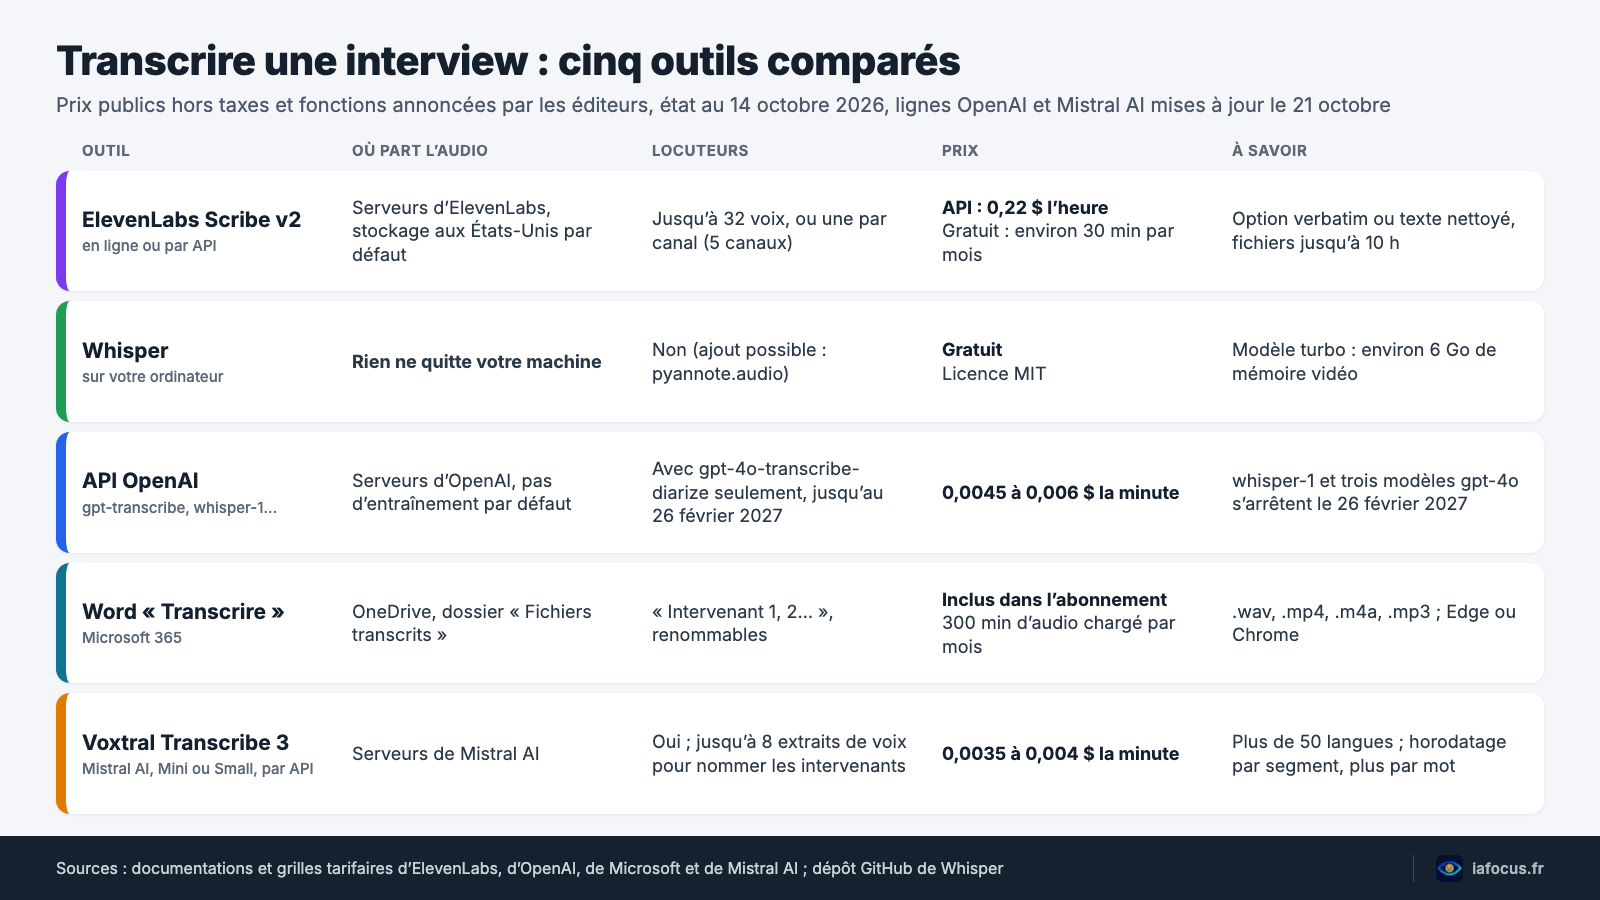
Les éditeurs annoncent tous de bons résultats sur un son propre. Ce qui les distingue : où part l’audio, qui gère les voix, combien ça coûte. Le tableau résume les offres au 14 octobre 2026 (prix hors taxes), avec deux lignes mises à jour le 21 octobre : Voxtral 3 chez Mistral AI et l’arrêt annoncé de whisper-1 chez OpenAI.
ElevenLabs Scribe v2, pour les entretiens à plusieurs voix
Scribe v2 couvre plus de 90 langues, et l’éditeur range le français dans sa meilleure catégorie (taux d’erreur sur les mots de 5 % ou moins, chiffre maison). Son identification des locuteurs distingue jusqu’à 32 voix, horodate chaque mot et accepte des fichiers de 3 Go et 10 heures. La grille de l’API affiche 0,22 dollar de l’heure. Dans l’interface web, une minute coûte 330 crédits, et le plan gratuit en donne 10 000 par mois, soit une demi-heure environ. Notre tuto ElevenLabs détaille le compte et l’interface.
Le point faible pour un entretien sensible : les données sont stockées aux États-Unis par défaut, l’hébergement européen étant réservé aux offres Entreprise, d’après la page sur la résidence des données.
Whisper, gratuit et sans rien envoyer
Whisper, publié par OpenAI sous licence MIT, transcrit hors connexion sur votre ordinateur. Le modèle « turbo », version accélérée de large-v3, demande environ 6 Go de mémoire vidéo ; les petits modèles se contentent de 1 à 2 Go, avec moins de précision. L’installation passe par Python et ffmpeg, ce qui en rebutera plus d’un. Mais pour une source sensible, rien ne sort de votre disque. Notre guide de l’IA en local sur Mac ou PC explique comment préparer la machine.
Deux limites. Whisper ne fait pas d’identification des locuteurs : il faut lui adjoindre un outil comme pyannote.audio (licence MIT, jeton Hugging Face requis). Et il lui arrive d’inventer : l’étude « Careless Whisper » (2024) relevait des phrases absentes de l’audio dans environ 1 % des transcriptions, plus souvent chez les personnes qui marquent de longues pauses.
En ligne, OpenAI facture 0,006 dollar la minute pour whisper-1 et 0,0045 pour gpt-transcribe, d’après sa grille de prix. Mais whisper-1 a désormais une date de fin : avec gpt-4o-transcribe, gpt-4o-mini-transcribe et gpt-4o-transcribe-diarize, il est déclaré obsolète et s’arrêtera le 26 février 2027, selon la documentation, qui recommande gpt-transcribe. Jusque-là, seul gpt-4o-transcribe-diarize étiquette les voix, et chaque fichier reste limité à 25 Mo. Le Whisper libre installé sur votre ordinateur n’est pas concerné : l’arrêt vise l’API.
Word « Transcrire » et Google Meet, déjà dans vos abonnements
Vous avez déjà Microsoft 365 ? Pour une retranscription d’entretien, pensez à Word : il sait transcrire un fichier audio (Accueil, Dicter, Transcrire). L’abonnement donne droit à 300 minutes d’audio chargé par mois, en .wav, .mp4, .m4a ou .mp3, dans Edge ou Chrome. Le texte arrive découpé en « Intervenant 1 », « Intervenant 2 », renommables d’un coup, avec des horodatages cliquables. L’audio est rangé dans OneDrive. Lisez aussi notre point sur l’IA dans Word, Excel et les mails.
Pour un entretien en visio, les transcriptions de Google Meet fonctionnent en français sur les éditions payantes de Workspace qui les incluent. Le fichier atterrit dans le Drive de l’organisateur, et une icône prévient tous les participants.
Voxtral de Mistral AI, l’option française
Pour transcrire une interview en français à petit prix, regardez du côté de Mistral AI. Depuis le 20 octobre 2026, la gamme Voxtral 3 prend la suite de Voxtral Mini Transcribe V2, annoncé le 4 février. D’après l’annonce de Mistral, elle compte deux modèles de transcription, en préversion publique : Voxtral Mini Transcribe 3 coûte 0,0035 dollar la minute, soit 21 centimes de dollar l’heure, et Voxtral Small Transcribe 3, le plus précis selon l’éditeur, 0,004 dollar (24 centimes l’heure). C’est toujours le moins cher des services en ligne de ce comparatif. Les deux identifient les locuteurs et couvrent plus de 50 langues, contre treize pour la V2.
Deux changements comptent pour transcrire une interview. Voxtral 3 n’horodate plus chaque mot, seulement chaque segment : un outil qui cale le texte mot à mot sur l’audio y perd. En revanche, il accepte jusqu’à huit extraits de voix de 3 à 15 secondes pour faciliter l’identification des locuteurs, et sa documentation prévoit des segments qui se chevauchent quand deux personnes parlent en même temps, là où la V2 ne transcrivait généralement qu’une seule voix. Pour comparer les conditions d’usage des données, voyez notre duel Mistral AI contre OpenAI.
Identification des locuteurs : contrôler chaque changement de voix
Un malentendu d’abord. L’identification des locuteurs (ou diarisation) répond à la question « qui parle quand ? », pas à « qui est-ce ? ». L’outil sépare des voix et les numérote ; à vous d’écrire, dès l’ouverture du fichier, que « speaker_1 » est la maire de la commune.
Les ratés se ressemblent d’un outil à l’autre. Les paroles qui se chevauchent passent à la trappe ou tombent chez la mauvaise personne. Les relances (« oui », « d’accord ») se collent au bloc voisin. Deux voix proches finissent parfois fusionnées, et la personne interviewée se met soudain à poser les questions.
Pour transcrire une interview à plusieurs voix, la parade la plus sûre reste matérielle : un canal par micro. À défaut, vérifiez chaque changement d’intervenant sur les cinq premières minutes, puis cherchez les blocs anormalement longs. Certaines API acceptent des échantillons de voix, jusqu’à quatre extraits de 2 à 10 secondes chez OpenAI (avec gpt-4o-transcribe-diarize, jusqu’en février 2027) et huit de 3 à 15 secondes avec Voxtral 3. Utile pour une table ronde ; pour un tête-à-tête, renommer deux intervenants prend une minute.
Relire la transcription contre l’audio, sans exception
Transcrire une interview avec l’IA ne dispense jamais de la relire. Le texte sort fluide, ponctué, plausible. C’est ce qui le rend traître : une erreur bien tournée ne saute pas aux yeux. Relisez avec l’audio dans les oreilles, à vitesse 1,25 ou 1,5, ligne à ligne. Pour une émission diffusée, la méthode change à la publication : voyez comment transcrire un podcast et livrer un fichier SRT ou WebVTT.
Où regarder ? Les noms propres et les chiffres. Puis les négations, parce qu’un « pas » avalé inverse le sens d’une phrase. Les termes techniques. Et les passages qui suivent un long silence, là où Whisper, au moins, a tendance à combler le vide. Chaque doute se marque avec son horodatage, sur le modèle [inaudible 00:14:32], plutôt qu’en devinant.
Pour un journaliste, toute phrase citée se réécoute en entier, avec ce qui la précède. Si vous avez promis une relecture à la personne interviewée, envoyez la version éditée, pas la transcription verbatim et ses hésitations.
Dernier piège : faire résumer une retranscription d’entretien par un chatbot avant de l’avoir corrigée. Le résumé hérite des erreurs et les rend invisibles. Les outils pour résumer un texte avec l’IA font gagner du temps, mais sur un texte vérifié.
Données personnelles : ce que le RGPD impose à vos enregistrements
Transcrire une interview, c’est traiter des données personnelles : une voix associée à un nom en est une. Et un entretien en contient souvent de plus délicates (opinions politiques, santé, convictions religieuses), que l’article 9 du RGPD range parmi les catégories particulières, interdites de traitement sauf exception, comme le consentement explicite.
Envoyer l’audio à un service en ligne revient à confier ces données à un sous-traitant. L’article 28 exige des garanties suffisantes et un contrat écrit qui fixe l’objet, la durée et la finalité du traitement. Vérifiez où l’audio est stocké. OpenAI indique ne pas entraîner ses modèles sur les données de son API, sauf accord explicite (page sur les données). ElevenLabs stocke par défaut aux États-Unis, Word range tout dans OneDrive. Pour une source à protéger, Whisper en local règle la question.
Vient la durée de conservation. La CNIL demande de la fixer avant de commencer, puis de supprimer ou d’anonymiser une fois l’objectif atteint ; la recherche peut conserver plus longtemps avec des mesures de protection (fiche de la CNIL). Attention au vocabulaire : remplacer les noms par des codes, c’est de la pseudonymisation, et ces données restent des données personnelles. Une vraie anonymisation suppose souvent d’effacer la voix et les détails qui trahissent quelqu’un.
Les journalistes ont un régime à part : l’article 80 de la loi Informatique et Libertés écarte plusieurs règles, dont l’information des personnes, les droits d’accès et de rectification, la limitation de la conservation et l’encadrement des transferts hors de l’Union. Cela vaut pour le journalisme professionnel exercé selon sa déontologie, quand c’est nécessaire pour concilier protection des données et liberté d’expression. Le droit à l’effacement et le Code pénal continuent de s’appliquer. Et le secret des sources, protégé par la loi de 1881, plaide pour garder chez soi la voix d’une source anonyme.
Étudiants et chercheurs, consultez le délégué à la protection des données (DPO) de votre établissement avant le premier entretien. Dans ses recommandations d’août 2026 sur les outils collaboratifs du supérieur, la CNIL demande de vérifier les garanties du prestataire, de signer un contrat conforme et d’encadrer les transferts hors de l’Union.
Trois méthodes selon votre profil
Journaliste avec une source sensible : enregistreur dédié, Whisper en local, réécoute de chaque citation, suppression de l’audio selon la règle de votre rédaction.
Étudiant en mémoire : feu vert du DPO, consentement enregistré, Word ou l’outil de l’université, transcription verbatim si votre directeur l’exige, et des codes à la place des noms dans les annexes.
Chercheuse avec vingt entretiens : deux micros, une retranscription d’entretien par Scribe v2 ou Voxtral si le contrat le permet (sinon Whisper et pyannote.audio), un protocole de pseudonymisation validé par le DPO, une durée de conservation fixée d’avance. Plus long à préparer qu’à transcrire. Normal.
Foire aux questions
Combien de temps faut-il pour transcrire une interview d’une heure ?
La partie automatique est la plus courte. C’est la relecture qui prend du temps : comptez au minimum la durée de l’enregistrement, davantage si le son est médiocre ou si plusieurs personnes parlent en même temps. Une retranscription d’entretien destinée à l’analyse demande aussi plus de soin qu’une version éditée.
Whisper sait-il reconnaître qui parle ?
Non, pas tout seul. Whisper produit le texte et les horodatages, sans étiqueter les voix. Il faut l’associer à un outil d’identification des locuteurs comme pyannote.audio, ou choisir un service qui le fait nativement : Scribe v2, Voxtral, Word « Transcrire » ou gpt-4o-transcribe-diarize chez OpenAI, jusqu’au 26 février 2027.
Faut-il un consentement écrit pour enregistrer un entretien ?
Le Code pénal exige le consentement de la personne pour enregistrer des paroles privées ou confidentielles, et le présume quand l’enregistrement se fait à sa vue sans opposition. L’article n’impose pas l’écrit, mais mieux vaut pouvoir prouver l’accord : un consentement oral enregistré au début du fichier, ou un formulaire signé pour une recherche.
Peut-on transcrire une interview gratuitement ?
Oui. Whisper, sous licence MIT, ne coûte rien sur votre ordinateur. Le plan gratuit d’ElevenLabs couvre environ une demi-heure par mois, et Word « Transcrire » est inclus dans Microsoft 365, dans la limite de 300 minutes d’audio chargé par mois. Au-delà, les API coûtent quelques dizaines de centimes de dollar l’heure.
Sources
- Code pénal, article 226-1 (atteinte à l’intimité de la vie privée), Légifrance
- Loi n° 78-17 du 6 janvier 1978 (Informatique et Libertés), article 80, Légifrance
- Loi du 29 juillet 1881 sur la liberté de la presse, article 2 (secret des sources), Légifrance
- Règlement (UE) 2016/679 (RGPD), articles 5, 9, 28 et 89, EUR-Lex
- CNIL, Recherche scientifique (hors santé) : les durées de conservation des données
- CNIL, Recherche scientifique (hors santé) : anonymisation et pseudonymisation
- CNIL, Enseignement supérieur : bonnes pratiques pour les outils collaboratifs en ligne (24 août 2026)
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.