Ce tuto ElevenLabs en quelques lignes : Eleven v3 est le modèle le plus expressif (plus de 70 langues, dont le français), Multilingual v2 le plus régulier sur les textes longs. En gratuit, vous disposez de 10 000 crédits par mois, soit une dizaine de minutes d’audio, sans usage commercial. Licence commerciale et clonage instantané ? Dès l’offre Starter, à 6 $ par mois hors taxes. Le clonage professionnel de votre propre voix, lui, demande l’offre Creator et au moins 30 minutes d’enregistrement.
ElevenLabs transforme un texte en voix de synthèse d’un réalisme saisissant. Mais le résultat dépend de trois choix que beaucoup de débutants font au hasard : la voix, le modèle et les réglages. Prenez une voix anglaise, et votre texte français sera lu avec un accent. Réglez mal la stabilité, la narration deviendra monotone ou instable. Et avec le plan gratuit, aucune vidéo n’est monétisable.
De l’inscription au fichier audio, ce tuto ElevenLabs vous guide pas à pas, avec les noms exacts des modèles et des réglages disponibles en septembre 2026. On y aborde aussi le clonage de votre propre voix et les règles à respecter avant de publier une voix de synthèse : consentement, AI Act, mentions exigées par les plateformes.
- Tuto ElevenLabs : offres, crédits et licence
- Tuto ElevenLabs en 7 étapes : du texte au fichier audio
- Cloner sa voix : clonage instantané ou professionnel
- Voix de synthèse et droit : ce qu’il faut respecter
- Au-delà de la voix off : livres audio, doublage et agents
Tuto ElevenLabs : offres, crédits et licence
Premier réflexe de ce tuto ElevenLabs : comprendre le système de crédits. Sur le site, un caractère de texte coûte un crédit, quel que soit le modèle de synthèse vocale, mais certaines voix de la bibliothèque appliquent un multiplicateur. Les crédits sont débités à chaque génération, pas au téléchargement. Autrement dit, chaque essai compte.
| Offre | Prix mensuel (HT) | Crédits par mois | Ce qu’elle débloque |
|---|---|---|---|
| Gratuite | 0 $ | 10 000 (environ 10 min) | Eleven v3, 3 voix personnalisées, MP3 128 kbps ; ni usage commercial ni clonage |
| Starter | 6 $ (5 $ en annuel) | 30 000 (environ 30 min) | Licence commerciale, clonage instantané |
| Creator | 22 $ | 121 000 (environ 2 h) | Clonage professionnel de sa propre voix |
| Pro | 99 $ | 600 000 (environ 10 h) | WAV et PCM en 44,1 kHz, exports Studio en 192 kbps |
Tarifs relevés sur elevenlabs.io le 26 septembre 2026, en dollars et hors taxes (le site n’affiche aucun prix en euros). Sur un abonnement payant, les crédits inutilisés se reportent jusqu’à deux mois. Ceux du plan gratuit, jamais.
La licence, c’est le point le plus mal compris. En gratuit, tout usage commercial est interdit et une publication doit mentionner « elevenlabs.io » ou « 11.ai » dans son titre. Surtout (et c’est là le piège), un contenu généré sans abonnement payant ne pourra jamais être exploité commercialement, même si vous vous abonnez plus tard. En revanche, ce que vous produisez pendant un abonnement reste exploitable sans limite de durée.
Payer ne règle pas tout pour autant. L’abonnement vous donne une licence sur les sorties d’ElevenLabs, pas les droits sur le texte lu ni sur la voix d’autrui. Et faire lire par une IA le livre d’un auteur sans son accord reste une reproduction illicite au sens de l’article L122-4 du Code de la propriété intellectuelle.
Tuto ElevenLabs en 7 étapes : du texte au fichier audio
La méthode complète se déroule sur le site, dans l’outil Text to Speech de l’espace ElevenCreative. Pour suivre ce tuto ElevenLabs de bout en bout, le plan gratuit suffit. Seule exception : le clonage.
Étape 1 : créer un compte et vérifier son plan
Inscrivez-vous sur elevenlabs.io. Pour tester, le plan gratuit et ses 10 000 crédits mensuels suffisent. Un piège, quand même : si votre adresse IP est partagée (derrière un VPN ou un réseau d’entreprise, par exemple), la détection d’abus peut bloquer l’usage gratuit. Vous verrez alors s’afficher le message « Unusual activity detected ».
Étape 2 : choisir une voix de synthèse dans la bibliothèque
Direction Voices, puis Explore. Vous voilà dans la Voice Library, une place de marché qui annonce plus de 10 000 voix de synthèse, partagées par leurs propriétaires, qui sont rémunérés à l’usage. Filtrez par langue, accent, genre, âge et catégorie d’usage, puis triez par tendance ou par nombre d’utilisateurs. Écouter les aperçus ne coûte rien.
Le choix de la voix compte plus que tout le reste. Selon ElevenLabs, la voix passe avant le modèle, qui passe avant les réglages. Pour un texte français, prenez une voix de synthèse native française : l’accent vient de la voix. Le bouton Use voice ouvre la synthèse avec elle, le bouton + l’ajoute à My Voices sans occuper d’emplacement. Pour comparer avec d’autres outils, voyez notre sélection de générateurs de voix IA.
Autre option : Voice Design, qui crée une voix de synthèse à partir d’une description. Chaque génération donne trois propositions, et seul le texte d’aperçu est facturé. Dans la description, commencez par la langue, par exemple « Native French », puis le genre, l’âge et le ton recherché.
Étape 3 : choisir le bon modèle
En septembre 2026, ElevenLabs propose quatre modèles de voix de synthèse. Oubliez le « Multilingual v3 » que répètent de nombreux tutoriels : il n’existe pas. Le modèle expressif s’appelle Eleven v3, sorti de sa phase de test le 2 février 2026. Leurs caractéristiques figurent dans la documentation officielle des modèles.
| Modèle | Langues | Points forts | Limites |
|---|---|---|---|
| Eleven v3 | Plus de 70 (74) | Le plus expressif, balises audio, dialogues à plusieurs voix | Pas de balise de pause, pas conçu pour le temps réel |
| Multilingual v2 | 29 | Le plus stable sur les textes longs, modèle par défaut de l’API | Moins expressif |
| Flash v2.5 | 32 | Environ 75 ms de latence, moins cher via l’API | Pensé pour la vitesse plus que pour le jeu |
| Eleven v3 Conversational | Plus de 70 | Temps réel expressif, environ 280 ms | Réservé aux agents vocaux |
Concrètement : Eleven v3 pour une voix off vivante, une publicité ou un dialogue. Multilingual v2 pour une narration longue et régulière, livre audio compris. Flash v2.5 si vous intégrez la voix dans une application. Petite réserve : les clones professionnels ne sont pas entièrement calibrés pour Eleven v3, donc avec votre propre clone, essayez d’abord Multilingual v2.
Étape 4 : préparer le texte
Collez votre texte, dans la limite de 2 500 caractères par génération en gratuit (5 000 avec un abonnement). Comme la langue est détectée automatiquement, n’en mélangez pas plusieurs dans un même texte. Écrivez les nombres, les dates, les symboles et les acronymes comme ils doivent être prononcés. Les emojis, eux, sont à bannir. Pour écrire pour l’oreille, inspirez-vous de notre méthode de script vidéo IA.
Côté pauses, tout dépend du modèle. Avec Multilingual v2 et Flash, la balise <break time="1.5s" /> insère un silence de 3 secondes au plus. Mais n’en abusez pas : trop de balises dans une même génération rendent la voix instable. Eleven v3, lui, ignore cette balise. On y joue sur la ponctuation, les points de suspension et les majuscules, qui renforcent l’accentuation.
Eleven v3 comprend aussi des balises audio entre crochets, écrites en anglais : [whispers] pour chuchoter, [laughs] pour rire, [sighs] pour soupirer, [excited] ou [sarcastic] pour le ton. Le bouton Enhance les ajoute automatiquement. Mais la documentation ne les montre qu’en anglais. Testez donc leur effet sur un texte français et gardez-les cohérentes avec la voix choisie (une voix qui crie chuchotera mal). Toutes ces astuces sont réunies dans le guide des bonnes pratiques d’ElevenLabs.
Étape 5 : régler la voix de synthèse
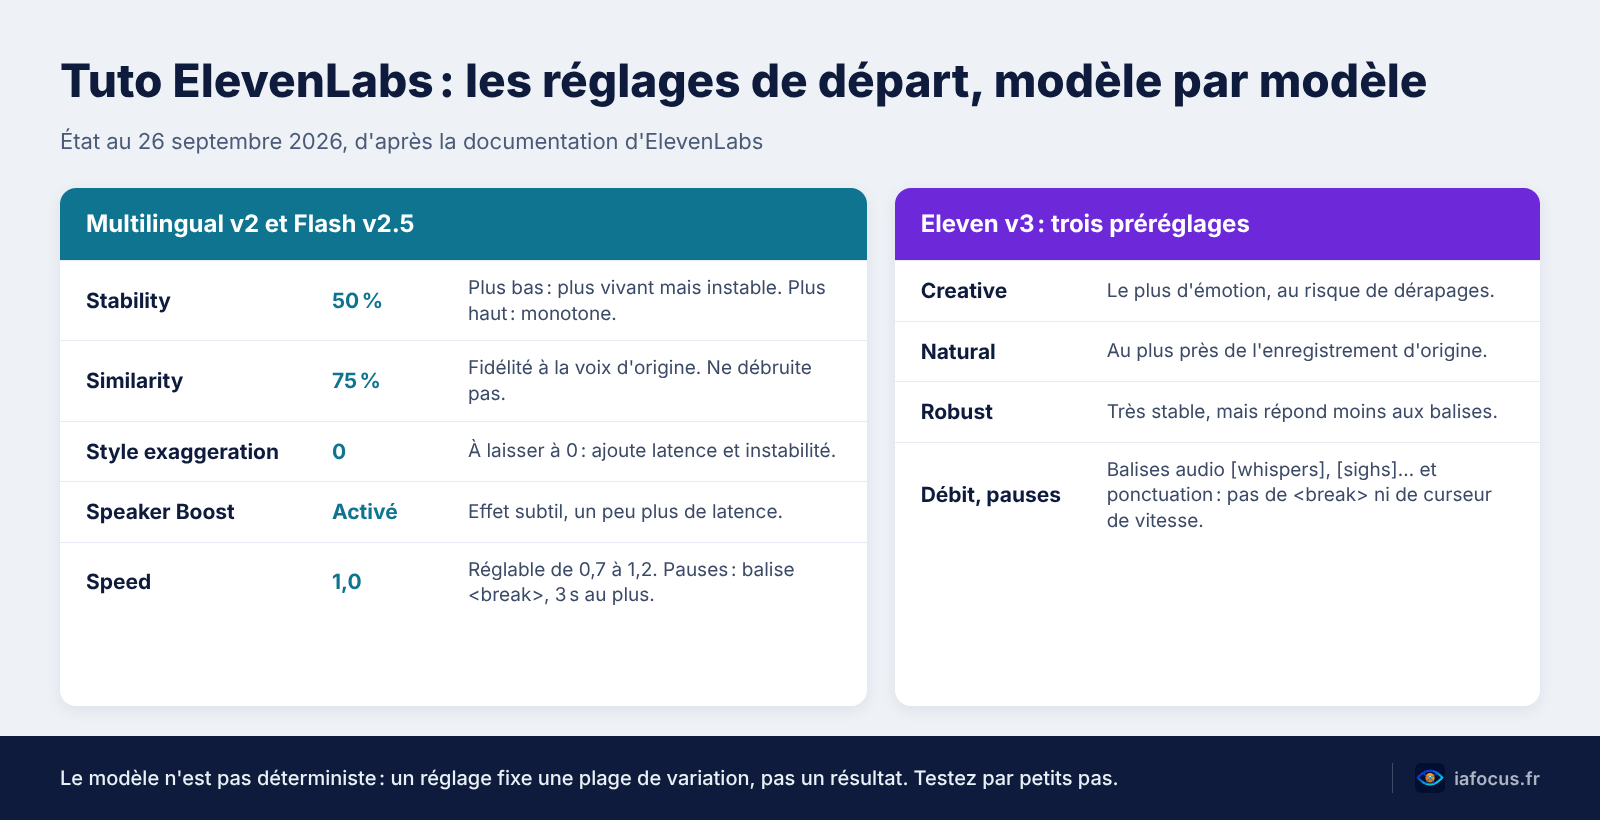
Sur Multilingual v2 et Flash, la voix de synthèse se façonne avec cinq réglages : Stability, Similarity, Style exaggeration, Speaker Boost et Speed. Par défaut, ElevenLabs part de 50 % de stabilité, 75 % de similarité et d’un style à 0, avec Speaker Boost activé et une vitesse de 1,0, réglable de 0,7 à 1,2.
La stabilité règle la variabilité. Trop basse, la voix de synthèse devient erratique. Trop haute, elle devient monotone. Baissez-la pour une lecture vivante, montez-la pour un ton sérieux. La similarité, l’ancien curseur « Clarity + Similarity Enhancement », règle la fidélité à la voix d’origine, et elle ne débruite rien : une valeur haute peut même reproduire le bruit d’un échantillon médiocre. Quant à l’exagération du style, ElevenLabs conseille de la laisser à 0, car elle ajoute de la latence et de l’instabilité.
Eleven v3 fonctionne autrement : un seul curseur de stabilité, en trois préréglages. Creative donne le plus d’émotion, au risque de dérapages. Natural reste au plus près de l’enregistrement d’origine. Robust est très stable, mais répond moins aux balises. Sur ce modèle, le débit se règle par les balises audio, pas par un curseur de vitesse.
Gardez en tête que le modèle n’est pas déterministe. Les mêmes réglages ne donnent jamais deux fois exactement le même rendu. Un curseur fixe une plage de variation, pas un résultat. Procédez donc par petits essais successifs.
Étape 6 : générer, réécouter, corriger la prononciation
Avant la génération, le nombre de crédits s’affiche. Bonne nouvelle : vous avez droit à deux regénérations gratuites, à condition de ne changer ni le texte, ni la voix, ni le modèle, dans les deux heures et sans recharger la page. Seuls les curseurs peuvent bouger. Toutes vos prises restent dans l’onglet History, où vous pouvez les réécouter et les télécharger.
Un nom propre mal prononcé ? Eleven v3 lit l’alphabet phonétique international (IPA en anglais), écrit entre barres obliques directement dans le texte. ElevenLabs annonce une cohérence de 80 à 90 %, pas une fiabilité totale. Quant aux balises SSML <phoneme>, elles ne fonctionnent qu’avec Flash v2, un modèle anglais : en français, elles ne servent à rien.
Autre outil, les dictionnaires de prononciation au format .pls : ils permettent des alias (c’est-à-dire des remplacements d’orthographe) dans Studio et via l’API. En dernier recours, réécrivez le mot comme il se prononce. Pour un sigle ou une marque, c’est souvent la méthode la plus rapide.
Étape 7 : télécharger et publier
Une fois l’audio généré, téléchargez le MP3 à 128 kbps ou le WAV. Le menu Advanced ajoute le MP3 à 192 et 256 kbps, le M4A et le FLAC. Mais attention : sur les offres Gratuite, Starter et Creator, la source reste à 128 kbps, et un WAV n’est qu’une conversion. Le vrai WAV ou PCM en 44,1 kHz commence avec l’offre Pro. L’API, elle, ne propose pas le FLAC.
Au-delà de quelques milliers de caractères, passez à Studio, l’ancien outil Projects. Vous y trouverez les chapitres, la regénération d’un seul paragraphe ou de quelques mots, la normalisation du volume à l’export. Pour habiller votre voix off, ajoutez un bruitage IA ou un fond musical.
Envie de voir l’interface en mouvement ? Ce tutoriel vidéo en français de la chaîne Mister G montre les bases. Il date toutefois de mars 2025 : depuis, les modèles et certains noms de réglages ont changé, alors fiez-vous aux étapes ci-dessus.
Cloner sa voix : clonage instantané ou professionnel
Pour créer une voix de synthèse à partir de votre propre voix, ElevenLabs propose deux façons de faire. Aucune n’est accessible en gratuit. Le choix dépend du temps d’enregistrement dont vous disposez et de l’usage visé.
Le clonage instantané, dès l’offre Starter
Le clonage instantané (Instant Voice Cloning) n’entraîne aucun modèle : il s’appuie sur ce que le système connaît déjà. Une à deux minutes d’audio propre suffisent. Au-delà de trois minutes, le gain est faible, parfois négatif, donc inutile d’en faire trop. Vous devez confirmer que vous disposez des droits et du consentement nécessaires. La voix de synthèse clonée est prête presque immédiatement, mais elle peut mal restituer les accents rares.
Le clonage professionnel, dès l’offre Creator
Le clonage professionnel (Professional Voice Cloning) affine un modèle dédié. Il demande au moins 30 minutes d’enregistrement, de préférence deux à trois heures, et ne vaut que pour votre propre voix : même avec l’accord d’un tiers, impossible de cloner la sienne. Une vérification vous fait lire des phrases à voix haute. En cas d’échec, un nouvel essai est possible 24 heures plus tard. L’entraînement prend ensuite trois à six heures.
Pour l’enregistrement, ElevenLabs conseille un micro XLR (par exemple un AT2020 ou un Rode NT1 relié à une interface audio), un filtre anti-pop à environ deux poings de la bouche et une pièce assourdie : une couette peut suffire. Visez un niveau moyen de -23 à -18 dB RMS, avec des crêtes sous -3 dB. Et gardez un ton et un rythme constants, car un clone professionnel apprend un seul style.
Les usages et le cadre légal du clonage vous intéressent ? Notre dossier sur le clonage de voix IA va plus loin.
Voix de synthèse et droit : ce qu’il faut respecter
Dès que vous publiez une voix de synthèse, votre responsabilité est engagée, surtout si elle imite une personne réelle. En France, la Cour de cassation a jugé le 24 juin 2026 que la voix, « à l’instar de son image », compte parmi les attributs principaux de la personnalité, protégée dans les mêmes conditions que l’image (1re chambre civile, n° 25-20.483).
Le Code pénal réprime aussi l’hypertrucage. Diffuser, sans le consentement de la personne, un contenu sonore généré par algorithme qui reproduit ses paroles, sans que sa nature artificielle soit évidente ou signalée, vous expose à un an de prison et 15 000 € d’amende, deux ans et 45 000 € en ligne (article 226-8). Pour repérer ces montages, voyez notre guide pour détecter les deepfakes.
Dans l’Union européenne, l’article 50 de l’AI Act s’applique depuis le 2 août 2026. Le déployeur, c’est-à-dire le professionnel qui utilise l’outil, doit indiquer qu’un hypertrucage audio a été généré ou manipulé par une IA, au plus tard lors de la première exposition du public. Le règlement (UE) 2026/1744 laisse aux fournisseurs déjà présents sur le marché jusqu’au 2 décembre 2026 pour le marquage technique, mais il ne repousse pas cette obligation. Le calendrier ? Notre point sur l’AI Act 2026 le détaille.
Côté plateformes, YouTube impose de déclarer un contenu réaliste généré par IA (faire dire à une personne réelle ce qu’elle n’a pas dit, par exemple). Une simple voix off réalisée avec le clone de sa propre voix, en revanche, n’a pas à l’être. Audible, via ACX, refuse la narration par IA non autorisée depuis le 15 avril 2026.
Les garde-fous d’ElevenLabs
La politique d’usage d’ElevenLabs interdit de reproduire la voix d’autrui sans consentement, de tromper sur l’origine artificielle d’une voix et d’imiter des candidats ou des élus, même avec leur accord. Concrètement, les voix de personnalités publiques sont bloquées et chaque voix de synthèse générée peut être reliée au compte qui l’a produite. Les fichiers générés portent en plus un filigrane inaudible, que l’outil gratuit Audio Detector permet de repérer.
Enfin, un mot sur les conditions d’utilisation du 31 mars 2026 : elles vous laissent vos droits sur vos contenus, mais accordent à ElevenLabs une licence perpétuelle sur eux, voix comprise, pour fournir et améliorer ses services. Vous ne voulez pas que vos données servent à l’entraînement ? Refusez-le dans les réglages, rubrique Data use. Pour une entreprise, la marche à suivre pour le consentement est détaillée dans notre article sur la voix de marque IA.
Au-delà de la voix off : livres audio, doublage et agents
Pour un livre audio lu par une voix de synthèse, direction l’outil Audiobooks : il importe un fichier EPUB ou PDF, attribue des voix aux personnages et publie vers ElevenReader, Spotify ou InAudio. ElevenLabs y recommande Multilingual v2 en qualité Studio. Sur Spotify, une mention signalant la voix de synthèse est ajoutée à la description.
Le doublage traduit une vidéo dans plus de 90 langues en conservant le timbre des intervenants. En gratuit, les fichiers sont filigranés. Pour ce qui se joue côté comédiens, lisez notre article sur le doublage vocal IA.
ElevenAgents (l’ancienne Conversational AI) sert à construire des agents vocaux. Son mode expressif repose sur Eleven v3 Conversational. Une règle à ne pas oublier : l’utilisateur doit être prévenu qu’il parle à une IA. Pour concevoir un assistant sans programmer, voyez comment créer un agent IA personnalisé.
Enfin, Studio 4.0, lancé le 21 septembre 2026, intègre un éditeur vidéo qui génère voix, musique, bruitages et images directement sur la timeline. Si vous ajoutez de la musique à vos vidéos, vérifiez avant de monétiser les règles de la création musicale IA.
De ce tuto ElevenLabs, retenez surtout ceci : une voix native française, le bon modèle pour votre usage, des réglages par défaut ajustés pas à pas et la bonne licence avant toute publication commerciale. Une voix de synthèse réussie se construit par essais successifs. Et une voix de synthèse qui imite une personne réelle se signale, toujours.
FAQ
Ce tuto ElevenLabs fonctionne-t-il avec le plan gratuit ?
Oui, sauf pour le clonage. Le plan gratuit offre 10 000 crédits par mois, soit une dizaine de minutes d’audio, avec Eleven v3 et 2 500 caractères par génération. Pas d’usage commercial, en revanche, et une publication doit mentionner « elevenlabs.io » ou « 11.ai » dans son titre.
Quel modèle ElevenLabs choisir pour une voix de synthèse en français ?
Eleven v3 si vous voulez une voix expressive, avec plus de 70 langues. Multilingual v2 pour une narration longue et régulière, avec 29 langues. Flash v2.5 pour une faible latence via l’API. Et le « Multilingual v3 » ? Il n’existe pas.
Combien de minutes d’audio pour cloner sa voix ?
Pour un clonage instantané, dès l’offre Starter : une à deux minutes. Pour un clonage professionnel, dès l’offre Creator et uniquement pour votre propre voix : au moins 30 minutes, de préférence deux à trois heures.
Quels formats d’export propose ElevenLabs ?
Depuis l’historique, le MP3 à 128 kbps ou le WAV. Dans le menu Advanced, en plus, le MP3 à 192 et 256 kbps, le M4A et le FLAC. Attention, avant l’offre Pro, la source reste à 128 kbps. Via l’API, vous aurez MP3, WAV, PCM, Opus, µ-law et A-law, mais pas de FLAC.
Faut-il signaler une voix de synthèse ?
Oui, dès qu’elle constitue un hypertrucage. L’article 50 de l’AI Act l’impose aux déployeurs depuis le 2 août 2026, et le Code pénal punit la diffusion non consentie des paroles d’une personne générées par IA. Du côté de YouTube, une déclaration est exigée pour les contenus réalistes, pas pour une voix off faite avec le clone de sa propre voix.
Comment corriger la prononciation d’un mot ?
Sur Eleven v3, écrivez sa transcription en alphabet phonétique international, entre barres obliques. Sur les autres modèles, passez par un dictionnaire de prononciation avec des alias. Ou réécrivez le mot comme il se prononce.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.