Transcrire un podcast n’a jamais été aussi simple, et c’est justement là que le bât blesse. Depuis le 5 mars 2024, Apple Podcasts transcrit seul les nouveaux épisodes en français. Le texte s’affiche dans l’application avec la mention « Générée automatiquement », noms des invités compris, bien ou mal orthographiés. Si votre émission est référencée chez Apple, elle a donc déjà un texte public. Reste à savoir si vous voulez en être l’auteur.
Ce tutoriel suit cinq étapes, du fichier exporté au flux RSS : choisir entre Voxtral (Mistral AI), Whisper (OpenAI) et Scribe (ElevenLabs), corriger les noms propres, livrer un fichier SRT ou WebVTT, le déclarer dans le flux. Puis deux sujets qu’on oublie volontiers : l’accessibilité et le RGPD des invités. Pour un entretien destiné à être cité, voyez plutôt notre guide pour transcrire une interview avec l’IA.
Transcrire un podcast quand Apple le fait déjà : pourquoi s’embêter ?
La transcription Apple Podcasts couvre aujourd’hui onze langues, dont le français, sur iOS 17.4 et les versions suivantes, dans plus de 170 pays et régions. Le texte défile pendant l’écoute, chaque mot est mis en évidence au passage, et un appui sur une phrase relance l’audio à cet endroit. Pour l’auditeur, c’est confortable. Pour vous, c’est gratuit.
Les limites, maintenant. Apple ne transcrit que les épisodes de son catalogue : un flux privé n’y a pas droit. Les passages insérés dynamiquement (publicités, annonces) disparaissent du texte s’ils ont changé depuis la première transcription. Et le texte reste chez Apple : ni sur votre site, ni dans les autres applications d’écoute.
Il y a surtout l’orthographe des noms. Apple conseille lui-même de citer l’animateur et les invités dans les descriptions de l’émission et de l’épisode pour qu’ils soient bien écrits. La machine devine : un nom breton comme Kerjean peut très bien sortir en « Querjean ». Or si vous fournissez votre propre fichier, la transcription Apple Podcasts affiche « Fournie par » suivi du nom de votre émission. Vous signez le texte. Autant qu’il soit juste.
Étape 1 : partir du fichier publié, pas des rushes
Pour transcrire un podcast, partez du mixage final, celui que reçoivent les auditeurs. La raison est mécanique. Un fichier de sous-titres associe chaque phrase à un horodatage ; si vous transcrivez une version plus longue que l’épisode publié, tout se décale dès la première coupe. Et les passages retirés au montage (la confidence lâchée hors micro, la digression supprimée à la demande d’un invité) n’ont rien à faire dans un texte public.
Deux exceptions utiles. Si chaque voix a été enregistrée sur sa propre piste, gardez aussi une version multipiste : Scribe, chez ElevenLabs, traite jusqu’à cinq canaux séparément et attribue un locuteur à chacun. Et si votre émission pose de la musique sous les voix, un export « voix seules » calé sur la même durée aidera le moteur. Apple prévient d’ailleurs que les échanges qui se chevauchent et la musique forte compliquent la transcription.
Étape 2 : choisir son outil de transcription podcast
Quatre options tiennent la route en octobre 2026. Aucune ne coûte cher : de 0,21 à 0,27 dollar l’heure d’audio pour les services payants (hors taxes, au 21 octobre 2026), rien pour les deux autres. Le choix d’un outil de transcription podcast se joue ailleurs. Où part l’audio, qui reconnaît les voix, quel fichier sort à la fin ? Pour un panorama orienté montage, voyez notre comparatif des outils de transcription IA ; pour les réunions, notre test des IA de prise de notes.
Voxtral Transcribe 3, la nouveauté française
Mistral AI a présenté le 20 octobre 2026 sa famille Voxtral 3. Deux modèles comptent : Voxtral Mini Transcribe 3, à 0,0035 dollar la minute (0,21 dollar l’heure), et Voxtral Small Transcribe 3, à 0,004 dollar (0,24 dollar l’heure). Tous deux couvrent 50 langues, reconnaissent les locuteurs et acceptent un vocabulaire imposé. Mistral dit le Small meilleur que Whisper et Scribe v2 sur ses tests : à vérifier sur vos épisodes. L’API dispose d’un point d’accès hébergé en Europe.
Le revers ? Selon la documentation de Mistral, les horodatages sont donnés par segment (pas par mot) et la réponse arrive en JSON, pas en sous-titres : prévoyez un petit script de conversion. Pour comparer les deux éditeurs au-delà de l’audio, lisez notre duel Mistral AI contre OpenAI.
Whisper, gratuit et local
Whisper reste l’option de ceux qui ne veulent rien envoyer nulle part. OpenAI publie le code et les poids sous licence MIT ; le modèle par défaut, turbo, demande environ 6 Go de mémoire vidéo, plus l’outil ffmpeg. Son atout : la ligne de commande écrit directement des sous-titres SRT et VTT (option --output_format). Son défaut : Whisper ne sait pas qui parle. Pour un monologue, aucune importance ; pour une table ronde à quatre, bon courage. Notre guide de l’IA en local aide à choisir la machine.
Ne confondez pas l’outil libre et l’API : chez OpenAI, whisper-1 est déclaré obsolète et sera coupé le 26 février 2027, selon la documentation de l’API, qui recommande gpt-transcribe (0,0045 dollar la minute).
ElevenLabs Scribe v2, le plus outillé
Scribe v2 coûte 0,22 dollar l’heure par l’API, reconnaît plus de 90 langues et distingue jusqu’à 32 voix dans un même fichier. Il accepte jusqu’à 1 000 termes de vocabulaire imposé (0,05 dollar de plus par heure), retire sur demande les « euh » et les faux départs (mode « no verbatim ») et exporte un fichier SRT. Un point à peser : les données sont stockées aux États-Unis par défaut, la résidence européenne étant réservée aux comptes Entreprise. Déjà client pour vos voix de synthèse ? Le compte est le même.
Le raccourci : partir de la transcription d’Apple
Méthode peu connue, et gratuite : Apple Podcasts Connect permet de télécharger la transcription générée pour chaque épisode. Vous la corrigez, la mettez en ligne, puis la liez dans votre flux RSS. Pour une émission déjà diffusée chez Apple, c’est souvent le chemin le plus court vers une transcription podcast propre.
Étape 3 : corriger les noms propres, puis tout relire
Les erreurs d’une transcription automatique se concentrent presque toujours au même endroit : noms propres, marques, sigles, chiffres. D’où une règle simple : donnez les noms à l’outil avant de lancer la transcription, plutôt que de les corriger après.
Chaque outil a son levier. Voxtral prend un champ context_bias : une entrée par nom ou par terme, ou une phrase qui décrit l’enregistrement (par exemple « Brut de Pomme, avec la cidricultrice Anne Kerjean »). Scribe prend une liste de keyterms. Whisper accepte une amorce de texte, l’option --initial_prompt. Apple, lui, lit vos descriptions d’épisode. Une liste préparée une fois par saison sert aux quatre.
Vient la relecture. Elle n’est pas négociable, franchement. Écoutez l’épisode en suivant le texte, en accéléré si votre oreille suit, et vérifiez d’abord les citations, les chiffres et chaque changement de voix. Un nettoyage léger (sans les « euh » ni les reprises) se lit mieux que le verbatim, à condition de ne jamais toucher au sens d’une phrase.
Côté Apple, aucune indulgence : un fichier truffé de fautes, ou qui saute un segment de l’épisode, n’est tout simplement pas affiché.
Étape 4 : fichier SRT ou WebVTT, lequel livrer ?
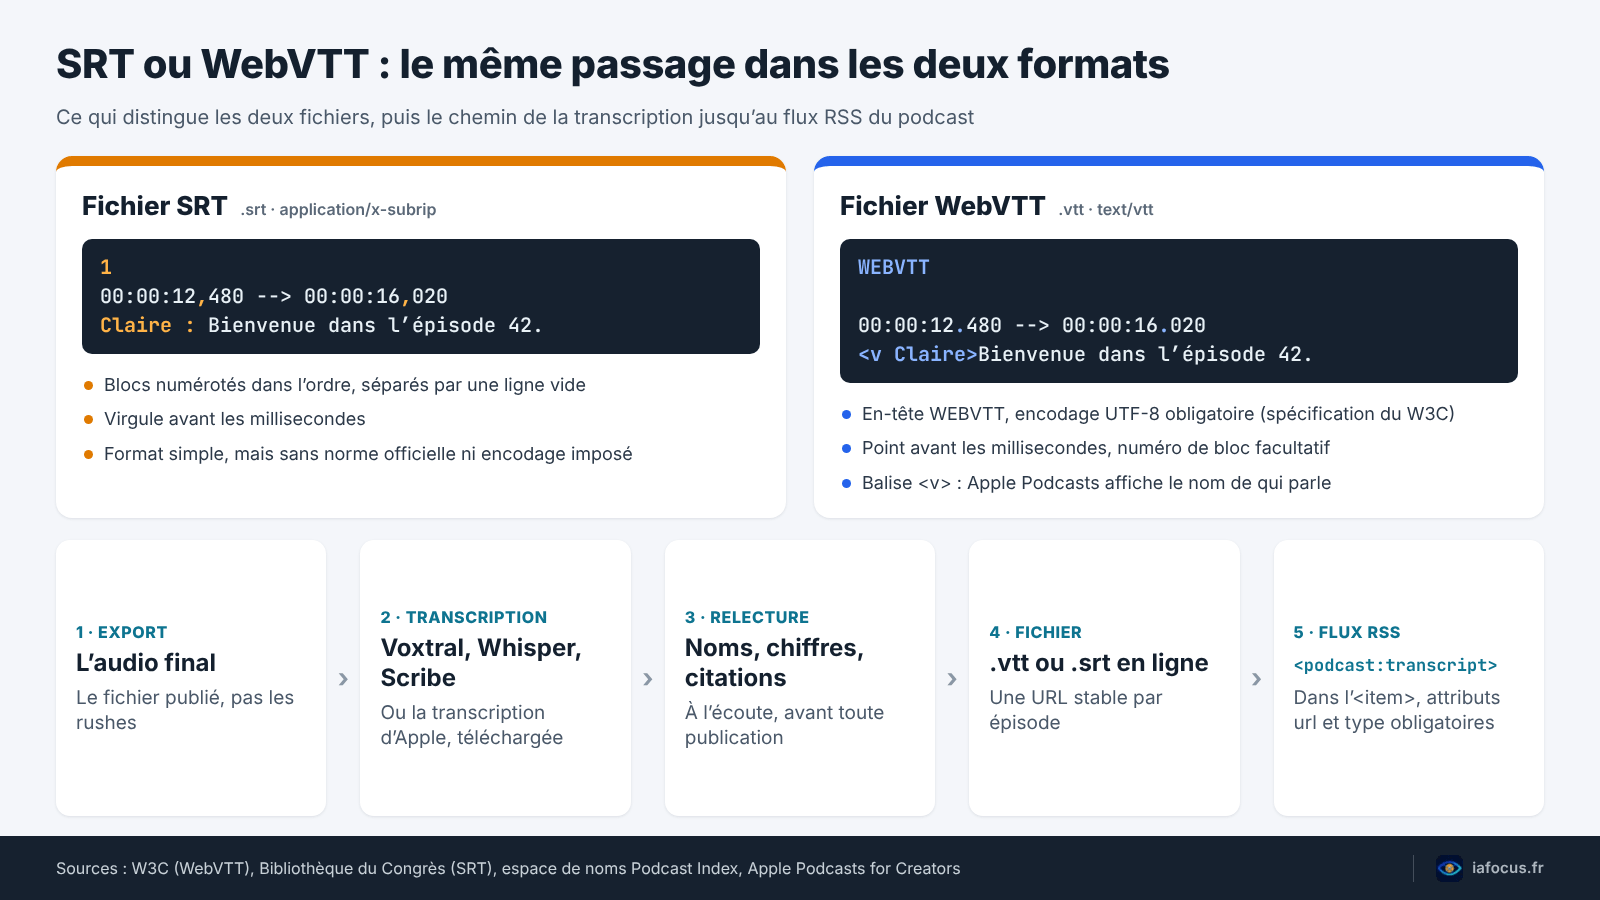
Les deux formats se ressemblent au point de se convertir l’un dans l’autre. Un fichier SRT empile des blocs numérotés : le numéro, la ligne de temps (00:00:12,480 --> 00:00:16,020), puis le texte. Simple et universel. Mais la Bibliothèque du Congrès américaine note que le fichier SRT n’est pas vraiment standardisé et n’impose aucun encodage de caractères. Avec des accents français, voir « é » à la place de « é » n’a rien de théorique.
Le format WebVTT, lui, repose sur une spécification du W3C (projet de recommandation candidate du 20 mai 2026). Le fichier commence par le mot WEBVTT, il est obligatoirement encodé en UTF-8 et servi avec le type text/vtt. Les millisecondes se séparent par un point, le numéro de bloc devient facultatif. Surtout, la balise de voix <v Claire> indique qui parle : Apple Podcasts affiche alors le nom de l’intervenant à chaque changement.
Le verdict tient en une ligne : livrez du WebVTT, et gardez un fichier SRT en secours pour les outils qui ne lisent que lui. C’est aussi le conseil de l’espace de noms Podcast Index, qui recommande des lignes de 65 caractères au plus en WebVTT, et deux lignes de 32 caractères par bloc pour un fichier SRT.
Étape 5 : déclarer la transcription dans le flux RSS
Le fichier doit vivre à une adresse stable, puis être déclaré par la balise podcast:transcript dans l’élément <item> de chaque épisode. Deux attributs sont obligatoires : url et type (par exemple text/vtt ou application/x-subrip). Deux sont facultatifs : language, qui reprend par défaut la langue du flux, et rel="captions", qui signale un fichier horodaté. Plusieurs balises peuvent coexister.
Pour un fichier WebVTT, la ligne ressemble à ceci : <podcast:transcript url="[adresse du fichier]" type="text/vtt" language="fr" rel="captions" />. L’espace de noms doit aussi être déclaré dans la balise <rss>, par l’attribut xmlns:podcast. En pratique, c’est votre hébergeur qui écrit le flux : vérifiez qu’il gère la balise (Apple tient une liste de partenaires).
Chez Apple, une fois le fichier lié, réglez l’épisode sur « Afficher les transcriptions que je fournis » dans Apple Podcasts Connect : votre texte remplace la transcription Apple Podcasts automatique après l’actualisation du flux. Pour les épisodes réservés aux abonnés, on charge le fichier VTT ou SRT directement dans Apple Podcasts Connect. Dernier piège, relevé par la documentation Podcast Index : si votre site héberge le fichier, autorisez les requêtes CORS, sans quoi les lecteurs web ne pourront pas l’afficher.
Accessibilité et référencement : ce que le texte change vraiment
Apple le dit sans détour : sans transcription, un podcast reste inaccessible à une partie du public, à commencer par les personnes sourdes ou malentendantes. Pour certains éditeurs, c’est même une obligation. Le RGAA (critère 4.1) demande, pour un contenu seulement audio pré-enregistré, une transcription textuelle placée à côté du lecteur ou accessible par un lien adjacent. Il s’impose aux organismes publics et aux entreprises à partir de 250 millions d’euros de chiffre d’affaires en France. Une mairie ou un grand groupe qui publie un podcast n’a donc, en principe, pas le choix.
Le référencement, ensuite, avec un peu de prudence. Sur le Web, ce qui se lit s’indexe : publiée sous le lecteur de l’épisode, la transcription podcast devient du texte comme un autre, avec les noms et les lieux cités. Préférez une page HTML à un PDF. Et une transcription relue est une réserve de citations et d’extraits pour vos réseaux. Notre guide du SEO avec l’intelligence artificielle dit comment en tirer un contenu utile, sans remplissage.
RGPD : la voix de vos invités est une donnée personnelle
La CNIL range la voix parmi les informations qui permettent d’identifier une personne, au même titre que l’image. Transcrire un podcast ajoute une couche : le nom de l’invité, sa ville, son employeur, l’anecdote sur sa santé deviennent du texte copiable et cherchable. Prévenez donc vos invités, dès l’accord d’enregistrement, qu’une transcription sera publiée. Et méfiez-vous des confidences : opinions politiques et données de santé relèvent des catégories particulières de l’article 9 du RGPD, dont le traitement est interdit en principe, sauf exceptions comme le consentement explicite.
Le choix de l’outil compte aussi. Envoyer l’audio à un service en ligne revient à le confier à un sous-traitant, qui doit présenter des « garanties suffisantes » selon l’article 28 du RGPD, contrat à l’appui. Whisper en local règle la question. Le point d’accès européen de Mistral la simplifie. Avec un stockage américain par défaut, lisez de près le contrat et l’encadrement des transferts.
Enfin, un invité peut demander l’effacement de ses données. La CNIL rappelle que le responsable dispose d’un mois, trois si la demande est complexe, et que ce droit cède devant la liberté d’expression et d’information, ce qui peut jouer pour un podcast d’actualité. Un passage retiré de l’audio doit aussi disparaître du fichier WebVTT.
Foire aux questions
Peut-on transcrire un podcast gratuitement ?
Oui. Whisper tourne en local sans frais, sous licence MIT, avec environ 6 Go de mémoire vidéo pour le modèle turbo. Et si l’émission est sur Apple Podcasts, la transcription automatique se télécharge dans Apple Podcasts Connect : il reste à la corriger, puis à la republier par le flux RSS.
Quelle différence entre un fichier SRT et un fichier WebVTT ?
Le fichier SRT numérote ses blocs, met une virgule avant les millisecondes et n’a pas de norme officielle. Le WebVTT, décrit par le W3C, impose l’en-tête WEBVTT et l’UTF-8, et sait nommer qui parle.
La transcription Apple Podcasts fonctionne-t-elle en français ?
Oui. Le français faisait partie des quatre langues du lancement, le 5 mars 2024, et des onze prises en charge aujourd’hui. Il faut iOS 17.4 ou plus récent et un épisode présent dans le catalogue d’Apple. Pas de texte ? Attendez 24 heures après la publication avant de chercher la panne.
Combien coûte la transcription d’un épisode d’une heure ?
Aux prix publics du 21 octobre 2026, hors taxes : 0,21 dollar avec Voxtral Mini Transcribe 3, 0,22 dollar avec Scribe v2 (0,27 avec le vocabulaire imposé), 0,24 dollar avec Voxtral Small Transcribe 3 et 0,27 dollar avec gpt-transcribe d’OpenAI. Whisper en local ne coûte que l’électricité.
Sources
- WebVTT: The Web Video Text Tracks Format, W3C, projet de recommandation candidate du 20 mai 2026.
- SubRip Subtitle format (SRT), Bibliothèque du Congrès des États-Unis.
- RGAA 4.1.2, critères et tests (critère 4.1), accessibilite.numerique.gouv.fr.
- Champ d’application de l’obligation d’accessibilité (article 47 de la loi du 11 février 2005), accessibilite.numerique.gouv.fr.
- Donnée personnelle, CNIL.
- Le droit à l’effacement, CNIL.
- RGPD, chapitre II, article 9, CNIL.
- RGPD, chapitre IV, article 28, CNIL.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.