Un assistant IA qui rédige des propositions commerciales à partir de documents clients, un modèle de vision qui analyse des photos de chantier, un chatbot RH connecté à une base interne : ces projets peuvent produire un vrai gain de temps. Mais ils déplacent aussi la question du risque vers les données. La gouvernance des données IA sert justement à organiser, dès le départ, ce qu’une équipe peut collecter, envoyer à un modèle, conserver, réutiliser et contrôler, et non à ajouter une validation juridique à la fin du workflow.
Pour les équipes produit, marketing, créatives ou data, la question n’a rien d’abstrait : éviter qu’un prototype prometteur devienne un angle mort en matière de confidentialité, de qualité ou de propriété intellectuelle. Bonne nouvelle, une gouvernance des données IA bien pensée accélère souvent le déploiement, car elle réduit les retours en arrière, les traitements manuels et les arbitrages improvisés.
Pourquoi les données changent la nature du risque IA
Dans un logiciel classique, une erreur remonte souvent à une règle de code identifiable. Avec l’IA, c’est plus trouble : le comportement dépend aussi des données d’entraînement, de celles injectées dans le prompt, des documents récupérés par un moteur RAG et des retours générés par les utilisateurs. Autant de flux, parfois invisibles pour la personne qui utilise l’outil. La directive 2024/2853 en tire les conséquences : le logiciel, IA comprise, y devient un produit.
Exemple : un service de génération de comptes rendus. Si les enregistrements audio sont conservés par un fournisseur, si les transcriptions servent à améliorer son modèle ou si les accès sont trop larges, le problème tient au cycle de vie de l’information, pas à la qualité du résumé. Même logique pour un outil de création visuelle alimenté par des images de campagne, un copilote de code connecté aux dépôts Git ou un agent IA qui interroge un CRM.
Être responsable, c’est proportionner les contrôles au niveau de sensibilité et aux conséquences d’une erreur. Rien à voir avec l’interdiction des outils grand public ou l’exigence d’une infrastructure lourde pour chaque prompt. Générer dix idées de titres à partir d’un brief public n’expose évidemment pas au même niveau de risque que classer automatiquement des candidatures ou recommander une décision de crédit.
Gouvernance des données IA : les quatre questions à poser avant chaque usage
Avant d’ouvrir l’accès à un modèle, une équipe doit pouvoir répondre simplement à quatre questions. Quelles données entrent dans le système ? Pour quelle finalité ? Qui y accède ? Combien de temps restent-elles disponibles ? Une réponse floue ne condamne pas forcément le projet, mais elle impose de le cadrer avant de le généraliser.
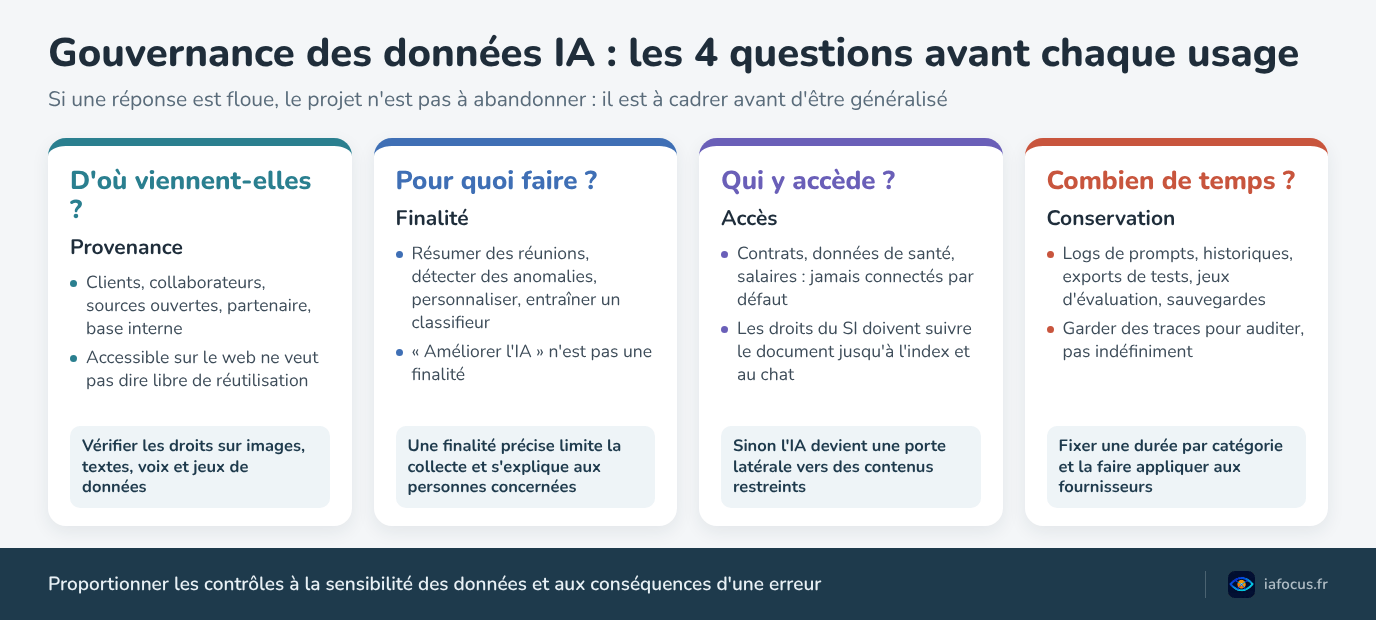
D’abord, la provenance. Les données viennent-elles de clients, de collaborateurs, de sources ouvertes, d’un partenaire ou d’une base constituée en interne ? Attention au raccourci : une information accessible sur le web n’est pas automatiquement libre de réutilisation pour entraîner, enrichir ou diffuser un modèle. Vérifiez aussi les droits associés aux images, textes, voix et jeux de données achetés.
La finalité, ensuite, doit être précise : dire que les données servent à « améliorer l’IA » ne suffit pas. S’agit-il de résumer des réunions, de détecter des anomalies, de personnaliser une campagne ou d’entraîner un classifieur ? Une finalité claire aide à limiter la collecte, à choisir des indicateurs adaptés et à s’expliquer auprès des personnes concernées.
Les accès, eux, demandent une vraie vigilance. Un espace partagé qui contient des contrats ou des données sensibles (santé, salaires) ne devrait pas être connecté par défaut à un assistant conversationnel. Les droits existants dans le SI doivent suivre le document jusqu’au moteur de recherche, à l’index vectoriel et à l’interface de chat. Sinon, l’IA devient une porte latérale vers des contenus normalement restreints.
Reste la durée de conservation, qui doit inclure les copies moins visibles : logs de prompts, historiques de conversation, exports de tests, jeux d’évaluation et sauvegardes. Garder des traces peut être nécessaire pour auditer un incident. Les garder indéfiniment, en revanche, élargit la surface d’exposition.
Mettre en place une gouvernance des données IA responsable
Le point de départ le plus utile ? Une cartographie des cas d’usage, pas un grand règlement de cinquante pages. Pour chaque workflow IA, créez une fiche courte : objectif métier, utilisateurs, modèle ou fournisseur, données traitées, zones géographiques d’hébergement, sorties produites, durée de conservation et responsable désigné. Elle sert ensuite à décider, à suivre et à faire dialoguer métier, DSI, sécurité, data et juridique.
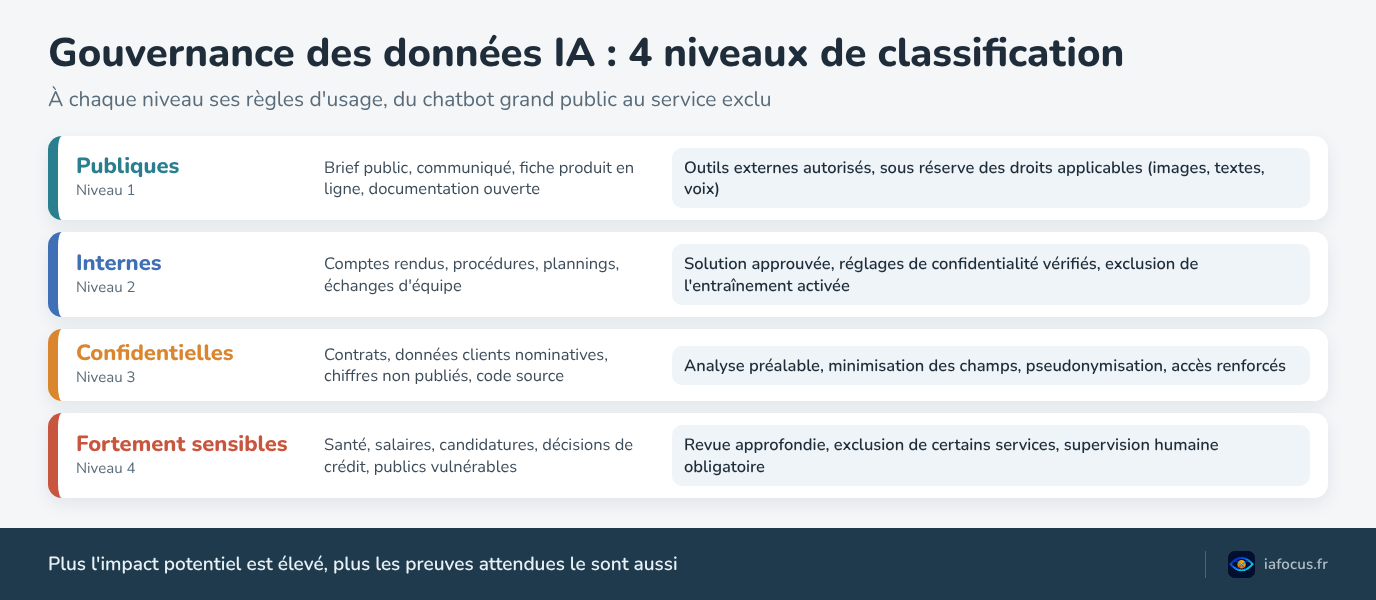
Au départ, une classification simple suffit souvent. Vous pouvez distinguer quatre niveaux : données publiques, internes, confidentielles et fortement sensibles. À chacun ses règles d’usage. Les contenus publics peuvent alimenter des outils externes, sous réserve des droits applicables. Les contenus internes demandent une solution approuvée et des réglages de confidentialité vérifiés. Quant aux données confidentielles ou sensibles, elles nécessitent généralement une analyse plus poussée, une minimisation des champs, des contrôles d’accès renforcés, voire l’exclusion de certains services.
La minimisation ? Un levier sous-estimé. Pour tester un assistant de support, faut-il vraiment transmettre le nom, l’adresse et l’historique complet de chaque client ? Souvent, non : un identifiant pseudonymisé, un extrait pertinent et des données synthétiques suffisent. L’approche protège les personnes tout en améliorant parfois la qualité des prompts, parce qu’elle force l’équipe à isoler les informations réellement utiles.
Les fournisseurs doivent aussi entrer dans le périmètre de la gouvernance des données IA. Car les équipes achètent de plus en plus de briques IA : API de modèles, transcription, synthèse vocale, OCR, recherche sémantique ou génération d’images. Vérifiez les conditions de réutilisation des données, les options d’exclusion de l’entraînement, la localisation des traitements, les sous-traitants, les mécanismes de suppression et les capacités d’export d’audit. Une offre entreprise propose souvent des paramètres absents d’un compte individuel, sans être pour autant adaptée d’office à toutes les contraintes. Côté réglementation, notre fiche AI Act pour les entreprises classe les obligations selon votre rôle et le niveau de risque de l’outil.
Désigner des responsables sans créer un goulot d’étranglement
Faire reposer la gouvernance des données IA sur une seule personne, censée valider chaque expérimentation ? C’est l’échec assuré. Le bon modèle est distribué. Le propriétaire métier porte la finalité et l’usage réel, l’équipe technique garantit l’architecture, les accès et l’observabilité. Les référents sécurité, juridique ou protection des données interviennent selon le niveau de risque. Et un responsable clairement identifié tranche les situations grises et assure le suivi après le lancement.
Cette répartition marche mieux avec un processus léger. Un usage à faible risque peut suivre une voie rapide, avec une checklist et des outils autorisés. Un projet qui traite des données sensibles, prend une décision significative ou touche un public vulnérable doit, lui, déclencher une revue en profondeur. Plus l’impact potentiel est élevé, plus les preuves attendues le sont aussi.
Gouvernance des données IA : la fiche de cadrage en une page
La fiche évoquée plus haut tient sur une page. Comptez une réunion d’une heure pour la remplir, avec le métier, la technique et, selon le niveau de risque, le juridique. Ci-dessous, le modèle que nous utilisons, avec l’exemple d’un assistant de rédaction de comptes rendus.
| Champ | Question à trancher | Exemple |
|---|---|---|
| Objectif métier | Quel problème résout-on ? | Produire un compte rendu de réunion en dix minutes au lieu d’une heure |
| Données traitées | Que reçoit le modèle ? | Enregistrement audio, liste des participants, ordre du jour |
| Classification | Public, interne, confidentiel ou sensible ? | Interne, sauf réunions RH classées sensibles |
| Fournisseur et hébergement | Qui traite, où, avec quelle option d’exclusion de l’entraînement ? | Offre entreprise, hébergement dans l’Union européenne, entraînement désactivé |
| Accès | Qui voit les sorties ? | Les participants de la réunion et leur responsable |
| Conservation | Combien de temps, logs compris ? | Audio supprimé après transcription, compte rendu trois ans, logs quatre-vingt-dix jours |
| Supervision | Qui relit, qui tranche ? | Relecture par l’organisateur avant diffusion |
| Responsable | Qui répond en cas d’incident ? | Le responsable de l’équipe qui a demandé l’outil |
Une fiche remplie est un support de décision, pas un document juridique : elle évite les arbitrages improvisés et donne, en cas d’incident, la trace de ce qui avait été convenu. Et elle vaut aussi pour les projets de gouvernance des données déjà en production : passez un usage existant au crible de ce modèle, vous y trouverez souvent un champ jamais tranché.
Les erreurs fréquentes en gouvernance des données IA
- Traiter la gouvernance des données comme une étape finale : la validation tombe quand le prototype est déjà adopté, et chaque contrainte passe pour un recul.
- Confondre outil approuvé et données autorisées : l’envoi de données sensibles à un modèle qui n’en a pas besoin ne devient pas licite du seul fait d’une offre entreprise.
- Oublier les copies invisibles : logs de prompts, exports de tests et sauvegardes survivent au projet lui-même.
- Ne mesurer la qualité qu’au lancement : entre-temps, une base documentaire vieillit, un moteur RAG dérive, un modèle change de version sans prévenir.
- Centraliser sur une seule personne : la file d’attente s’allonge, les équipes contournent la règle et la gouvernance des données perd toute crédibilité.
Contrôler la qualité, les biais et la traçabilité
Licites et sécurisées, vos données ne garantissent pas pour autant un système utile. Un modèle peut produire des réponses inexactes parce que la base documentaire est obsolète, incomplète ou mal indexée. Il peut aussi désavantager certains groupes, si les exemples historiques reflètent des pratiques biaisées. Une gouvernance des données IA responsable traite donc la qualité comme un sujet opérationnel, au-delà de sa dimension éthique.
Côté moteur RAG, évaluez régulièrement la fraîcheur des documents, la pertinence des passages récupérés et le taux de réponses sans source fiable. Côté classification, mesurez les performances par segment pertinent (type de dossier, langue, zone géographique ou profil utilisateur, selon le cas d’usage). Le but : détecter les écarts qui rendent l’outil dangereux ou peu fiable dans une situation réelle, sans courir après une perfection théorique.
Une sortie pose problème ? La traçabilité permet d’enquêter. Conservez donc, dans une proportion adaptée, la version du modèle, celle du prompt système, les sources consultées, les paramètres utilisés et la date du traitement. Attention quand même : journaliser un prompt brut peut, en soi, exposer des données personnelles ou confidentielles. Mieux vaut parfois masquer certains champs, journaliser des métadonnées ou limiter l’accès aux logs.
Quand la sortie influence une décision aux conséquences lourdes, la supervision humaine reste nécessaire. Dans un workflow éditorial, elle peut prendre la forme d’une relecture et d’une vérification des sources. En RH, en médecine, dans l’assurance ou la finance, elle doit aller plus loin : une personne compétente doit pouvoir comprendre le rôle de l’IA, contester sa recommandation et prendre une décision indépendante.
Du cadre réglementaire au réflexe de travail
Le RGPD encadre déjà de nombreux traitements de données personnelles utilisés par l’IA, comme le rappellent les fiches pratiques IA de la CNIL : base légale, transparence, minimisation, sécurité, droits des personnes et encadrement des sous-traitants. Le règlement européen sur l’IA y ajoute une logique de niveaux de risque, avec des obligations spécifiques pour certains systèmes. Autrement dit, pour une organisation française, la conformité à la réglementation européenne ne se réduit pas à cocher une case dans l’outil choisi.
En gouvernance des données IA, n’attendez pas la règle parfaite pour agir. Les modèles évoluent vite, les usages aussi. Mieux vaut des règles internes compréhensibles, des équipes formées aux gestes de base et des cas d’usage revus à intervalles réguliers. Une charte utile dit par exemple quelles données ne doivent jamais être collées dans un outil non approuvé, quand utiliser une version entreprise, comment signaler une réponse problématique et où demander un arbitrage. Pour l’appliquer pas à pas, voyez notre méthode pour sécuriser ses données dans les outils IA. Notre guide de l’IA au travail en tire une checklist en 7 règles, à vérifier avant d’ouvrir un outil.
Un frein à l’expérimentation, ce cadre ? Pour les créatifs et les communicants, c’est même l’inverse : il aide à tester plus vite les outils qui méritent d’intégrer le workflow, sans transformer chaque prompt en pari sur la confidentialité ou les droits d’usage. En gouvernance des données IA, la meilleure prochaine étape est souvent modeste : choisissez un cas d’usage déjà en production, cartographiez ses données sur une page, puis corrigez le risque le plus évident. Et c’est comme ça que la confiance devient une capacité de travail durable.