Voxtral 3 est sorti le mardi 20 octobre 2026, et cette fois Mistral AI vise le téléphone. La start-up parisienne présente des modèles qui transcrivent la parole dans 50 langues, parlent dans plus de 35 et s’assemblent en un agent vocal capable de décrocher, de comprendre, de consulter un logiciel et de répondre. Le même jour, ElevenLabs lançait Eleven Realtime. Hasard du calendrier ? Peut-être. Le duel, lui, est bien réel.
En mars, la synthèse vocale de Mistral ne parlait que 9 langues : le bond est net. Mais trois détails changent la lecture. Les poids ne sont plus publiés. Les comparaisons de voix sont des évaluations maison. Et l’hébergement « en Europe » dépend du point d’accès choisi. Reprenons dans l’ordre.
Voxtral 3 : quatre modèles et un kit pour agents vocaux
Deux modèles transcrivent des fichiers audio : Voxtral Small Transcribe 3, le plus précis, et Voxtral Mini Transcribe 3, 4 milliards de paramètres, pensé pour le prix. Un troisième transcrit en direct et repère quand votre interlocuteur a fini de parler. Le quatrième lit du texte à voix haute ; Mistral l’appelle Voxtral Mini TTS 3, Voxtral Speech 3 ou Voxtral TTS 3 selon la page (même chez Mistral, on s’y perd).
Par-dessus, un kit de développement assemble le tout en agent vocal. La démo du billet d’annonce de Mistral parle d’elle-même : une patiente anglophone appelle avec une lettre de son médecin rédigée en français, l’agent la lit, la lui explique en anglais, propose un créneau chez le dermatologue et le réserve. Banal pour un secrétariat médical. Beaucoup moins pour une machine.
Tout est accessible par l’API depuis le 20 octobre. Les fiches de la documentation de Mistral classent pourtant les quatre modèles en « Public Preview » : une préversion publique, pas une offre stable. Pour un service client en production, la nuance compte.
Transcription : 50 langues et des scores à lire de près
En février, Voxtral Transcribe 2 couvrait 13 langues. Voxtral 3 passe à 50 langues, dont les 24 langues officielles de l’Union européenne et des langues d’Asie et d’Inde peu dotées en données. Pour un service qui reçoit des appels en roumain ou en letton, c’est le changement le plus concret.
Côté précision, Mistral publie ses propres mesures sur FLEURS, un jeu de test public, pour 45 langues. Voxtral Small Transcribe 3 s’y trompe sur 4,1 % des mots. Microsoft AI Transcribe 2 fait exactement pareil, Scribe v2 d’ElevenLabs 4,9 % et Whisper large-v3 d’OpenAI 16 %. Match nul avec Microsoft, donc, même si la fiche du modèle prétend le contraire.
Le vrai progrès touche la séparation des voix (qui parle, et quand) : le taux d’erreur passe de 30,9 % avec Voxtral Mini Transcribe 2 à 18,6 % avec Mini Transcribe 3. Et si vous fournissez une liste de noms propres ou de termes métier, Small Transcribe 3 en retrouve 94,6 % sur des conférences de résultats financiers, contre 81,4 % sans liste.
Le direct est moins flatteur. Réglé à 480 ms de délai, le modèle temps réel affiche 6,4 % d’erreurs sur 35 langues, quand Gemini 3.5 Realtime Transcribe de Google descend à 4,2 %… sur un graphique publié par Mistral. Autre détail pour le sous-titrage : avec Voxtral 3, l’horodatage mot par mot disparaît au profit du segment, d’après le guide de migration. Vos sous-titres animés mot à mot devront attendre.
Synthèse vocale : de 9 à plus de 35 langues en sept mois
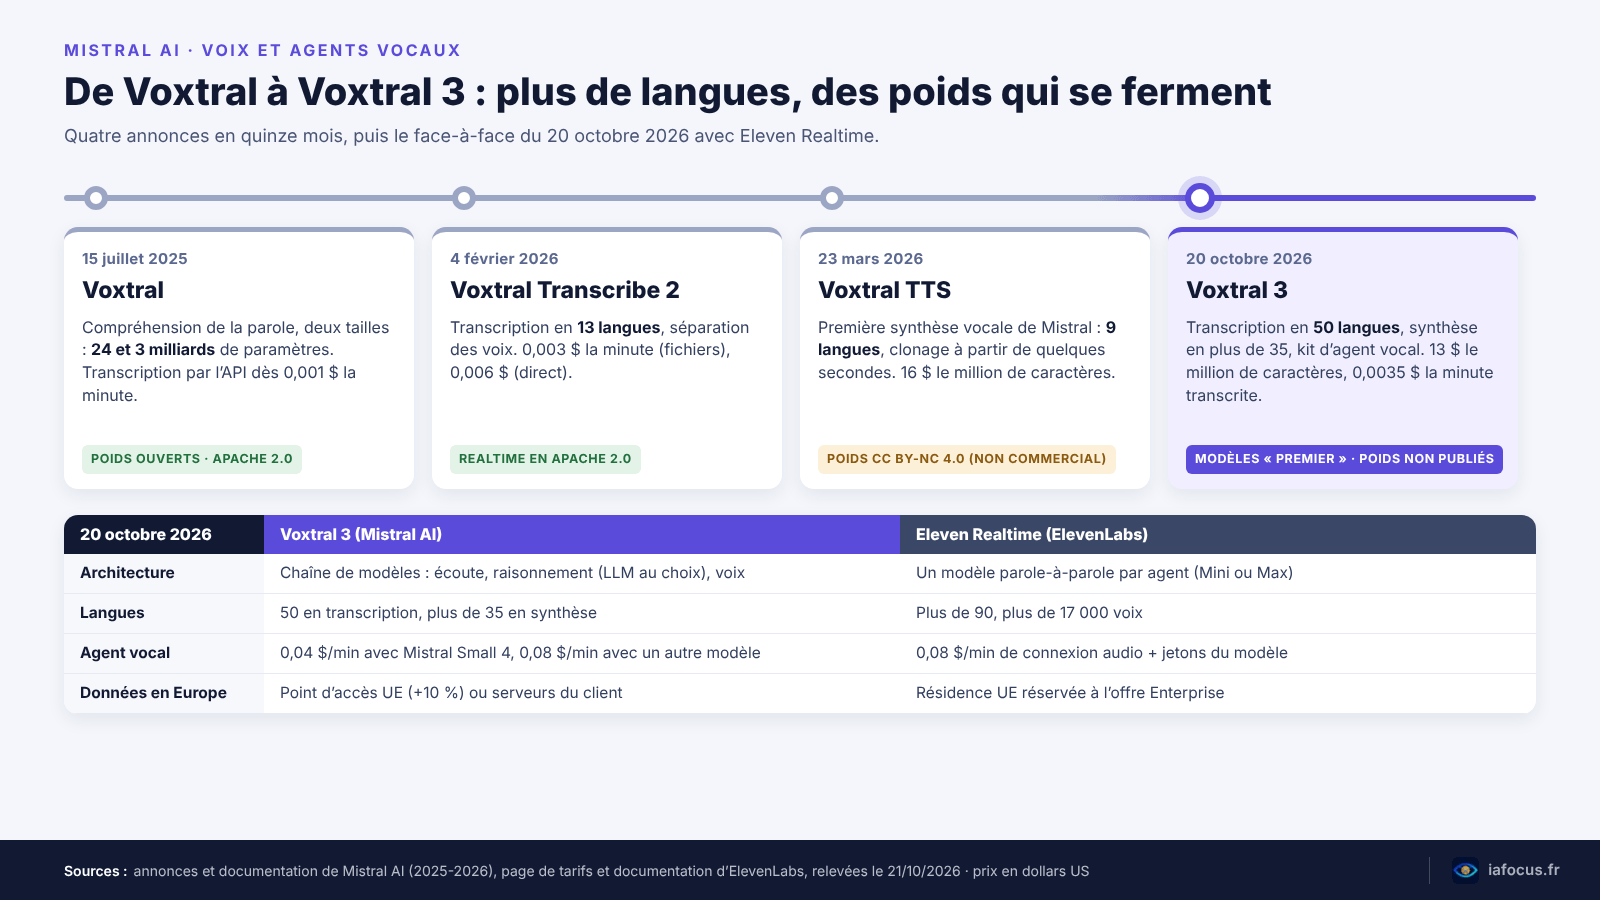
Le 23 mars 2026, Mistral lançait Voxtral TTS, sa première synthèse vocale : 9 langues, un clonage à partir de 3 secondes d’enregistrement, 16 dollars le million de caractères. Sept mois plus tard, celle de Voxtral 3 parle plus de 35 langues et plus de 50 dialectes, pour 13 dollars. Des voix prêtes à l’emploi existent dans 18 langues, dont le français de France.
Le modèle déduit l’émotion du texte ; 34 balises d’émotion et 2 de débit servent à la forcer. Une indication phonétique corrige un nom propre (la démo fait dire « Reims » correctement, pas si évident). Si vous utilisez déjà les balises SSML pour régler pauses et prononciation, vous retrouverez la logique, avec une syntaxe maison. Le premier son arrive en 90 ms environ.
Pour les marques, l’option Pro Voice reproduit le caractère, la palette émotionnelle et le style d’un locuteur d’une langue à l’autre, à partir de 30 minutes d’audio. Copier une voix humaine pose des questions de consentement, détaillées dans notre article sur le clonage de voix par IA et son cadre légal.
Sur la qualité, gardez la tête froide : les graphiques de Mistral reposent sur des évaluations internes, notées par Gemini 3.8 Flash (un modèle de Google utilisé comme juge), et le test multilingue ne couvre que 11 langues. Sur le prix, pas de débat. D’après la grille d’ElevenLabs, Eleven v4 coûte 80 dollars le million de caractères et v4 Turbo 40 dollars, soit trois à six fois plus. Pour une synthèse vocale française produite à grande échelle, l’écart pèse.
Un agent vocal en trois étapes, branché sur vos outils
Construit sur LiveKit, une infrastructure audio temps réel, le kit enchaîne trois étapes en flux continu. La transcription en direct écoute et détecte la fin de la phrase. Un modèle de langage, Mistral Small par exemple, comprend la demande et appelle les outils. Voxtral Speech 3 répond sur le ton de la conversation. Selon Mistral, chaque tour de parole tient sous la seconde, et l’agent se tait quand on lui coupe la parole.
Pendant l’appel, l’agent vocal peut vérifier l’identité d’un client, consulter une facture ou réserver un rendez-vous, par appel de fonctions, recherche web ou recherche dans vos données. Il passe par SIP pour le téléphone, par WebRTC pour le navigateur et se branche aux standards et logiciels de centre de contact existants.
L’argument de fond, c’est la modularité : chaque étape est un modèle séparé, et vous changez le modèle de langage, la voix ou la langue sans réécrire l’agent. Le revers ? Dans une chaîne, chaque maillon ajoute son délai, ce que la documentation des agents vocaux admet elle-même. Le tarif : 0,04 dollar la minute avec Mistral Small 4, 0,08 dollar avec un autre modèle. Le grand public connaît ces échanges par le mode vocal de ChatGPT ; ici, la cible, ce sont les développeurs et les services clients.
Prix et licence de Voxtral 3 : moins cher à l’usage, plus fermé
La grille publiée le 20 octobre, en dollars :
- Voxtral Mini Transcribe 3 : 0,0035 $ la minute, soit 0,21 $ l’heure ;
- Voxtral Small Transcribe 3 : 0,004 $ la minute ;
- Voxtral Mini Transcribe Realtime 3 : 0,008 $ la minute ;
- Voxtral Speech 3 : 13 $ le million de caractères ;
- agent vocal : 0,04 $ la minute avec Mistral Small 4, 0,08 $ avec un autre modèle.
Par rapport à février, la transcription augmente un peu (+17 % sur fichiers, +33 % en direct) et la voix baisse de 19 %. Rien de spectaculaire. Ce qui bouge vraiment, c’est la licence.
Le premier Voxtral, en juillet 2025, sortait en deux tailles sous licence Apache 2.0, usage commercial compris, comme le modèle temps réel de février. La voix de mars était déjà plus restrictive : poids publiés, mais sous CC BY-NC 4.0, sans usage commercial. Avec Voxtral 3, les quatre modèles passent dans la catégorie « Premier » de la documentation, et non plus « Open ». Au 21 octobre, aucun poids n’apparaît sur la page Hugging Face de Mistral.
Un virage ? Le mot est fort. Mais l’installation sur vos serveurs passe désormais par l’équipe commerciale (« talk to our team », dit le billet), plus par un téléchargement. Pour qui a choisi Mistral pour ses modèles ouverts, ce n’est pas anodin. Pour un grand groupe qui négocie un contrat de toute façon, ça change peu. Notre comparatif Mistral AI ou OpenAI : modèles, prix de l’API et données détaille le reste de la gamme.
Voxtral 3 face à Eleven Realtime : deux façons de faire parler une machine
Le même jour, ElevenLabs présentait Eleven Realtime. L’approche est opposée : un seul modèle parole-à-parole fait tout l’agent. Eleven Realtime v1 Mini vise les conversations simples à bas coût, v1 Max le service client et les tâches en plusieurs étapes avec outils. Plus de 90 langues, plus de 17 000 voix et une compatibilité avec l’API Realtime d’OpenAI : on change l’adresse et le nom du modèle, le code existant suit.
Les scores, mesurés par Artificial Analysis selon ElevenLabs, sont élevés : 98,8 % de bonnes réponses pour Max sur Big Bench Audio (1 000 questions de raisonnement posées à l’oral), une prise de parole en 0,57 seconde, 87,1 % des tâches avec outils réussies. Mini tombe à 60,3 % sur ce dernier point. Le prix : 0,08 dollar la minute de connexion audio, plus les jetons du modèle (de 0,20 à 9 dollars le million selon la version et le sens).
Sur le papier, l’agent vocal de Mistral coûte donc deux fois moins cher à la minute. En pratique, la comparaison reste bancale : aucun banc d’essai commun aux deux offres n’existe encore, et ce que couvre exactement le forfait de Mistral se vérifie sur un vrai volume d’appels.
Une clientèle très internationale, ou des voix déjà créées chez ElevenLabs (voir notre tuto pour créer des voix de synthèse sur ElevenLabs), plaident pour Eleven Realtime. Choisir chaque brique, payer moins à la minute ou garder la main sur l’hébergement plaident pour Voxtral 3. Un piège, quand même : Mistral comprend 50 langues mais n’en parle qu’un peu plus de 35, avec des voix prêtes dans 18. Vérifiez que celles de vos clients figurent dans les trois listes.
Données en Europe, RGPD et AI Act : les points à vérifier
L’hébergement européen revient partout dans l’annonce. La documentation sur l’inférence régionale est plus nuancée. Le point d’accès mondial, api.mistral.ai, ne garantit aucun lieu de traitement. L’européen, api.eu.mistral.ai, fait tourner les modèles dans l’Union et l’AELE, avec un supplément de 10 %, mais sans Agents, ni traitement par lots, ni fichiers ; les données de compte peuvent rester hors zone. Avant de déployer un agent vocal, vérifiez fonction par fonction ce qui tourne vraiment en Europe.
Même prudence pour la non-conservation des données : accordée sur demande aux offres payantes, elle couvre la synthèse et la transcription, pas les Agents. Seule l’installation sur vos serveurs garde tout chez vous. ElevenLabs stocke, lui, les données aux États-Unis par défaut, et sa résidence européenne est réservée à l’offre Enterprise.
Pourquoi tant de précautions ? Parce que la voix est, rappelle la CNIL dans son livre blanc sur les assistants vocaux, une caractéristique biométrique qui peut permettre d’identifier une personne. Un agent qui l’enregistre ou la clone traite donc des données personnelles au sens du RGPD. Et le détournement existe, comme le montre notre article sur le deepfake audio et la façon de reconnaître une voix générée.
L’AI Act ajoute une règle, applicable depuis le 2 août 2026. Son article 50 impose aux fournisseurs de concevoir les systèmes destinés à interagir directement avec des personnes pour que celles-ci sachent qu’elles parlent à une IA, sauf si c’est évident. Il demande aussi de marquer les contenus audio de synthèse dans un format lisible par machine. Pour un agent vocal au téléphone, le plus sûr est de l’annoncer dès le début de l’appel. Le calendrier complet figure dans notre point sur l’AI Act en 2026.
Enfin, depuis le 11 août 2026, démarcher un particulier par téléphone suppose son consentement préalable, sauf exceptions comme un contrat en cours, selon la fiche de la CNIL (article L. 223-1 du code de la consommation). La prospection par automate d’appel l’exigeait déjà. Un agent vocal qui appelle des particuliers pour vendre n’y échappe pas, si naturelle que soit sa voix.
Foire aux questions
Voxtral 3 parle-t-il français ?
Oui. Voxtral 3 compte le français parmi ses 50 langues de transcription et ses plus de 35 langues de synthèse, et Mistral propose des voix prêtes à l’emploi en français de France. À tester sur vos propres textes avant tout déploiement.
Combien coûte Voxtral 3 ?
La transcription coûte de 0,0035 à 0,004 dollar la minute pour les fichiers et 0,008 dollar en direct. La voix revient à 13 dollars le million de caractères. L’agent vocal complet est facturé 0,04 dollar la minute avec Mistral Small 4, 0,08 dollar avec un autre modèle de raisonnement.
Peut-on installer Voxtral 3 sur ses propres serveurs ?
Oui, selon Mistral, mais via son équipe commerciale : au 21 octobre 2026, aucun poids n’est publié sur Hugging Face. Les anciens modèles Voxtral restent téléchargeables, sous Apache 2.0 pour la transcription et sous licence non commerciale pour la voix de mars.
Quelle différence entre Voxtral 3 et Eleven Realtime ?
Voxtral 3 enchaîne trois modèles séparés (écoute, raisonnement, voix) que vous pouvez remplacer un à un. Eleven Realtime utilise un seul modèle parole-à-parole, en version Mini ou Max, avec plus de 90 langues. Mistral en comprend 50, en parle plus de 35, pour un prix à la minute affiché deux fois plus bas.
Sources
- Article 50 du règlement (UE) 2024/1689 sur l’intelligence artificielle : obligations de transparence, AI Act Service Desk, Commission européenne.
- Lignes directrices sur les obligations de transparence pour les fournisseurs et les déployeurs de systèmes d’IA (20 juillet 2026), Commission européenne.
- Législation sur l’IA : cadre réglementaire et calendrier d’application, Commission européenne.
- « À votre écoute » : la CNIL publie son livre blanc sur les assistants vocaux (7 septembre 2020), CNIL.
- Prospection commerciale par téléphone (hors automate d’appel) : quelles sont les règles ?, CNIL.
- La prospection commerciale par courrier électronique, SMS-MMS et automate d’appel, CNIL.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.