Les balises SSML servent à dire à une voix de synthèse où respirer, comment prononcer un nom et à quelle vitesse lire. Le principe tient en une ligne : vous entourez le texte de petites instructions au format XML, le moteur les lit et ajuste sa diction. Le langage date de 2004, il a été révisé en 2010, et il reste la façon la plus précise de corriger un serveur vocal, une voix off ou un livre audio.
Le piège ? Chaque moteur n’en lit qu’une partie. ElevenLabs, dont un billet du 15 octobre 2026 a relancé le sujet, ignore désormais le SSML sur ses modèles récents. Google, Amazon et Microsoft le lisent, mais chacun à sa manière, et pas toujours comme le prévoit la norme. Ce tutoriel passe en revue les balises SSML utiles, avec des exemples conformes à la recommandation du W3C, puis ce que chaque service en fait réellement.
Les balises SSML, une norme du W3C pour diriger la voix
SSML veut dire Speech Synthesis Markup Language. Le W3C, l’organisme qui fixe les standards du Web, en a fait une recommandation le 7 septembre 2004, puis a publié la version 1.1 le 7 septembre 2010. Petit détail qui fera plaisir aux lecteurs français : deux des auteurs de cette version 1.1 travaillaient pour France Telecom.
La version 1.1 de SSML impose trois choses à l’élément racine speak : un attribut version égal à « 1.1 », la langue du document dans xml:lang et l’espace de noms de SSML. Sans eux, le document n’est pas conforme. Voici le squelette minimal, pour une voix française :
<speak version="1.1"
  xmlns="http://www.w3.org/2001/10/synthesis"
  xml:lang="fr-FR">
  <p>
    <s>Bonjour et bienvenue.</s>
    <s>Un conseiller va vous répondre.</s>
  </p>
</speak>
Les éléments p et s marquent un paragraphe et une phrase. Facultatifs, ils aident le moteur à placer ses respirations. Les exemples qui suivent se glissent à l’intérieur de cet élément speak.
Ajouter une pause avec la balise break
En synthèse vocale, pauses et silences comptent souvent plus que le timbre. Une voix qui enchaîne un numéro de dossier et une consigne sans reprendre son souffle paraît pressée, voire robotique. Parmi les balises SSML, break règle ce problème de deux façons : une durée exacte avec time, en secondes ou en millisecondes, ou une force relative avec strength, qui va de none à x-strong.
Votre train partira à l’heure.
<break time="800ms"/>
Merci de votre patience.
<break strength="x-strong"/>
Prochain départ dans dix minutes.
Si vous indiquez les deux attributs, la norme veut que la durée l’emporte. Et une balise sans attribut produit une coupure un peu plus marquée que celle que le moteur aurait choisie seul. Pratique pour forcer une respiration sans calculer.
Reste la limite propre à chaque service. ElevenLabs plafonne à 3 secondes, Amazon Polly à 10 secondes, Azure à 20 secondes. Google, lui, ne publie pas de maximum sur sa page de référence. Au-delà de quelques secondes, de toute façon, l’auditeur croit que la ligne a coupé.
Débit, hauteur et volume : prosody et son piège
La balise prosody modifie le débit (rate), la hauteur (pitch) et le volume (volume) d’un passage. La version 1.1 de SSML a revu la syntaxe du débit et du volume : un pourcentage de débit y agit comme un multiplicateur. 100 % ne change rien, 50 % lit deux fois plus lentement, 200 % deux fois plus vite. Le volume s’exprime en décibels signés (+6dB double à peu près l’amplitude), la hauteur en hertz, en pourcentage ou en demi-tons, et les trois acceptent des mots-clés.
<prosody rate="slow">
  Lisez lentement cet avertissement.
</prosody>
<prosody rate="85%" pitch="-2st">
  Puis un peu plus grave.
</prosody>
<prosody volume="loud">
  Et plus fort pour finir.
</prosody>
Voilà le piège. Chez Azure, d’après la documentation de Microsoft, un pourcentage exprime un changement relatif : « 50% » y signifie 50 % plus vite, alors que la norme comprend « moitié moins vite ». Le même document SSML produit donc deux débits opposés selon le service. Amazon Polly, à l’inverse, suit la lecture du W3C (de 20 à 200 %), mais ses voix neurales et génératives ne prennent pas en charge la hauteur.
Le conseil qui en découle est simple : préférez les mots-clés x-slow, slow, fast, loud ou soft, que Google, Polly et Azure comprennent de la même façon. Google recommande en plus de n’entourer que des phrases entières, sinon des pauses parasites apparaissent. Et testez chaque chiffre à l’oreille.
Prononciation : phoneme, sub, say-as et lang
Côté prononciation, voix IA et voix classiques butent sur les mêmes mots. Le français en offre un bon catalogue : les homographes (« les poules du couvent couvent »), les noms de lieux comme Metz, qui se dit « mess », ou Laon, qui se dit « lan », sans parler des sigles. Quatre balises SSML traitent ces cas.
<s>Les poules du couvent
  <phoneme alphabet="ipa"
    ph="kuv">couvent</phoneme>.</s>
<s>Départ pour
  <phoneme alphabet="ipa"
    ph="mɛs">Metz</phoneme>.</s>
<s>Le
  <sub alias="règlement européen sur l’IA">
  AI Act</sub> s’applique depuis le
  <say-as interpret-as="date"
    format="dmy">02/08/2026</say-as>.</s>
<s>Code d’accès
  <say-as
    interpret-as="characters">B7K2</say-as>.</s>
<s>Un modèle de
  <lang xml:lang="en-US">deep learning</lang>.</s>
La balise phoneme donne la prononciation exacte d’un mot, en alphabet phonétique international (IPA) de préférence, la valeur que la norme recommande à tous les moteurs. Réservez-la aux mots isolés : le W3C la destine aux mots et aux expressions très courtes.
Avec sub, un texte lu remplace le texte écrit, idéal pour les sigles qu’on développe. say-as indique la nature d’une chaîne : date, heure, téléphone, suite de caractères, nombre cardinal ou ordinal. Curiosité de la norme, SSML 1.1 ne fixe pas ces valeurs : elles viennent d’une note du W3C de 2005, qui définit aussi les formats de date comme dmy, l’ordre jour-mois-année des Français. Un moteur qui ne connaît pas une valeur doit lire le texte comme s’il n’y avait pas de balise.
Dernière venue, la balise lang date de la version 1.1 : elle signale un passage dans une autre langue, sans rien changer à la structure du texte. Il existe aussi emphasis, pour appuyer une phrase, avec quatre niveaux (strong, moderate, none, reduced). C’est la moins bien suivie des sept, on le verra.
Ce que lisent ElevenLabs, Google, Polly et Azure
Commençons par le plus restrictif. Selon sa documentation officielle, ElevenLabs ne lit que deux balises SSML. La pause break fonctionne sur les modèles v2 (Multilingual v2, Flash v2.5, Flash v2), jusqu’à 3 secondes, avec une mise en garde : trop de pauses dans une même génération rendent la voix instable. La balise phoneme, elle, ne marche qu’avec Eleven Flash v2, un modèle anglais seulement : inutile en français.
Eleven v3 et Eleven v4, sorti fin septembre 2026, ne lisent plus aucun SSML. Notre tuto ElevenLabs détaille le choix du modèle et le réglage de vitesse, de 0,7 à 1,2.
Google Cloud Text-to-Speech est le plus complet. Sa référence SSML couvre break, prosody, emphasis, sub, lang (« au mieux », prévient Google), onze valeurs de say-as et phoneme en IPA ou X-SAMPA, avec une table de phonèmes pour le français de France. Nuance de taille : les voix Chirp 3 : HD n’en lisent qu’une partie, en mode synchrone et pas en flux continu.
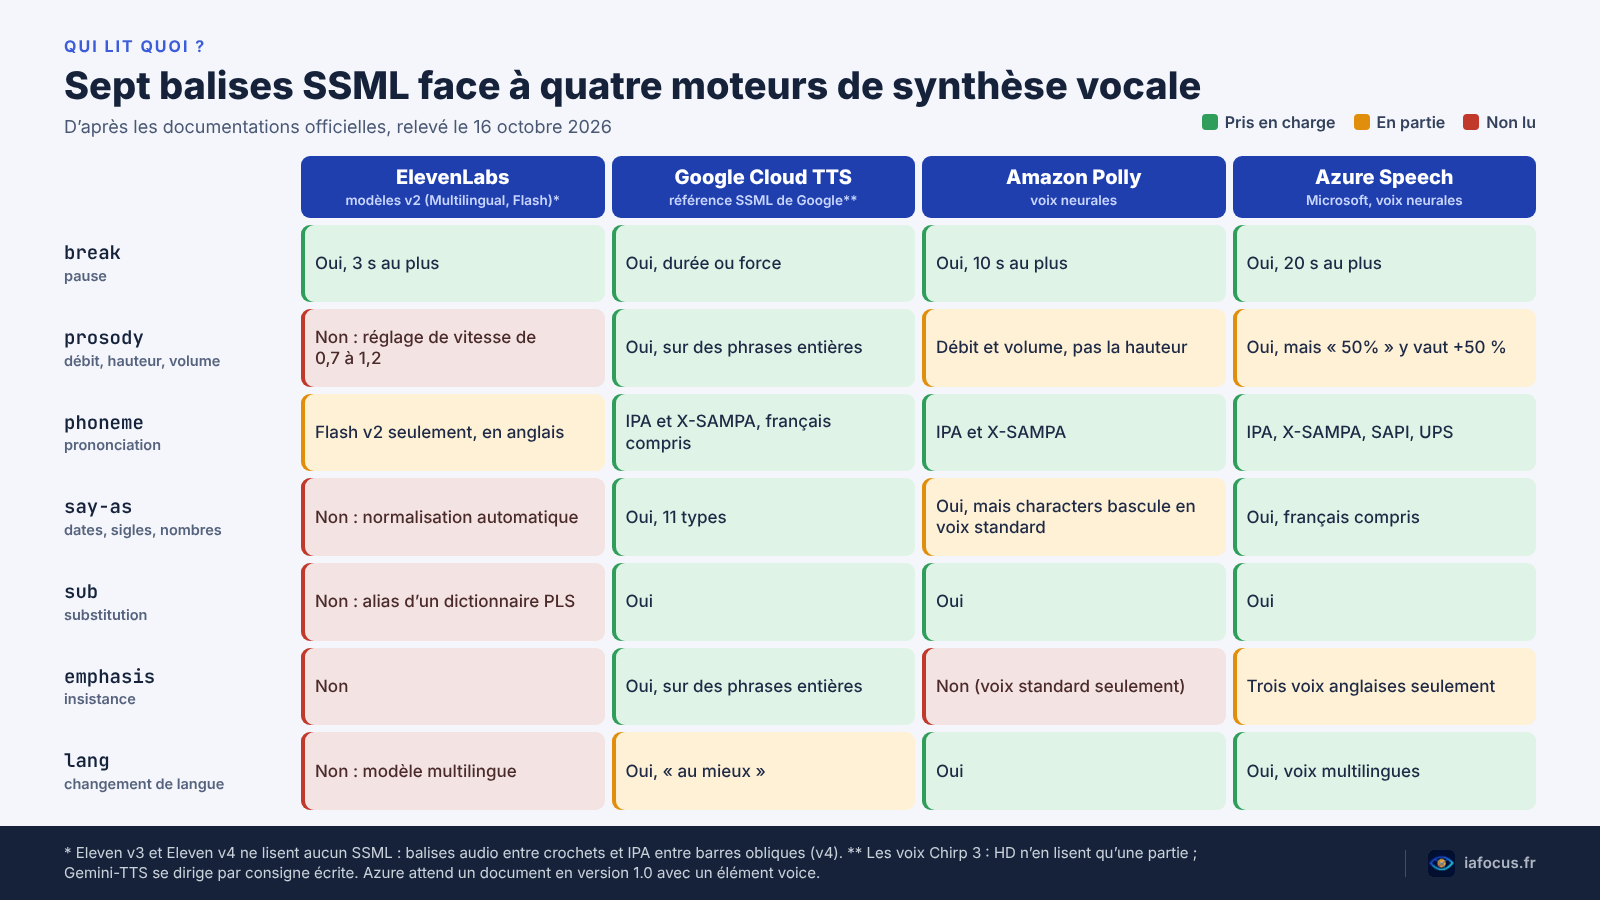
Amazon Polly annonce un sous-ensemble de SSML 1.1, et son tableau des balises précise ce que lit chaque type de voix. Sur les voix neurales, break, phoneme, sub et lang passent ; prosody perd la hauteur ; emphasis disparaît. Plus sournois : un say-as en mode characters fait basculer la phrase sur une voix standard, facturée au tarif neural. Et une balise non prise en charge provoque une erreur.
Azure Speech, enfin, s’appuie sur SSML 1.0 et l’exige dans l’en-tête : version="1.0" et au moins un élément voice qui nomme la voix. Un document 1.1 doit donc être adapté avant envoi. En échange, Azure accepte quatre alphabets phonétiques, des lexiques au format PLS et un say-as qui connaît le français. L’insistance, elle, reste réservée à trois voix anglaises.
Quand les balises SSML ne sont pas lues
De plus en plus de voix récentes délaissent le SSML au profit d’instructions en langage naturel. Faut-il s’en plaindre ? Pas forcément, mais il faut changer d’outils.
Chez ElevenLabs, Eleven v3 et v4 se dirigent par des balises audio entre crochets : [whispers], [sighs], [short pause], [long pause]. Les points de suspension ajoutent des silences, les majuscules de l’insistance. Pour la prononciation, Eleven v4 lit l’IPA écrit entre barres obliques directement dans le texte, avec des résultats variables selon la voix, d’après l’éditeur.
Le meilleur remède durable reste le dictionnaire de prononciation. Le W3C a normalisé son format, le PLS 1.0, en 2008, et c’est le format par défaut des lexiques de SSML 1.1 : une liste de mots associés à une transcription phonétique ou à un alias. ElevenLabs l’accepte dans Studio, Dubbing Studio et par l’API, mais ses règles phonétiques ne valent qu’avec Eleven v4, v3 et Flash v2, et seul v4 les applique hors de l’anglais. Ailleurs, place aux alias. Pour une marque, un nom de produit ou de ville qui revient partout, c’est l’option à privilégier, surtout si vous bâtissez une voix de marque IA.
Google suit la même pente. Les voix Chirp 3 : HD acceptent un champ markup avec [pause short], [pause] et [pause long], et Gemini-TTS se règle par une consigne écrite, du style « lisez sur un ton calme ». Sans aucun balisage, reste la méthode artisanale : ponctuation, nombres écrits en toutes lettres, phrases plus courtes, génération en plusieurs morceaux. Les mêmes recettes valent pour le doublage par IA.
Un exemple complet à tester, et l’AI Act
Voici un document entier, conforme à SSML 1.1, qui combine pause, phonème, date, suite de caractères et débit. Il passe la validation du schéma XML officiel du W3C. Reste à l’écouter chez Google ou Polly ; pour Azure, passez la version à 1.0 et ajoutez l’élément voice.
<speak version="1.1"
  xmlns="http://www.w3.org/2001/10/synthesis"
  xml:lang="fr-FR">
  <p>
    <s>Bienvenue à la mairie de
      <phoneme alphabet="ipa"
        ph="lɑ̃">Laon</phoneme>.</s>
    <break time="600ms"/>
    <s>Votre dossier
      <say-as
        interpret-as="characters">AB12C</say-as>
      est prêt depuis le
      <say-as interpret-as="date"
        format="dmy">14/10/2026</say-as>.</s>
  </p>
  <prosody rate="slow">
    <s>Munissez-vous d’une pièce
      d’identité.</s>
  </prosody>
</speak>
Écoutez le résultat avec la voix que vous publierez, pas avec une autre. En synthèse vocale, pauses comprises, chaque voix réagit à sa façon : ElevenLabs le rappelle dans sa documentation. Pour une vidéo, un podcast ou une voix off pour YouTube, gardez une version du script sans balises à côté de la version balisée.
Un mot de droit, enfin. Une voix bien réglée par des balises SSML reste une voix de synthèse. Depuis le 2 août 2026, l’article 50 du règlement européen sur l’IA impose aux fournisseurs de marquer l’audio généré dans un format lisible par machine, avec un délai jusqu’au 2 décembre 2026 pour les outils déjà sur le marché, ajouté par le règlement omnibus 2026/1744.
Un agent vocal doit aussi être conçu pour que l’appelant sache qu’il parle à une IA, sauf évidence. Et une voix qui imite une personne réelle au point de passer pour authentique relève de l’hypertrucage : celui qui la diffuse doit le signaler. Notre point sur ce qui s’applique déjà de l’AI Act détaille le calendrier, et notre guide pour reconnaître un deepfake audio montre l’autre côté du miroir.
Foire aux questions
ElevenLabs lit-il les balises SSML ?
En partie, et seulement sur les anciens modèles. La pause break, jusqu’à 3 secondes, fonctionne avec Multilingual v2 et les modèles Flash. La balise phoneme ne marche qu’avec Eleven Flash v2, en anglais. Eleven v3 et Eleven v4 n’en lisent aucune : ils se dirigent par des balises audio entre crochets, et v4 accepte l’IPA entre barres obliques.
Quelle est la pause la plus longue possible ?
La norme du W3C ne fixe pas de plafond. Les services, si : 3 secondes chez ElevenLabs, 10 secondes chez Amazon Polly, 20 secondes chez Azure, qui ramène toute valeur supérieure à ce maximum. Google ne publie pas de limite sur sa page de référence. Pour un silence plus long, mieux vaut couper le fichier audio au montage.
Faut-il écrire rate= »90% » ou rate= »-10% » ?
Selon SSML 1.1, « 90% » veut dire 90 % de la vitesse normale, et un débit négatif n’est pas prévu. Amazon Polly suit cette lecture. Azure, lui, lit les pourcentages comme des variations : « 90% » y accélère de 90 %, et « -10% » ralentit. Pour un script portable, utilisez plutôt slow ou x-slow.
Comment corriger la prononciation d’un nom propre français ?
En matière de prononciation, voix IA ou pas, la méthode reste la même. Avec Google, Polly ou Azure, une balise phoneme en IPA fait l’affaire pour un mot isolé, par exemple « mɛs » pour Metz. Pour un nom qui revient souvent, un dictionnaire au format PLS évite de répéter la balise. Chez ElevenLabs, les règles phonétiques en français demandent Eleven v4 ; sinon, passez par un alias, une orthographe proche du son.
Sources
- W3C : Speech Synthesis Markup Language (SSML) Version 1.1, recommandation du 7 septembre 2010
- W3C : SSML 1.0 say-as attribute values, note du 26 mai 2005
- W3C : Pronunciation Lexicon Specification (PLS) 1.0, recommandation du 14 octobre 2008
- EUR-Lex : règlement (UE) 2024/1689 (AI Act), article 50
- EUR-Lex : règlement (UE) 2026/1744 (omnibus sur l’IA)
- Commission européenne : cadre réglementaire de l’IA
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.