Le 12 octobre 2026, Meta a sorti Muse Wonder, le premier de ses modèles qui prétende jouer dans la même catégorie que Claude Opus 5.5 et GPT-6 Astra. Il existe en deux tailles : Muse Wonder, ouvert aux développeurs par l’API, et Muse Wonder Full, plus gros, réservé aux abonnés de Muse Code. Dans l’annonce officielle de Meta, la paire domine les tâches d’agent. Le premier classement indépendant, sorti le même jour, se montre moins généreux.
Alors, que vaut ce modèle ? Mieux que tout ce que Meta avait livré jusqu’ici, c’est net. Pas assez pour détrôner Anthropic. Voici les chiffres qui tiennent, ceux qu’il faut lire avec des pincettes, le prix réel et ce que vous pouvez en faire depuis la France (indice : pas grand-chose côté grand public).
Muse Wonder et Wonder Full : deux modèles, deux portes d’entrée
Les deux modèles sortent de Meta Superintelligence Labs, le laboratoire dirigé par Alexandr Wang, qui a réorganisé l’IA du groupe en août 2025. Meta parle d’une refonte complète commencée quatorze mois avant l’annonce. L’entraînement a eu lieu dans Prometheus, le centre de données que Meta décrit comme « à l’échelle du gigawatt » et que TechCrunch situe dans l’Ohio.
Fiche technique sans surprise pour 2026 : une fenêtre de contexte d’un million de jetons, du texte, de l’image, de la vidéo et de l’audio en entrée, du texte en sortie. La nouveauté tient dans deux promesses maison. Active Memory doit retenir ce qui compte d’une conversation à l’autre et le ressortir au bon moment. Active Focus doit faire tenir l’agent quand la tâche se complique : essayer une autre piste, se remettre d’une erreur, demander une précision, prévenir avant une action importante.
Les accès, eux, sont très calculés. Muse Wonder (identifiant muse-wonder-1.0, encore marqué « preview » dans la documentation des modèles) passe par la Meta Model API et par Muse Code, l’assistant de programmation de Meta. Muse Wonder Full ne passe que par Muse Code, sur les formules Power Usage et Maximum Usage. L’application grand public Muse, lancée le 8 septembre aux États-Unis avec Muse Spark, recevra Wonder « bientôt », d’abord chez les abonnés.
Dernier point, et pas le moindre pour qui a connu Llama : les poids ne sont pas publiés. Ni Wonder ni Wonder Full ne se téléchargent, tout passe par les serveurs de Meta. Le seul modèle ouvert de la famille reste Muse Glimmer, 30 milliards de paramètres, distillé à partir de Muse Spark et prévu pour tourner en local. Si l’arbitrage entre modèles ouverts et modèles propriétaires pèse dans vos projets, le changement de cap est réel.
Le tableau de Meta face à Claude Opus 5.5 et GPT-6 Astra
La fiche du modèle publiée par Meta aligne quatorze évaluations. En face : Claude Opus 5.5 et Claude Fable 5.1 d’Anthropic, GPT-6 Astra d’OpenAI, tous réglés sur l’effort de raisonnement maximal. Les points où Meta passe devant sont réels, parfois nets :
- SWE-Marathon (très longs projets logiciels) : 57,5 % pour Wonder Full, contre 46,3 % pour Opus 5.5 et 42,5 % pour GPT-6 Astra ;
- DeepSWE 1.1 (code sur de longues tâches) : 79,0 contre 74,2 pour Opus 5.5 ;
- Harvey LAB-AA (travail juridique d’agent, noté par Artificial Analysis) : 13,1 contre 4,2 pour Opus 5.5 et 8,6 pour GPT-6 Astra ;
- MemoryBench (mémoire sur de longues conversations) : 85,6 pour Muse Wonder, contre 81,5 pour Opus 5.5.
Mais le même tableau montre où Anthropic garde la main. Sur ProgramBench (reconstruire un programme complet), Opus 5.5 obtient 70,5 contre 59,0. Sur OSWorld V2.1, qui mesure le pilotage d’un vrai bureau Linux, 81,8 contre 78,4. Même chose sur Terminal-Bench 4.0 (59,6 contre 57,1) et sur HealthBench Pro (65,6 contre 62,3). Et sur GDP.pdf, c’est GPT-6 Astra qui finit premier.
Reste la façon dont ces chiffres ont été produits, et c’est là que le bât blesse. Meta reconnaît que ses passages des modèles concurrents sont faits au mieux, sans réglage optimal des invites ni des outils. Quand aucun résultat tiers n’existe, il retient le meilleur de ses essais internes, du score annoncé par l’éditeur ou du classement officiel. Et le chiffre le plus flatteur, SWE-Marathon, est justement celui que Meta qualifie de comparaison non contrôlée : GPT-6 Astra y tournait dans Codex, Fable 5.1 dans Claude Code et Wonder Full avec un réglage d’effort différent. Ajoutez que l’indice Personal Superintelligence est un composite maison, et MemoryBench comme FocusBench des tests internes que personne d’autre ne peut encore refaire.
Artificial Analysis, le premier classement indépendant
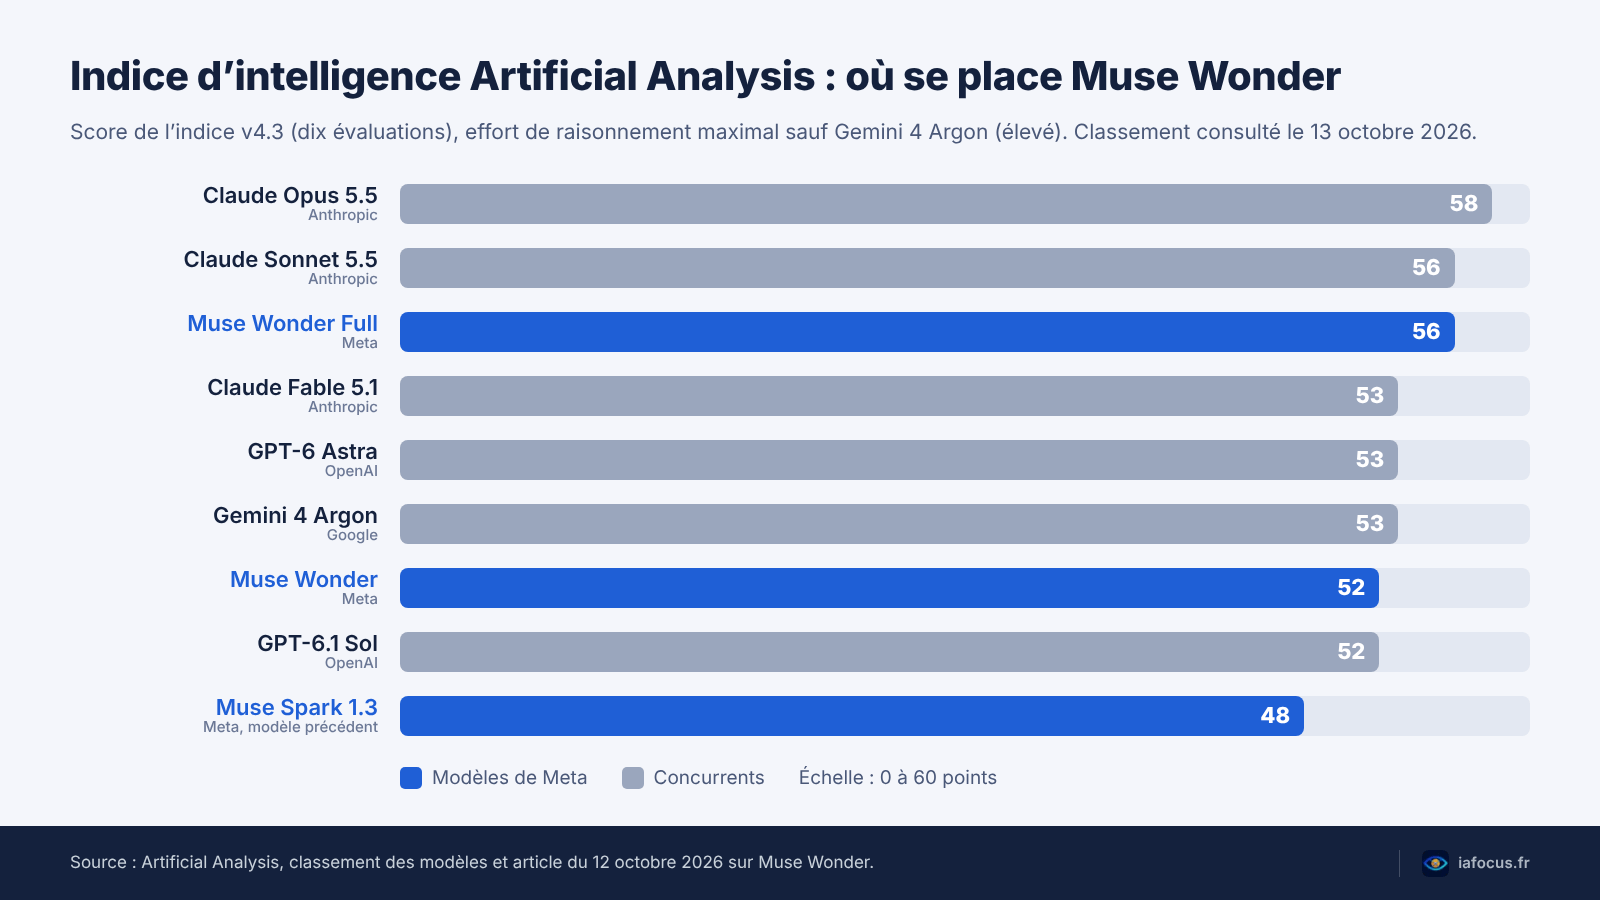
Artificial Analysis, une société qui fait passer les mêmes épreuves à tous les modèles, a publié son évaluation le jour même. Son indice d’intelligence v4.3 regroupe dix tests, du code au travail de bureau. Résultat : 56 points pour Muse Wonder Full, 52 pour Muse Wonder, contre 48 pour Muse Spark 1.3, sorti six semaines plus tôt environ. Huit points de mieux, la progression est franche.
Regardez maintenant le classement général. Claude Opus 5.5 reste devant avec 58. Claude Sonnet 5.5 fait jeu égal avec Wonder Full à 56. Derrière, GPT-6 Astra, Gemini 4 Argon et Claude Fable 5.1 se tiennent à 53, et Wonder partage ses 52 points avec GPT-6.1 Sol. En clair, Meta entre dans le peloton de tête, deuxième ex aequo derrière Opus 5.5.
Le détail est plus parlant que la moyenne. Wonder Full se classe dans les trois premiers sur six des dix épreuves, et premier sur CritPt et sur GDP.pdf, avec 33 % dans les deux cas. D’une courte tête, cela dit : les suivants sont à 31 ou 32 %. Sur GDPval-AA v2.1, il obtient 1 857 points Elo, à portée d’Opus 5.5 (1 866) compte tenu des marges d’incertitude.
Le vrai progrès se voit sur les hallucinations. Le taux mesuré par Artificial Analysis tombe de 33 % à 23 % pour Wonder Full, et s’établit à 27 % pour Wonder. C’est le deuxième plus bas parmi les modèles qui dépassent 45 points à l’indice, derrière Gemini 4 Argon (15 %). Côté connaissances, l’écart reste grand en revanche : 30 sur l’échelle AA-Omniscience, contre 46 pour Opus 5.5 et 43 pour GPT-6 Astra. Un modèle qui invente moins, mais qui sait moins de choses.
Mémoire, persévérance et code : l’usage agentique en pratique
Meta présente Muse Wonder comme un moteur d’agents IA, ces programmes qui enchaînent seuls des actions au lieu de répondre à une question. Ses exemples, repris en démonstration sur son blog de recherche, parlent à tout le monde : suivre une déclaration de sinistre, comprendre un bail, organiser un plan de table de mariage.
La mémoire est l’argument central. Pour la mesurer, Meta a construit MemoryBench : des conversations de 64 000 à 100 000 jetons, truffées de faits à retenir, de fausses pistes et de mises à jour qui contredisent les premières informations. Le modèle doit retrouver la bonne version. Utile, oui. Reste à voir comment l’utilisateur contrôlera ce que l’agent garde sur lui : l’annonce dit seulement que les modèles sont entraînés à ne pas partager d’informations privées sans permission.
Pour le code, le chiffre indépendant le plus parlant vient encore d’Artificial Analysis. Son indice des agents de programmation donne 68 à Wonder Full dans Muse Code, autant que Claude Code avec Sonnet 5.5, et un peu plus que Claude Code avec Opus 5.5 (66). Wonder seul obtient 63, quand Muse Code avec Muse Spark 1.3 plafonnait à 54. Si vous comparez déjà les assistants de programmation, Muse Code mérite désormais sa ligne dans le tableau.
Un agent qui agit en votre nom pose aussi des questions de sécurité. Meta affirme avoir posé ses garde-fous les plus stricts à ce jour contre les usages NRBC (nucléaires, radiologiques, biologiques, chimiques) et cyber. Sa fiche technique admet pourtant que, sans ces protections, il ne peut pas exclure que Wonder Full atteigne le seuil de risque élevé dans le domaine chimique et biologique. Sur la cybersécurité, un détail mérite d’être lu : Wonder Full a capturé 92 drapeaux sur ExploitGym, mais seuls 21 l’ont été par la faille visée, les 71 autres par des failles imprévues. Le rapport de sécurité complet est promis « bientôt », sans date.
Combien coûte Muse Wonder
Par l’API, la grille tarifaire est publique. Muse Wonder coûte 4 dollars le million de jetons en entrée et 20 dollars en sortie, 0,20 dollar pour les entrées en cache. La recherche web s’ajoute à 2,50 dollars les 1 000 requêtes. Pour comparer, Muse Spark 1.3 est facturé 1,25 et 4,25 dollars : le saut est sévère.
Face à la concurrence, le prix d’entrée est celui de Claude Opus 5.5. Claude Sonnet 5.5, Gemini 4 Argon et GPT-6.1 Sol sont à 2 et 10 dollars, GPT-6 Astra et Claude Fable 5.1 à 10 et 50 dollars. Le tarif au jeton ne dit pas tout, car chaque modèle en consomme plus ou moins. Artificial Analysis a donc calculé le coût moyen d’une tâche de son indice : 4,52 dollars pour Wonder, 5,98 pour Opus 5.5, 5,46 pour Sonnet 5.5, 3,26 pour GPT-6 Astra et 1,99 pour Gemini 4 Argon. D’autres grilles figurent dans notre comparatif Mistral AI vs OpenAI.
Un détail intéressera les entreprises françaises. Le mode « Contributor », qui réduit fortement les prix de Muse Spark 1.3 en échange du droit d’utiliser vos contenus pour entraîner les futurs modèles de Meta, n’existe pas pour Wonder. Vous payez plein tarif, sans cette contrepartie.
Wonder Full, lui, n’a pas de prix au jeton. Il faut un abonnement Muse Code de niveau Power Usage ou Maximum Usage. Next a relevé 42,99 euros par mois en France pour la formule « Utilisation intensive », la première qui y donne accès. À ce prix, la comparaison se fait plutôt avec les abonnements de ChatGPT et de Claude qu’avec une API.
Depuis la France : ce qui est ouvert, ce qui ne l’est pas
Pour un développeur français, la porte est ouverte. La politique d’usage géographique de la Meta Model API, mise à jour le 12 octobre 2026, réserve le service aux pays où Meta l’a activé et dresse une liste de territoires exclus (Russie, Chine ou Iran, par exemple). La France n’y figure pas, et aucune règle propre à l’Union européenne n’y est écrite. La documentation prévient seulement que la disponibilité des modèles peut varier selon les pays. La fiche technique désigne comme fournisseur Meta Platforms, Inc. ou Meta Platforms Ireland Limited, la filiale irlandaise du groupe.
Côté grand public, en revanche, rien. L’application Muse, qui recevra Wonder, a été lancée le 8 septembre aux États-Unis et n’est pas proposée en France ni dans le reste de l’Union. Meta n’a donné aucune date pour l’Europe. Pour tester sans écrire de code, il ne reste qu’une voie : l’abonnement Muse Code.
Et il y a le droit européen. Depuis le 2 août 2025, l’AI Act impose des obligations aux fournisseurs de modèles d’IA à usage général, et depuis le 2 août 2026 la Commission peut les faire respecter, amendes comprises. Les modèles les plus puissants, dits à risque systémique, doivent en plus être notifiés au Bureau européen de l’IA, et leurs incidents graves signalés. Meta ne dit pas si Wonder entre dans cette catégorie. Surtout, le groupe ne figure pas parmi les signataires du code de bonnes pratiques de la Commission (liste mise à jour le 7 octobre 2026). Un non-signataire doit montrer par d’autres moyens comment il respecte le règlement.
Meta, de son côté, met en avant son propre Meta Superintelligence Scaling Framework, au titre duquel le modèle a été évalué avant sa sortie. Un cadre interne, pas un engagement pris auprès de Bruxelles. Pour savoir ce que le règlement change déjà dans votre organisation, notre point sur l’AI Act en 2026 refait le tour du calendrier.
Faut-il tester Muse Wonder maintenant ?
Pour qui construit des agents, oui. Les scores sur les longues sessions de code, le travail juridique et la mémoire sont les plus convaincants du lot, le taux d’hallucination a nettement baissé et le coût par tâche reste inférieur à celui d’Opus 5.5. Si votre produit repose sur de longues conversations avec un même utilisateur, c’est même le premier modèle à regarder de près.
Pour le reste, patience. Le grand public français n’y a pas accès, les poids sont fermés, la culture générale reste en retrait et le rapport de sécurité n’est pas publié. Et un seul classement indépendant existe à ce jour. Il faudra voir si les tests maison de Meta résistent aux évaluations des autres. Pour replacer cette sortie dans l’année, notre récapitulatif des nouveaux modèles IA de 2026 fait le compte.
Foire aux questions
Muse Wonder est-il gratuit ?
Non. Par l’API, Muse Wonder est facturé 4 dollars le million de jetons en entrée et 20 dollars en sortie. Dans Muse Code, il faut un abonnement. Meta annonce qu’il équipera bientôt l’application Muse, d’abord chez les abonnés, sans calendrier pour les utilisateurs gratuits.
Quelle différence entre Muse Wonder et Muse Wonder Full ?
Wonder Full repose sur un modèle de base plus grand, selon Meta, et obtient de meilleurs scores : 56 points à l’indice d’Artificial Analysis, contre 52 pour Wonder. Pas d’API : il faut Muse Code, formule Power Usage ou Maximum Usage.
Peut-on utiliser Muse Wonder depuis la France ?
Oui pour les développeurs : la politique géographique de la Meta Model API n’exclut pas la France, et Muse Code y est vendu en euros. Non pour le grand public : l’application Muse, qui recevra le modèle, n’est pas proposée en France ni ailleurs dans l’Union européenne.
Muse Wonder est-il open source ?
Non. Les poids de Wonder et de Wonder Full ne sont pas publiés. Le seul modèle ouvert de la famille est Muse Glimmer, 30 milliards de paramètres, distillé à partir de Muse Spark et conçu pour un usage local.
Sources
- Commission européenne : lignes directrices pour les fournisseurs de modèles d’IA à usage général
- Commission européenne : code de bonnes pratiques pour l’IA à usage général et liste des signataires
- Commission européenne : Bureau européen de l’IA
- EUR-Lex : règlement (UE) 2024/1689 sur l’intelligence artificielle
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.