Le modèle Jev ne sait pas écrire une phrase, et c’est précisément ce qui vaut à son éditeur une valorisation de 7,5 milliards de dollars. Le 9 octobre 2026, la start-up californienne TypeSafe AI a annoncé une levée de 870 millions de dollars, quelques semaines à peine après la sortie de son premier modèle. Une IA non textuelle, donc : elle répond par des choix, des notes et des probabilités, jamais par du texte.
Sur le papier, la promesse est simple. Remplacer les grands modèles de langage partout où l’on n’a pas besoin de prose, mais d’une décision rapide et bon marché. Reste à savoir ce que l’on sait vraiment, au-delà des chiffres de l’entreprise. Et ce que cela change pour une organisation européenne.
Ce que TypeSafe vient d’annoncer
Les faits, d’abord, tels que les publie le billet officiel de TypeSafe. Il s’agit d’une série A de 870 millions de dollars, menée par Andreessen Horowitz, avec Sequoia Capital, DCVC (déjà présent au capital) et un groupe de business angels. Martin Casado, associé chez a16z, rejoint le conseil d’administration. La valorisation : 7,5 milliards de dollars.
Pour une entreprise dont le produit est encore en accès anticipé, le montant donne le vertige. D’après TechCrunch, le modèle était sorti le 15 septembre, et la société avait été fondée en 2024 par Diogo Almeida, ancien chercheur d’OpenAI, avec Sasha Sheng, passée par Meta, et l’entrepreneur Erik Gafni. Diogo Almeida dit lui-même avoir contribué aux méthodes de suivi d’instructions derrière ChatGPT, puis avoir passé deux ans en mode discret.
L’argument commercial tient en une phrase du communiqué : « un tiers du Fortune 500 » utiliserait déjà Jev. Aucun nom, aucun volume. C’est une revendication de l’éditeur, pas un chiffre audité, et il faut la lire comme telle.
Qu’est-ce que le modèle Jev, au juste ?
TypeSafe présente Jev comme le premier « System One Model ». Le nom vient du psychologue Daniel Kahneman, prix Nobel d’économie 2002, qui opposait la pensée rapide et intuitive (le Système 1) à la pensée lente et délibérée (le Système 2). Un modèle qui raisonne pas à pas, comme ceux décrits dans notre article sur le modèle de raisonnement IA, joue dans la seconde catégorie. Jev revendique la première.
Quant au prénom, il salue l’économiste William Stanley Jevons. Au XIXe siècle, celui-ci avait remarqué qu’une machine à vapeur plus économe en charbon faisait grimper la consommation de charbon au lieu de la réduire. Le pari de TypeSafe est le même : une intelligence beaucoup moins chère créera une demande bien plus grande.
Concrètement, comment ça marche ? Selon la documentation officielle, on envoie au modèle un « état » (les données d’un dossier, d’un ticket, d’une transaction) et une ou plusieurs questions typées. Trois formats existent. Choice choisit une option dans une liste. Score note la situation sur une grille. Noul dit si une affirmation est vraie, avec une valeur entre 0 et 1. Chaque réponse arrive avec une distribution de probabilités et, pour les deux premiers, un indice de confiance.
Ce que fait le modèle Jev, c’est donc l’équivalent d’un « if » intelligent dans un programme : faut-il rembourser, escalader, rejeter, router vers tel service ? Votre code fixe un seuil de confiance au-dessus duquel il agit seul, et en dessous duquel il demande l’avis d’un humain. Aucun texte à analyser, aucune réponse mal formée à rattraper.
Pourquoi une IA non textuelle irait plus vite
Un modèle de langage produit sa réponse mot après mot, ou plus exactement jeton après jeton. Chaque jeton de sortie coûte du calcul, donc du temps et de l’argent. Si vous demandez à un LLM de classer un ticket en « urgent » ou « normal », il génère du texte, que votre programme doit ensuite décortiquer. C’est lent, et parfois faux (le modèle répond « plutôt urgent, mais… »).
Une IA non textuelle supprime l’étape. Les sorties sont définies à l’avance, et TypeSafe affirme que son échantillonnage se fait en parallèle plutôt que jeton par jeton. Les questions posées sur un même état sont évaluées séparément et en même temps : en ajouter ne rallonge presque pas la réponse, d’après la documentation. L’éditeur annonce un temps de réponse de bout en bout compris entre 70 et 500 millisecondes, contre 3 à 329 secondes pour les modèles de pointe qu’il a mesurés.
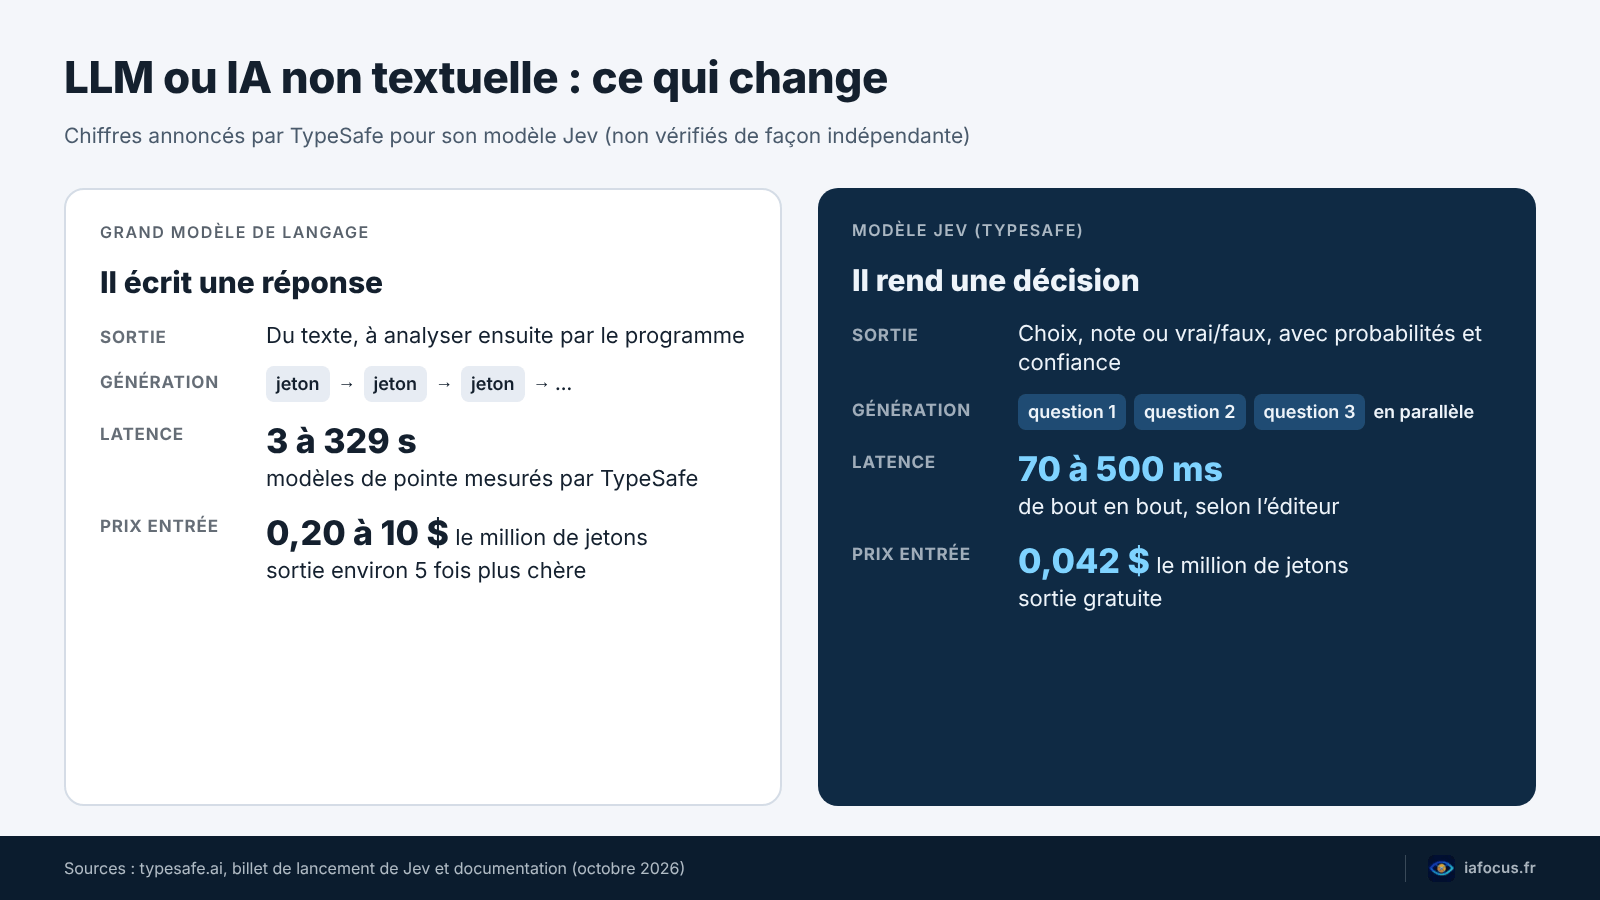
Le tarif suit la même logique. Jev coûte 42 dollars le milliard de jetons d’entrée, soit 0,042 dollar le million, et la sortie est gratuite. À titre de comparaison, TypeSafe situe les modèles de langage actuels entre 0,20 et 10 dollars le million de jetons d’entrée, avec une sortie environ cinq fois plus chère. Sa page d’accueil revendique un prix d’entrée 238 fois plus bas que Claude Fable 5.1. Même face aux petits modèles économiques, comme Claude Haiku 5.5 et son coût réel, l’écart annoncé reste énorme.
Une précision honnête figure dans le billet de lancement : l’entreprise reconnaît ne pas pouvoir prouver que ce prix n’est pas subventionné. Autrement dit, le tarif d’aujourd’hui n’engage pas celui de demain (même si TypeSafe dit s’attendre à une baisse).
Ce que valent les chiffres annoncés
Le slogan de la page d’accueil, « 193,6 fois plus rapide, 444,6 fois moins cher », repose sur des workflows de test : 0,114 seconde et 0,000081 dollar pour Jev, contre 8,566 secondes et 0,013880 dollar pour les LLM comparés. Spectaculaire. Mais le billet de lancement de Jev liste lui-même les limites de l’exercice, et elles pèsent lourd.
Les mesures de vitesse ont été faites depuis des ordinateurs portables sur la côte Ouest des États-Unis, sans vérification indépendante. Les quatre workflows publiés ont été construits par l’équipe de TypeSafe. Les réponses de référence sont une moyenne de GPT-6 Astra et de Fable 5.1, ce qui avantage les modèles d’OpenAI et d’Anthropic. Les LLM passaient par une enveloppe logicielle qui les ralentit, et sur l’un des tests, ils tournaient sans leur mode de raisonnement. Franchement, c’est plus de transparence que la moyenne du secteur. Mais ce ne sont pas des résultats indépendants.
Le seul chiffre client détaillé vient d’une étude de cas publiée par TypeSafe avec Jack & Jill, une plateforme de recrutement pilotée par des agents. Jev y a remplacé Gemini 3.1 Flash Lite à une étape du tri des candidats, en dix jours. Résultat déclaré sur 150 postes réels : un coût divisé par huit (0,092 dollar contre 0,755 pour 1 000 candidats, soit 88 % d’économie) et un temps médian passé de 20,3 à 10,3 secondes par candidat. La qualité ? Le taux de bons profils gardés sur la liste courte passe de 93,9 à 94,6 %, un écart que l’étude juge elle-même non significatif.
Bref, Jev ferait aussi bien pour beaucoup moins cher sur ce cas précis. C’est déjà intéressant. Ce n’est pas encore une preuve générale.
Reste la promesse la plus audacieuse : « zéro hallucination ». Le modèle Jev ne peut pas inventer une référence ou une citation, puisqu’il ne produit pas de texte, et il ne commet jamais d’erreur de type, selon l’éditeur. Mais une probabilité mal calibrée sur une mauvaise réponse reste une erreur, simplement plus discrète. Tout repose sur la qualité du calibrage, entraîné par une méthode maison baptisée RLCD (apprentissage par renforcement pour décisions calibrées). C’est là qu’il faudra des tests externes.
Les usages visés, et ceux qui ne le sont pas
TypeSafe ne prétend pas remplacer ChatGPT. Les assistants conversationnels, les copilotes et les agents de code qui dialoguent avec un humain restent, selon elle, le terrain des LLM. Jev vise tout ce qui se passe sans personne devant l’écran : classer, router, noter, extraire, choisir une branche dans un processus.
Les exemples donnés par l’éditeur couvrent quatre familles :
- les workflows automatisés, ces fameux « if » intelligents au milieu d’un traitement ;
- le passage en revue de gros volumes de données, pour en tirer des indicateurs ;
- les applications temps réel, où une centaine de millisecondes compte pour l’expérience ;
- la vérification : notation, contrôle de sortie d’un autre modèle, détection de tentatives de contournement.
Ce dernier point rejoint un usage très concret pour les entreprises qui déploient des agents IA pour automatiser leurs tâches : chaque étape d’un agent est une décision, et une décision à 100 millisecondes et presque gratuite change l’équation économique. Un agent IA de service client pourrait ainsi confier le tri des demandes à un modèle comme Jev et garder un LLM pour rédiger la réponse.
Les limites sont nettes. Pas de texte libre, par construction. Un nombre d’options plafonné à 255 par question (au-delà, deux étapes et une réponse plus lente). Et la démonstration la plus médiatisée, un bot qui joue à Doom à environ dix décisions par seconde pour quelque 7 dollars de l’heure, travaille sur une description textuelle du jeu, pas sur l’image. TypeSafe concède d’ailleurs qu’un bot classique, sans IA, jouerait mieux. L’honnêteté est appréciable ; elle rappelle aussi que la démo sert d’abord la communication.
AI Act et RGPD : ce que le modèle Jev change pour une entreprise européenne
Le cas d’usage mis en avant par TypeSafe, le tri de candidats, n’est pas anodin vu d’Europe. Le règlement (UE) 2024/1689, dit AI Act, classe à haut risque, dans son annexe III (point 4), les systèmes destinés au recrutement : filtrer les candidatures, évaluer les candidats. L’article 6, paragraphe 3, prévoit une soupape pour les tâches procédurales étroites, mais un système qui fait du profilage de personnes reste toujours à haut risque.
Le calendrier a bougé cet été. Le règlement (UE) 2026/1744 du 8 juillet 2026, le « Digital Omnibus » sur l’IA, a reporté les obligations de l’annexe III du 2 août 2026 au 2 décembre 2027. Un délai, pas une dispense : notre article sur l’AI Act 2026 et ce qui s’applique déjà détaille ce qui court dès maintenant.
Le RGPD, lui, n’attend pas. Son article 22 interdit en principe de soumettre une personne à une décision fondée exclusivement sur un traitement automatisé, quand elle produit des effets juridiques ou l’affecte de manière significative. Les exceptions (contrat, loi, consentement explicite) imposent des garanties : la personne peut obtenir une intervention humaine, exprimer son point de vue et contester, comme le rappelle la CNIL dans sa fiche sur la décision entièrement automatisée.
Or c’est exactement la promesse de Jev : laisser le logiciel agir seul au-dessus d’un seuil de confiance. Pour une décision sur une personne (un candidat, un client, un assuré), ce seuil ne peut pas devenir un pilote automatique. Le piège est là. La bonne pratique consiste à réserver l’automatisation complète aux décisions sans effet significatif sur quelqu’un, et à faire relire le reste.
Un dernier point, moins visible : la page d’introduction de la documentation ne dit rien de la localisation des données, de leur conservation ni des régions d’hébergement. Avant d’y envoyer des données personnelles, ces questions se posent au fournisseur, par écrit. Notre article sur l’AI Act pour les entreprises, selon votre rôle aide à savoir si vous seriez simple déployeur ou requalifié en fournisseur.
Faut-il tester le modèle Jev maintenant ?
Pour une équipe technique qui fait déjà tourner des LLM sur des tâches de tri ou de classement, oui, sans doute. L’accès anticipé se fait par une liste d’attente, l’essai coûte peu, et l’étude Jack & Jill donne une méthode de comparaison reproductible : même jeu de données, même métrique, deux modèles côte à côte. Si votre facture d’API vient surtout de petites décisions répétées des millions de fois, l’enjeu financier est réel.
Pour le reste, prudence. Les chiffres sont ceux de l’éditeur, le prix n’est pas garanti, et la valorisation de 7,5 milliards rémunère un potentiel plus qu’un historique. Et puis l’idée même n’a rien d’absurde : des classifieurs spécialisés existaient bien avant ChatGPT. La nouveauté revendiquée tient au niveau d’intelligence annoncé, comparable aux LLM sur ce type de tâches, pour un coût sans commune mesure.
Notre avis ? Le modèle Jev mérite d’entrer dans la liste des nouveaux modèles IA de 2026 à surveiller, moins pour ses records que pour l’idée qu’il défend : tous les problèmes d’IA ne sont pas des problèmes de texte. Si des tests indépendants confirment ne serait-ce qu’une partie des écarts annoncés, beaucoup d’architectures d’agents vont être redessinées.
Foire aux questions
Le modèle Jev peut-il remplacer ChatGPT ?
Non. Jev ne produit aucun texte libre : il rend des choix, des notes et des probabilités. TypeSafe le destine aux décisions automatisées dans les logiciels (trier, router, vérifier) et laisse explicitement la conversation, la rédaction et le code aux modèles de langage. Les deux sont complémentaires : un LLM pour écrire, une IA non textuelle pour décider vite.
Combien coûte Jev ?
D’après TypeSafe, 42 dollars le milliard de jetons d’entrée, soit 0,042 dollar le million, et la sortie est gratuite. L’éditeur reconnaît ne pas pouvoir garantir que ce tarif n’est pas subventionné. Le modèle est en accès anticipé, sur liste d’attente.
Qui a investi dans TypeSafe ?
La série A de 870 millions de dollars, annoncée le 9 octobre 2026, est menée par Andreessen Horowitz, avec Sequoia Capital, DCVC et des business angels. Elle valorise l’entreprise à 7,5 milliards de dollars. Martin Casado, d’a16z, rejoint le conseil d’administration.
Peut-on utiliser Jev pour trier des CV en France ?
Techniquement oui, mais le cadre est strict. L’AI Act classe le recrutement à haut risque (obligations applicables au 2 décembre 2027), et le RGPD encadre déjà toute décision entièrement automatisée qui affecte une personne. Une relecture humaine des décisions et une analyse préalable des données envoyées s’imposent.
Sources
- Règlement (UE) 2024/1689 sur l’intelligence artificielle (AI Act), EUR-Lex.
- Règlement (UE) 2026/1744 du 8 juillet 2026 (Digital Omnibus sur l’IA), EUR-Lex.
- Règlement (UE) 2016/679 (RGPD), article 22, EUR-Lex.
- Profilage et décision entièrement automatisée, CNIL.
- Entrée en vigueur du règlement européen sur l’IA : les questions-réponses, CNIL.
- Cadre réglementaire de l’IA, Commission européenne.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.