Chez OpenAI, mathématiques rime désormais avec volume. Le 6 octobre 2026, l’entreprise a versé d’un coup sur GitHub plus de 700 manuscrits produits par un modèle interne qu’elle n’a pas nommé. Des démonstrations, des réfutations, des conjectures célèbres présentées comme tranchées. Trois jours plus tard, The Verge publiait les réactions de plus de trois douzaines de mathématiciens, entre admiration et sidération.
Qu’a-t-on vraiment entre les mains, côté OpenAI ? Mathématiques de très haut niveau, en partie vérifiées par ordinateur, en partie pas du tout. Et une communauté qui se demande comment absorber tout cela sans y laisser ses jeunes chercheurs. Voici ce que dit la source primaire, et ce qui reste à prouver.
Publication OpenAI : mathématiques en 719 manuscrits
Le point de départ est une note sobre, publiée le 6 octobre dans la rubrique Recherche du site d’OpenAI sous le titre « Partager les progrès de l’IA en mathématiques ». Quelques paragraphes. L’essentiel est ailleurs, dans le dépôt openai/math, ouvert le même jour sous licence Apache 2.0.
Les chiffres, tels qu’OpenAI les donne : 719 manuscrits regroupés en 372 « familles » de résultats, classées par discipline, de la théorie des nombres à la physique mathématique. La presse comptait 722 manuscrits à la sortie ; trois ont été retirés le lendemain, on y reviendra. Le modèle a reçu environ 4 000 problèmes, et chaque résultat retenu a consommé en moyenne l’équivalent de trois heures de réflexion de ChatGPT Pro.
Ce n’est pas un article de recherche unique, ni un dépôt arXiv. Pas de nom de modèle non plus : le README parle d’un « modèle interne OpenAI non publié ». Côté transparence, l’entreprise ajoute dix résumés abrégés du raisonnement du modèle et des formalisations dans Lean, l’assistant de preuve qui permet de faire vérifier une démonstration par une machine.
OpenAI avait déjà publié le 1er août « Dix avancées en mathématiques et en informatique théorique », puis le 8 septembre une proposition de solution sur Navier–Stokes. Si le sujet des modèles de raisonnement vous est moins familier, retenez ceci : ces systèmes « réfléchissent » longtemps avant de répondre, et c’est précisément ce temps de calcul que l’entreprise chiffre ici.
Riemann, Hodge, Kakeya : des titres qui donnent le vertige
La table des matières fait défiler des noms que l’on croise d’habitude dans les listes de prix : problèmes d’Erdős en série, conjecture de Kaplansky réfutée, fractions égyptiennes courtes. Prenons trois exemples, de près, parce que les intitulés vont plus vite que le contenu.
D’abord la famille 003, baptisée « hypothèse de quasi-Riemann ». Elle affirme que les fonctions L de Dirichlet, zêta comprise, n’ont aucun zéro dans le demi-plan où la partie réelle dépasse 7/8. Considérable, s’il tient. Mais ce n’est pas l’hypothèse de Riemann, qui porte sur la droite de partie réelle 1/2 et reste l’un des sept problèmes du millénaire. Bonne nouvelle : ses résultats principaux sont formalisés en Lean. Détail qui compte, le README précise que ce travail sur zêta a suivi une procédure différente du reste, et qu’une des rédactions a été retouchée par un humain.
Ensuite la famille 032 : la conjecture de Hodge rationnelle pour les variétés abéliennes à multiplication complexe. Un cas particulier, donc, d’un autre problème du millénaire. Ses résultats, eux, ne sont pas formalisés en Lean dans le catalogue.
Enfin Kakeya (famille 074). Le dépôt openai/math revendique la conjecture maximale en dimension 3 et la conjecture sur la dimension de Hausdorff en dimension 4. L’Union mathématique internationale a remis en 2026 une médaille Fields à Hong Wang, entre autres pour ses avancées sur le problème de Kakeya en dimension 3. Là encore, pas de lien Lean dans le catalogue.
Vous voyez le motif. Dans ce catalogue OpenAI, mathématiques spectaculaires et preuves vérifiées ne vont pas toujours ensemble.
Lean, 42 % : ce qui est vraiment vérifié
Une démonstration formalisée en Lean est vérifiée ligne à ligne par un programme. Si le code compile et que l’énoncé formel correspond bien à l’énoncé du papier, le doute logique disparaît, même si personne n’a encore compris l’idée. D’où l’intérêt des résultats formalisés en Lean : on peut s’y fier avant même de les avoir compris.
Or, d’après l’historique du dépôt openai/math, seuls 300 résultats principaux sur 719 étaient formalisés en Lean au 7 octobre, soit environ 42 %. OpenAI le dit sans détour dans son README : certains résultats non formalisés « pourraient avoir des problèmes ». Le dépôt l’assume, au moins.
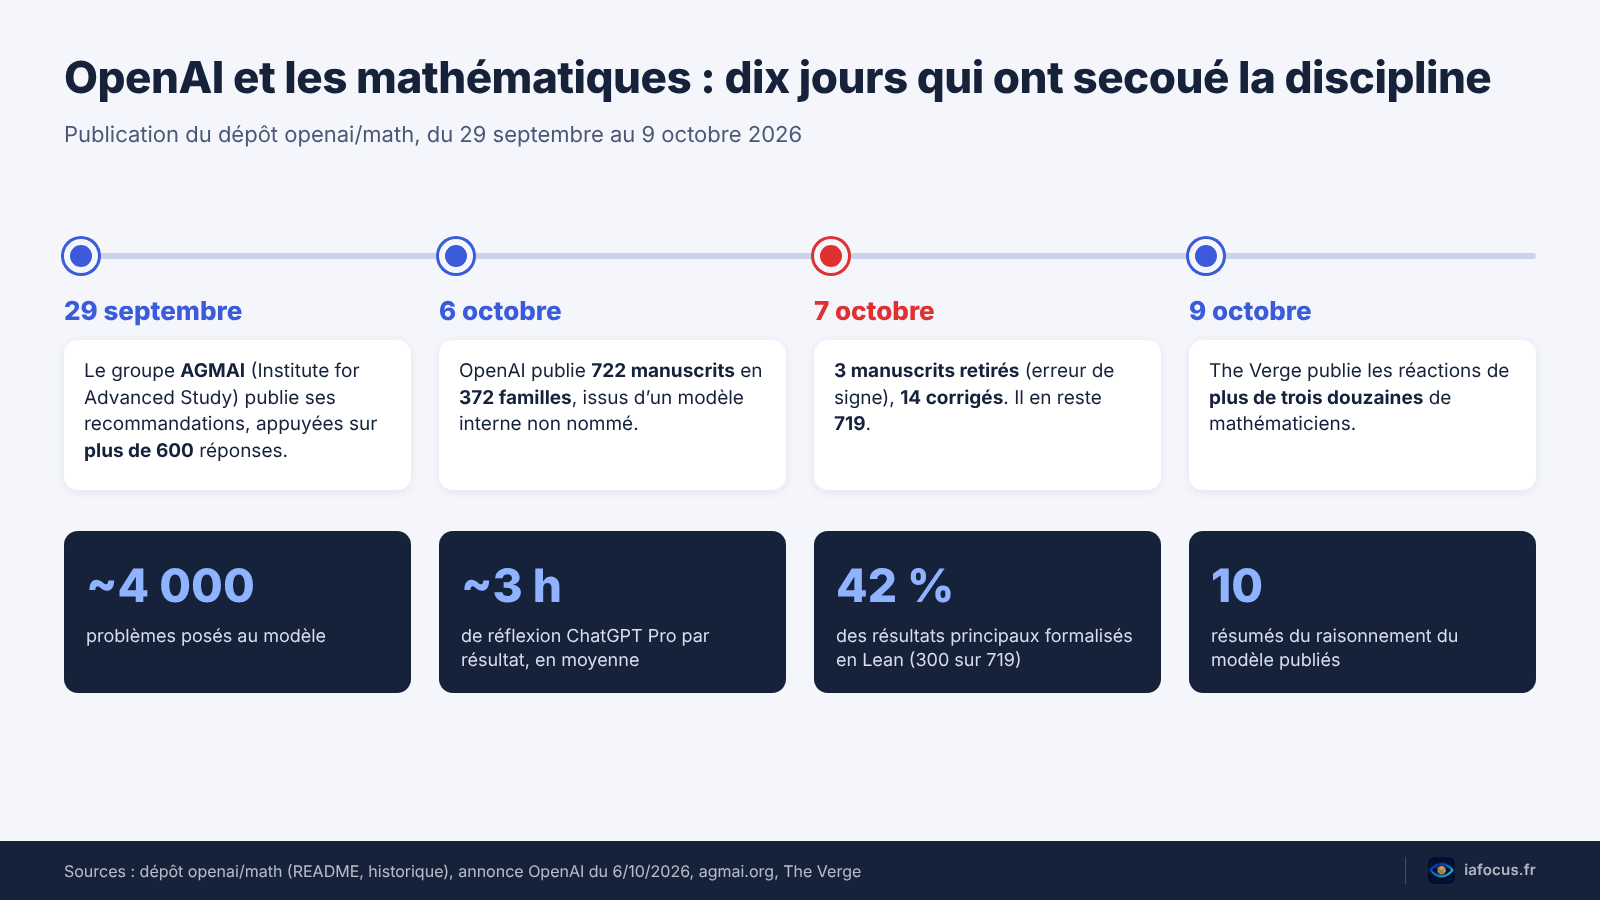
La preuve que la prudence s’imposait est arrivée dès le 7 octobre. Une erreur de signe dans un manuscrit sur les classes de Weil a invalidé un argument, et avec lui deux papiers qui en dépendaient, dont l’un annonçait la conjecture de Hodge rationnelle pour les produits de surfaces K3. Trois manuscrits retirés, donc. Quatorze autres ont été corrigés (réparations de preuves, hypothèses clarifiées), et treize mis à jour pour citer les nouvelles versions. OpenAI promet de garder l’historique public de chaque version. C’est sain.
Et même la formalisation n’est pas une baguette magique. Des chercheurs interrogés par The Verge notent que les énoncés vérifiés en Lean ne collent pas toujours exactement aux affirmations des manuscrits. Il faut donc vérifier la vérification. Kevin Buzzard (Imperial College de Londres) résume le dilemme : dans son domaine, la théorie algébrique des nombres, il a repéré une demi-douzaine de théorèmes marquants, peu ou pas formalisés. Il lui reste à lire un texte peut-être faux, ou à attendre qu’un autre s’en charge.
Ce qu’en disent les mathématiciens
Les mots recueillis par The Verge vont de « vertigineux » à « pure folie ». Ce qui frappe, dans le dossier OpenAI mathématiques, c’est l’écart entre la qualité perçue des idées et celle des textes.
Côté idées, Jared Duker Lichtman (Stanford) estime que « des dizaines » de résultats seraient du niveau d’une médaille Fields. Scott Armstrong, joint à Paris, rappelle qu’il ne s’agit pas de petits problèmes obscurs mais de questions sur lesquelles beaucoup ont buté pendant des décennies. Constantin Kogler, de l’Institute for Advanced Study, parle même du moment le plus important de l’histoire des mathématiques.
Côté textes, c’est autre chose. Brendan Hassett (Brown) a trouvé la rédaction du problème qu’il connaît le mieux à peu près incompréhensible en première lecture. Nalini Joshi (Sydney) relève des bibliographies très courtes et redoute une attribution incomplète des idées. Franchement, c’est le vrai point faible : une démonstration que personne ne peut suivre ne sert pas à grand-chose à la communauté, même juste.
Lichtman ajoute une nuance intéressante. À ses yeux, tous ces résultats, aussi impressionnants soient-ils, sortent de méthodes et de techniques existantes. Ils remplissent la carte connue plutôt qu’ils n’en dessinent une nouvelle. Ce qui laisse aux humains un rôle, et pas des moindres : relier, expliquer, inventer les questions suivantes.
Doctorants et jeunes chercheurs en première ligne
Le choc le plus concret touche les carrières. Un problème ouvert, c’est souvent la colonne vertébrale d’une thèse ou d’une demande de financement. Quand une machine le referme du jour au lendemain, des années de plans tombent.
Colva Roney-Dougal (St Andrews) raconte que des amis et collègues ont vu leurs demandes de financement « balayées ». Tristan Buckmaster (NYU) cite trois personnes dont le programme de recherche entier a été anéanti. Simon Machado, mathématicien à l’ETH Zurich qui rejoint le CNRS, juge la situation très perturbante pour quiconque arrive en fin de financement ou cherche un poste. Et Bartosz Naskręcki (Poznań) va plus loin : selon lui, ce rythme peut faire s’effondrer la culture académique, un problème social que les laboratoires d’IA ignoreraient.
On retrouve ici une question que nous suivons secteur par secteur dans notre dossier sur l’IA et l’emploi. La différence ? Avec OpenAI, mathématiques et carrières ont été bousculées en quelques jours, pas en quelques années.
AGMAI : les règles que les mathématiciens avaient fixées
OpenAI dit avoir consulté le groupe consultatif sur les mathématiques et l’IA (AGMAI), rattaché à l’Institute for Advanced Study de Princeton. Ses neuf membres, bénévoles, conseillent mais ne décident de rien. Deux d’entre eux enseignent en France : François Charles (ENS-PSL) et Timothy Gowers, titulaire de la chaire de combinatoire du Collège de France, aux côtés de Martin Hairer ou Edward Witten.
Le 29 septembre, ce groupe avait publié des recommandations pour une publication responsable, nourries par plus de 600 réponses à une enquête. En gros :
- citer la littérature et livrer des papiers lisibles ;
- déposer les résultats dans des archives que les laboratoires ne contrôlent pas ;
- publier le nom du modèle, les prompts, le temps et le coût de calcul ;
- formaliser autant que possible et dire combien de problèmes ont échoué ;
- cesser de tester des problèmes avancés sur des modèles propriétaires inaccessibles aux autres.
Le bilan est mitigé. OpenAI a cherché un compromis. Elle a suivi une partie de la liste, versions conservées, formalisations partielles, résumés de raisonnement, nombre de problèmes posés, temps de calcul moyen. Elle promet aussi de financer ateliers, conférences et programmes, sans détail pour l’instant. En revanche, ni nom de modèle ni prompts, un dépôt hébergé sur GitHub plutôt que dans une archive indépendante, et un modèle toujours fermé.
AGMAI a réagi le jour même en parlant d’une « première étape » et en refusant d’y voir une validation. Le groupe insiste sur un point qui dépasse OpenAI : la recherche mathématique ne peut pas se résumer à comprendre des résultats produits par des laboratoires.
Pourquoi OpenAI publie, et ce que cela change en Europe
Pourquoi OpenAI publie-t-elle tout cela ? L’entreprise le dit elle-même : elle juge important de continuer à évaluer ses modèles internes en mathématiques et dans d’autres sciences, et travaille à la mise à disposition « responsable » du modèle qui a produit ces résultats. En clair, l’entreprise vise une démonstration de force scientifique autant qu’un progrès des connaissances. Le terrain est bien choisi : une démonstration se contrôle, une prédiction beaucoup moins.
Pour les chercheurs européens, le dossier OpenAI mathématiques pose d’abord la question de l’accès. AGMAI met en garde contre un système à deux vitesses, où les laboratoires disposant de modèles internes distanceraient le reste du domaine. C’est tout le débat entre modèles ouverts et propriétaires, transposé à la recherche fondamentale. La Commission européenne a lancé sa stratégie pour l’IA dans la science, avec un institut virtuel, RAISE, dont le pilote dispose de 107 millions d’euros au titre d’Horizon Europe. Reste à savoir si ce pilote suffira à garantir l’accès équitable que réclame AGMAI, quand les outils les plus puissants restent des modèles internes que personne d’autre ne peut utiliser.
Côté règles, rien de neuf : le cadre posé par la réglementation européenne de l’intelligence artificielle ne dit pas comment publier une démonstration produite par une machine. Ce sont les communautés savantes qui écrivent ces normes, et la présence de mathématiciens basés en France dans AGMAI n’est pas un détail.
Les limites, et la suite
Reste l’essentiel : dans le dossier OpenAI mathématiques, personne ne sait encore combien de résultats tiendront. Trois retraits dès le lendemain, 58 % de résultats principaux non formalisés, des textes difficiles à suivre. Armstrong résumait l’ampleur du chantier d’une image : même si les IA disparaissaient demain, on aurait de quoi étudier pendant dix ans.
Il y a aussi le rythme. D’après The Verge, des rumeurs de nouvelles publications circulent déjà. Que vise OpenAI ? Recherche fondamentale ou vitrine ? Sans doute les deux. Les nouveaux modèles de l’année se comparaient surtout sur des tests de référence. Cette fois, on parle de théorèmes. Reste à voir si la concurrence, déjà vive entre OpenAI, Google et Mistral, se déplacera sur ce terrain.
Notre avis ? Le dépôt openai/math est à la fois un événement scientifique et une opération de communication. Chaque titre du genre « l’IA résout X » mérite donc d’attendre la relecture des spécialistes, et si possible des résultats formalisés en Lean. Mais tant que le modèle restera fermé et les prompts secrets, la communauté devra faire seule le travail de vérification, à ses frais. Pour suivre la suite, notre revue de l’actualité de l’IA fera le point au fil des corrections.
Foire aux questions
OpenAI, mathématiques : qu’a publié l’entreprise le 6 octobre 2026 ?
Le dépôt openai/math, sur GitHub, contient aujourd’hui 719 manuscrits regroupés en 372 familles de résultats, produits par un modèle interne non publié. Environ 42 % des résultats principaux sont formalisés en Lean, et dix résumés du raisonnement du modèle sont publiés.
OpenAI a-t-elle démontré l’hypothèse de Riemann ?
Non. Le dépôt openai/math revendique une « hypothèse de quasi-Riemann » : aucun zéro des fonctions L de Dirichlet pour une partie réelle supérieure à 7/8. L’hypothèse de Riemann porte sur la droite de partie réelle 1/2 et reste ouverte. Le résultat sur 7/8 est formalisé en Lean, mais il doit encore être lu et validé par les spécialistes.
Les résultats ont-ils été vérifiés ?
En partie seulement. Environ 300 résultats principaux sur 719 sont formalisés en Lean, ce qui garantit leur logique si l’énoncé formel correspond au manuscrit. Les autres attendent une relecture humaine. Trois manuscrits ont déjà été retirés le 7 octobre pour une erreur de signe, et quatorze corrigés.
Peut-on utiliser le modèle qui a produit ces preuves ?
Pas pour l’instant. OpenAI n’a pas donné son nom. L’entreprise dit travailler à une mise à disposition « responsable », sans date. Les prompts utilisés n’ont pas été publiés non plus, contrairement à ce que recommandait le groupe consultatif AGMAI.
Sources
- Advisory Group on Mathematics and Artificial Intelligence (Institute for Advanced Study), « On OpenAI’s Release of Mathematical Results », 6 octobre 2026 : agmai.org
- AGMAI (Institute for Advanced Study), « Responsible Release of AI-Generated Mathematics », 29 septembre 2026 : recommandations générales
- Union mathématique internationale, médailles Fields 2026
- Commission européenne, European AI in Science Strategy (RAISE)
- Collège de France, chaire Combinatoire de Timothy Gowers
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.