En bref
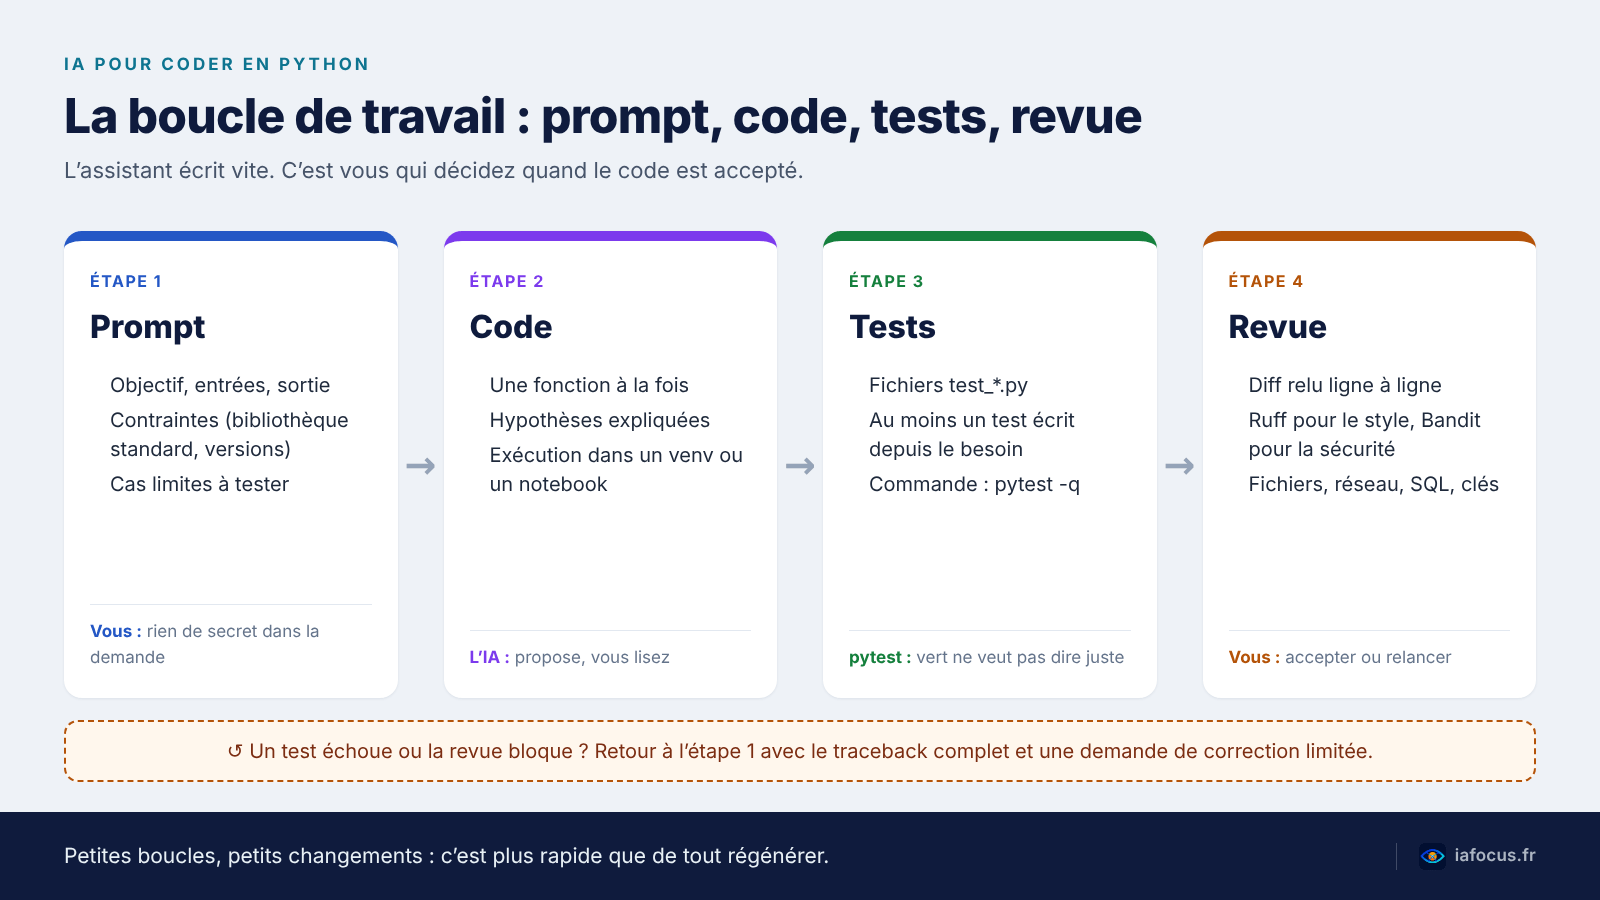
- Une demande précise (objectif, entrées, sortie, contraintes, cas limites) donne un code Python bien plus exploitable qu’un vague « écris-moi un script ».
- Faites écrire les tests pytest avant d’accepter quoi que ce soit, et rédigez au moins un test vous-même, à partir du besoin.
- Relisez chaque changement : Ruff pour le style, Bandit pour les failles courantes, un environnement virtuel pour exécuter sans risque.
- Dans Google Colab, rangez les clés dans les secrets du notebook et effacez les sorties avant de partager.
Sommaire
Utiliser une IA pour coder en Python, c’est gagner un temps fou sur les dix premières lignes d’un script, puis en perdre parfois autant à comprendre pourquoi la onzième plante. Le modèle écrit vite, avec aplomb, et il se trompe avec le même aplomb.
La bonne nouvelle : la méthode qui marche tient en quatre gestes. Une demande précise, des tests, une relecture, une boucle courte quand quelque chose casse. Ce guide de l’IA pour coder en Python les détaille avec des exemples concrets, des commandes à copier et les pièges qui reviennent le plus souvent, du notebook Colab au dépôt Git.
IA pour coder en Python : ce que les outils font vraiment
Trois familles d’outils se partagent le travail. La complétion dans l’éditeur propose la suite de la ligne ou de la fonction pendant que vous tapez. Le chat répond à une question, explique un bloc, propose une correction. L’agent, lui, reçoit une tâche, lit plusieurs fichiers, lance des commandes et modifie le dépôt.
Cet article ne compare pas les assistants un par un : si c’est ce que vous cherchez, notre comparatif des IA pour programmer s’en charge. Ici, on s’intéresse à la façon d’utiliser une IA pour coder en Python au quotidien. Voici tout de même ce que disent les pages officielles, consultées le 5 octobre 2026.
| Outil | Ce qu’il fait | Accès (pages officielles, octobre 2026) |
|---|---|---|
| GitHub Copilot | Complétion, chat et agent dans VS Code, Visual Studio, les IDE JetBrains, Eclipse, Vim ou Neovim | Offre Free : 2 000 complétions et 50 requêtes de chat par mois ; Pro à 10 dollars par mois |
| Codex (OpenAI) | Agent de code : application de bureau, extension d’éditeur, terminal, cloud ; lance des tests et des commandes, travaille sur un dépôt Git | Lié à un compte ChatGPT, limites selon le forfait |
| Google Colab | Notebooks Jupyter hébergés, assistant Gemini intégré (génération, correction affichée en différences, agent de science des données) | Gratuit, ressources non garanties ; offres payantes pour des sessions plus longues |
| Gemini Code Assist | Extension pour VS Code et JetBrains | Depuis le 18 juin 2026, l’édition gratuite pour les particuliers ne répond plus : Google renvoie vers Antigravity ; restent les éditions Standard et Enterprise |
Ce dernier point mérite un aparté. Beaucoup d’articles conseillent encore « l’offre individuelle gratuite de Gemini Code Assist » : elle n’existe plus sous cette forme. Google indique que les extensions ont cessé de servir ces comptes et que les utilisateurs doivent migrer vers Antigravity, sa plateforme de développement par agents, annoncée sans frais pour les développeurs individuels. Les tarifs bougent vite. Vérifiez la page de l’éditeur avant de vous abonner.
Et si vous partez de zéro en programmation, commencez plutôt par notre article pour apprendre à coder avec l’IA quand on débute : ce qui suit suppose que vous savez lire une fonction, une boucle et un message d’erreur.
Rédiger un prompt qui donne du code Python utilisable
« Écris un programme de tri. » Le modèle doit alors deviner le type de données, la taille de la liste, l’ordre voulu, le comportement en cas de doublons. Il devinera. Pas forcément comme vous.
Un prompt qui produit du code Python exploitable contient cinq éléments : l’objectif, les entrées, la sortie attendue, les contraintes et la façon de vérifier le résultat. Concrètement, ça ressemble à ceci :
- Objectif : une fonction Python
totaux_par_client(commandes). - Entrées : une liste de dictionnaires avec les clés
client_id,montantetstatut. - Sortie : un dictionnaire qui associe chaque
client_idau total de ses commandes payées. - Contraintes : bibliothèque standard uniquement, Python 3.12, commandes annulées ignorées,
ValueErrorsi un montant est négatif, liste reçue jamais modifiée. - Vérification : des tests pytest pour une liste vide, un montant négatif et une commande annulée.
Ajoutez une dernière consigne : « explique tes hypothèses avant le code ». Elle compte plus qu’elle n’en a l’air. Quand l’assistant expose ses hypothèses (« je suppose que les montants sont en euros », « je considère qu’un client sans commande payée n’apparaît pas »), vous repérez les malentendus avant qu’ils se cachent dans le code.
Ajoutez le contexte qui manque au modèle pour écrire du code Python adapté : la version de Python, les bibliothèques installées et leur version (la sortie de pip freeze suffit), le style du projet. Un assistant qui ignore que vous êtes sur pandas 1.x vous proposera volontiers une syntaxe de la 2.x, ou l’inverse.
Si le premier jet ne convient pas, ne reformulez pas toute la demande. Pointez le défaut : « la fonction garde les commandes annulées », « elle trie la liste d’origine en place ». Demandez une correction limitée à ce point, puis comparez les deux versions. Les techniques générales de formulation, valables bien au-delà de la programmation, sont détaillées dans notre guide pour rédiger des prompts efficaces.
Dernier réflexe, souvent oublié : une fonction par demande. Générer du code Python par petits morceaux testables donne de meilleurs résultats que de réclamer « l’application complète » d’un coup. Un module de 400 lignes de code Python produit en une fois, personne ne le relit vraiment. Vous non plus.
Les tests pytest avant le code accepté
Un code Python qui s’exécute sans erreur n’est pas forcément correct. Il peut renvoyer un total faux, oublier un cas, ou marcher sur vos trois exemples et échouer sur le quatrième. Les tests sont le seul moyen sérieux de le savoir, et c’est là que l’IA pour coder en Python devient vraiment rentable : écrire des tests est fastidieux, le modèle le fait sans se plaindre.
pytest découvre les tests tout seul. Il parcourt le dossier courant et ses sous-dossiers, ramasse les fichiers nommés test_*.py ou *_test.py, puis exécute les fonctions dont le nom commence par test. Pour le code Python de l’exemple des commandes :
# test_commandes.py
import pytest
from commandes import totaux_par_client

def test_liste_vide():
    assert totaux_par_client([]) == {}

def test_commande_annulee_ignoree():
    cmds = [{"client_id": "A", "montant": 50.0, "statut": "annulee"}]
    assert totaux_par_client(cmds) == {}

def test_montant_negatif():
    with pytest.raises(ValueError):
        totaux_par_client([{"client_id": "A", "montant": -1.0, "statut": "payee"}])
Lancez ensuite pytest, ou pytest -q pour une sortie plus courte. Les tests unitaires, au sens où les définit la page Wikipédia consacrée au test unitaire, vérifient une petite unité de code isolée : exactement ce qu’une fonction générée réclame.
Le piège des tests complaisants
Si vous demandez à l’IA d’écrire les tests à partir du code Python qu’elle vient de produire, elle risque de figer ses propres erreurs : le test vérifie ce que fait la fonction, pas ce qu’elle devrait faire. Écrivez au moins un test vous-même, à partir du besoin (« un client avec deux commandes payées de 20 et 30 euros doit totaliser 50 »).
L’ordre idéal, franchement : les tests d’abord, le code ensuite. Demandez les tests, relisez-les, corrigez ceux qui ne correspondent pas au besoin, puis demandez à l’assistant de générer du code Python qui doit les passer. C’est du développement piloté par les tests, sans la corvée de l’écriture.
Gardez une limite en tête. Des tests au vert prouvent seulement que les scénarios couverts fonctionnent. Ils ne disent rien des cas auxquels personne n’a pensé : un fichier vide, un encodage exotique, une liste de dix millions de lignes.
Relire et sécuriser le code généré
Les tests passent ? Reste la relecture du code Python généré. Elle se fait sur le diff, pas sur le fichier entier : quelles lignes ont changé, pourquoi, et qu’est-ce qui a disparu au passage. Un assistant qui « nettoie » une fonction supprime parfois une vérification qu’il jugeait inutile.
Deux outils font le gros du travail mécanique. Ruff, un linter et formateur Python très rapide écrit en Rust, repère les imports inutilisés, les variables jamais lues, les écarts de style. Bandit cherche les problèmes de sécurité courants dans le code Python : appels à eval, mots de passe écrits en dur, sous-processus lancés avec shell=True.
python -m venv .venv
source .venv/bin/activate
pip install ruff bandit pytest
ruff check .
bandit -r .
pytest -q
La première ligne n’est pas décorative. Un environnement virtuel créé avec venv isole les paquets du projet : si le code Python généré installe une dépendance douteuse ou en casse une autre, le reste de votre machine n’en saura rien.
Puis lisez vous-même les zones sensibles, celles qu’aucun outil ne juge à votre place :
- les accès aux fichiers (chemins construits à partir d’une saisie, suppression, écrasement) ;
- les requêtes SQL fabriquées par concaténation de texte, porte ouverte à l’injection : exigez des requêtes paramétrées ;
- les appels réseau et les URL contactées ;
- les commandes système lancées depuis Python ;
- tout ce qui touche à une clé, un jeton ou un mot de passe.
Pour l’authentification, le paiement ou la suppression de données, une deuxième paire d’yeux humains reste la règle. Ce n’est pas de la méfiance envers l’IA. C’est ce qu’on ferait avec le code d’un collègue pressé.
Et la confidentialité ? Avant de coller du code Python dans un assistant, vérifiez ce qu’il en fait. GitHub propose aux comptes Copilot Free, Pro, Pro+ et Max un réglage « Allow GitHub to use my data for AI model training » : passez-le sur « Disabled » si vous ne voulez pas que vos échanges servent à l’entraînement. Le code d’un client, une base réelle ou un fichier de configuration n’ont rien à faire dans un prompt. Nos articles sur la façon de sécuriser ses données dans les outils IA et sur les données sensibles détaillent les réglages des principaux services.
Déboguer avec l’IA sans perdre la main
Coller « ça marche pas » avec cent lignes de code Python, c’est la méthode la plus répandue. Et la moins efficace. Le modèle a besoin de trois choses : le traceback complet, la commande lancée et un code minimal qui reproduit l’erreur.
Lisez d’abord le traceback vous-même, en partant du bas. La documentation officielle de Python le rappelle : la dernière ligne indique ce qui s’est passé, avec le type de l’exception (ZeroDivisionError, KeyError, TypeError) et son message. Les lignes au-dessus retracent la pile d’appels, fichier et numéro de ligne compris.
Réduisez ensuite le problème. Gardez l’import, la fonction appelée, les valeurs qui déclenchent l’erreur, rien d’autre. Si l’erreur disparaît en route, vous tenez déjà un indice sérieux : elle venait d’un état global, d’un fichier externe ou d’une étape oubliée. Souvent, ce travail de réduction règle le bug avant même d’avoir posé la question.
Quand vous la posez, demandez une explication avant le correctif : « Explique pourquoi cette KeyError se produit dans ce code Python, puis propose la plus petite modification qui la corrige. » Vous apprenez quelque chose, et vous évitez le correctif réflexe qui masque le symptôme (un try/except qui avale toutes les exceptions, au hasard).
Nettoyez le traceback avant de l’envoyer
Un message d’erreur peut contenir un chemin avec votre nom d’utilisateur, une URL de base de données, voire une clé dans une chaîne de connexion. Remplacez-les par des valeurs factices avant de copier.
Une fois le correctif reçu, retour à la boucle : on relance les tests, on relit le diff, on vérifie que rien d’autre n’a bougé. Si l’assistant a modifié trois fichiers pour une erreur dans un seul, c’est un signal. Refusez et redemandez plus petit.
Générer du code Python dans Google Colab
Pour tester une IA pour coder en Python sans rien installer, Google Colab reste le point de départ le plus simple. D’après sa FAQ officielle, c’est un service de notebooks Jupyter hébergé, sans installation, avec un accès gratuit à des ressources de calcul, GPU et TPU compris. Les notebooks se rangent dans Google Drive ou s’ouvrent depuis GitHub.
Depuis la refonte annoncée le 20 mai 2025 sur le blog des développeurs Google, l’assistant Gemini de Colab peut transformer du code existant à partir d’une description et afficher les changements en vue de différences. Il propose aussi des corrections quand une cellule échoue et lance un agent de science des données capable d’explorer un jeu de données. Pour générer du code Python directement dans le navigateur, c’est pratique. Mais la règle ne change pas : vous relisez chaque différence avant de l’accepter.
Le notebook a ses propres pièges. Le code tourne sur une machine virtuelle qui est supprimée après un moment d’inactivité, et dont la durée de vie est limitée : les fichiers et bibliothèques ajoutés disparaissent avec elle. Mettez donc les installations (!pip install …) dans une cellule en tête du notebook et sauvegardez vos fichiers de sortie dans Drive.
Les clés API, maintenant. Ne les écrivez jamais dans une cellule. Colab dispose d’un gestionnaire de secrets, accessible depuis le panneau latéral, et le code les lit ainsi :
from google.colab import userdata
cle_api = userdata.get("MA_CLE_API")
N’affichez pas la variable, ne la copiez pas dans un message à l’assistant. Avant de partager le notebook, effacez toutes les sorties : une cellule exécutée garde ce qu’elle a imprimé, une adresse e-mail ou un extrait de table compris, même si vous avez supprimé la ligne de code depuis. Et si une clé a fuité quelque part (dépôt, historique Git, capture d’écran), révoquez-la. La supprimer ne suffit pas.
Les notebooks se prêtent bien à l’analyse : si c’est votre usage principal, notre article sur l’IA pour analyser des données compare les outils spécialisés. Pour un usage plus large du développement assisté, du refactoring à la documentation, voyez les usages de l’IA pour les développeurs.
Bref, l’IA pour coder en Python ne remplace ni la lecture du code ni les tests. Elle déplace votre travail : moins de frappe, plus de vérification. Et c’est un bon échange, à condition de le faire vraiment.
Foire aux questions
Faut-il savoir programmer avant d’utiliser une IA pour coder en Python ?
Les bases suffisent pour démarrer : variables, conditions, boucles, fonctions, listes et dictionnaires. Mais avant d’utiliser un code Python généré dans un vrai projet, vous devez pouvoir le lire, l’exécuter sur un exemple et repérer une erreur évidente. Sans ce minimum, vous ne saurez pas distinguer une réponse juste d’une réponse plausible.
L’IA peut-elle vérifier seule que son code est correct ?
Pas entièrement. Un agent comme Codex peut écrire des tests et les exécuter dans son environnement. Mais c’est vous qui définissez le résultat attendu, et un test écrit par le modèle à partir de son propre code peut confirmer une erreur. Gardez au moins un test rédigé à partir du besoin réel.
Quelle différence entre pytest et unittest ?
unittest fait partie de la bibliothèque standard et organise les tests en classes et méthodes. pytest s’installe à part, accepte de simples fonctions avec assert, découvre les tests automatiquement et ajoute des outils comme les fixtures ou monkeypatch. Pour faire générer du code Python testé par une IA, pytest donne des tests plus courts à relire.
Peut-on mettre une clé API dans un notebook Colab ?
Oui, à condition de passer par les secrets de Colab (lus avec userdata.get) ou par une variable d’environnement, jamais en clair dans une cellule. Avant de partager le notebook, effacez les sorties. Et si la clé a été exposée, révoquez-la auprès du service concerné.
Sources
- GitHub : offres et tarifs de Copilot
- GitHub Docs : gérer les réglages de Copilot (utilisation des données)
- Google Cloud : présentation de Gemini Code Assist et fin du service pour les particuliers
- OpenAI : documentation de Codex
- pytest : bonnes pratiques et découverte des tests
- Python : erreurs et exceptions (tutoriel officiel)
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.