La correction automatique du français bute sur des difficultés qui n’existent pas, ou beaucoup moins, en anglais. Accords du participe passé, homophones grammaticaux, subjonctif, typographie : autant de terrains où un outil performant sur d’autres langues se révèle approximatif dès qu’il aborde le nôtre.
Cet article ne compare pas les logiciels — nous l’avons fait ailleurs, dans notre guide des correcteurs orthographiques IA. Il s’intéresse à la matière elle-même : pourquoi le français résiste, quelles erreurs sont réellement attrapées, lesquelles passent toujours, et comment régler un outil pour qu’il travaille avec vous plutôt que contre votre style.
Correction automatique du français : ce qui la rend plus difficile
Quatre caractéristiques de la langue expliquent l’essentiel des échecs. Elles n’ont rien d’anecdotique : elles touchent des constructions que l’on écrit tous les jours.
Les accords qui dépendent du sens
L’accord du participe passé avec le complément d’objet direct antéposé exige de savoir ce que désigne le pronom. « Les lettres que j’ai écrites » s’accorde, « les lettres que j’ai écrit à mon frère » non. Résoudre cela demande une analyse syntaxique complète, pas une simple correspondance de formes.
Même difficulté avec les accords de proximité, les collectifs — « la majorité des lecteurs pense » ou « pensent », les deux se défendent — et les participes suivis d’un infinitif. Ce sont les erreurs les plus fréquemment signalées à tort par les outils, qui proposent des corrections grammaticalement possibles mais contraires au sens voulu.
Les homophones grammaticaux
« a » ou « à », « ou » ou « où », « se » ou « ce », « leur » ou « leurs », « quelque » ou « quel que » : ces couples se distinguent uniquement par la fonction dans la phrase. Un outil qui raisonne sur la fréquence des enchaînements se trompe dès que la construction sort de l’ordinaire, notamment dans les phrases longues ou avec incise.
Le subjonctif
Son emploi dépend de la nuance de la subordonnée, parfois du registre, souvent de l’intention. « Je cherche un collaborateur qui sait » et « qui sache » sont tous deux corrects et ne disent pas la même chose. Aucune correction automatique du français ne peut trancher sans savoir ce que vous vouliez dire.
La typographie
C’est le terrain le plus mécanique et pourtant le plus mal traité. Espace insécable avant les deux-points, le point-virgule, le point d’interrogation et d’exclamation ; guillemets chevrons avec espaces intérieures ; majuscules accentuées ; espace fine devant le pourcentage. Ces règles sont parfaitement codifiables, mais beaucoup d’outils, conçus pour l’anglais, les ignorent ou les défont.
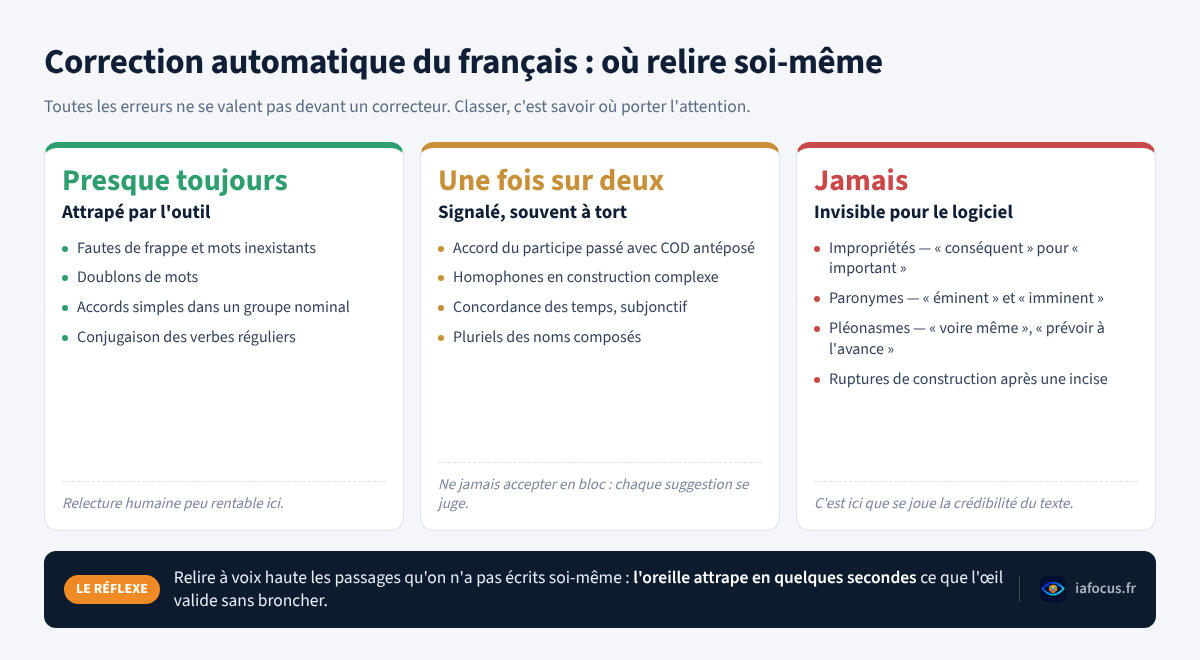
Correction automatique du français : ce qui est attrapé, ce qui passe
Toutes les erreurs ne se valent pas devant un correcteur. Les classer par nature permet de savoir où relire soi-même, plutôt que de tout relire uniformément.
Quasiment toujours attrapé : les fautes de frappe, les mots inexistants, les doublons de mots, les accords en genre et en nombre dans un groupe nominal simple, la conjugaison des verbes réguliers. Sur ce socle, la correction automatique du français est fiable et fait gagner un temps réel.
Attrapé une fois sur deux : les accords du participe passé, les homophones grammaticaux en construction complexe, les concordances de temps, les pluriels des noms composés. Ce sont les cas où un outil signale beaucoup, souvent à tort, et où l’acceptation aveugle des suggestions dégrade le texte.
Presque jamais attrapé : la répétition d’une même idée à deux endroits, l’impropriété de terme — un mot qui existe mais ne veut pas dire ce que vous croyez —, la rupture de registre, l’anacoluthe, et les faux amis contextuels. Rien de tout cela n’est une faute au sens du logiciel.
Cette troisième catégorie mérite l’attention, parce qu’elle contient les défauts que le lecteur remarque vraiment. Un texte sans faute d’orthographe mais mal construit paraît plus négligé qu’un texte solide avec deux coquilles.
Français de France, du Québec, de Belgique : une même langue, plusieurs normes
La correction automatique du français suppose une norme, et cette norme n’est pas unique. Un outil configuré pour une variante en signalera une autre comme fautive.
Les divergences les plus visibles sont lexicales : « courriel » et « clavardage » sont la norme au Québec et restent marqués en France ; « septante » et « nonante » sont usuels en Belgique et en Suisse ; « déjeuner » ne désigne pas le même repas des deux côtés de l’Atlantique.
Plus subtil, le traitement des anglicismes diffère nettement. La norme québécoise les proscrit plus fermement, y compris ceux que l’usage hexagonal a intégrés sans discussion. Un correcteur d’origine québécoise signalera des emprunts qu’un rédacteur français ne perçoit plus comme tels.
S’ajoute la question des rectifications orthographiques de 1990, jamais pleinement adoptées et jamais abandonnées. « Nénufar », « ognon », l’accent circonflexe sur le « i » et le « u » : les deux graphies restent admises, et les outils tranchent différemment. Fixer ce réglage une fois pour toutes évite des allers-retours sans fin.
Les fautes que la correction automatique du français ne signale jamais
Ces erreurs ont un point commun : elles produisent des phrases parfaitement correctes du point de vue du logiciel. Seul un lecteur les repère, et c’est pourquoi elles survivent jusqu’à la publication.
Les impropriétés
Un mot qui existe, employé pour un autre. « Conséquent » pour « important », « achalandé » pour « approvisionné », « pallier à » au lieu de « pallier », « au temps pour moi » écrit « autant ». Aucun de ces cas n’est une faute d’orthographe, et aucun correcteur ne les relève de façon fiable.
Les paronymes
Des mots proches par la forme et distincts par le sens : « éminent » et « imminent », « collision » et « collusion », « prodige » et « prodigue », « affluence » et « influence », « perpétrer » et « perpétuer ». La substitution passe inaperçue parce que les deux formes sont valides.
Les pléonasmes installés
« Monopole exclusif », « prévoir à l’avance », « au jour d’aujourd’hui », « voire même », « moi personnellement ». Certains outils les signalent en mode style, la plupart les laissent passer, et l’usage courant les a rendus presque invisibles à la relecture.
La rupture de construction
La phrase commence sur une structure et se termine sur une autre, généralement après une longue incise. « En analysant les résultats, il apparaît que… » : le participe ne se rattache à aucun sujet. C’est l’erreur la plus fréquente dans les textes longs, et la moins détectée.
Correction automatique du français et textes générés : les tics à chasser
Un texte produit par un assistant présente un profil d’erreurs très particulier. Son orthographe est presque toujours irréprochable, ce qui donne une fausse impression de qualité, tandis que trois défauts reviennent avec une régularité déconcertante.
La typographie anglo-saxonne. Guillemets droits ou doubles chevrons anglais, absence d’espace insécable, tirets courts à la place des cadratins, espaces avant les points de suspension. C’est le marqueur le plus fiable d’un texte non repassé, et le plus simple à corriger en lot.
Le vocabulaire calqué. « Adresser un problème » pour « traiter », « supporter » pour « prendre en charge », « opportunité » pour « occasion », « délivrer » pour « fournir ». Ces emplois sont grammaticalement corrects et sémantiquement anglais.
L’uniformité rythmique. Des paragraphes de longueur presque identique, des phrases de calibre régulier, une transition explicite entre chaque idée. Rien n’est fautif, et pourtant la lecture devient monotone. Une correction automatique du français ne verra jamais ce défaut, qui relève du rythme et non de la règle.
La parade tient en une habitude : relire à voix haute les passages qu’on n’a pas écrits soi-même. L’oreille repère en quelques secondes ce que l’œil valide sans broncher, et c’est le seul contrôle qui attrape ces trois familles d’un coup. Cette relecture s’inscrit naturellement dans la chaîne décrite dans notre guide pour choisir un assistant IA professionnel, où le temps épargné à la rédaction se réinvestit dans la vérification.
Correction automatique du français : régler l’outil plutôt que le subir
La plupart des frustrations viennent d’un paramétrage laissé par défaut. Cinq réglages changent radicalement l’expérience.
- Fixez la variante — France, Québec, Belgique, Suisse — et l’option sur les rectifications de 1990. C’est le réglage qui supprime le plus de faux signalements.
- Constituez un dictionnaire personnel avec vos noms propres, votre jargon métier et vos marques. Dix minutes au départ, et la moitié des alertes disparaît.
- Désactivez la correction de style si vous avez une voix éditoriale assumée. Ces suggestions lissent, et le lissage est précisément ce qui rend un texte anonyme.
- Activez les contrôles typographiques quand l’outil les propose. C’est le gain le plus net pour l’effort le plus faible.
- Relisez les suggestions une par une. Le mode « tout corriger » est la principale cause de textes dégradés par un correcteur.
Ce dernier point est le plus important. Un correcteur propose, il ne décide pas. Chaque acceptation automatique d’une suggestion sur un accord ambigu remplace votre sens par une probabilité statistique.
Où placer la correction automatique du français dans une chaîne de production
L’ordre des opérations compte plus qu’on ne le croit. Corriger trop tôt fait perdre du temps sur des passages qui seront réécrits ; corriger trop tard laisse les fautes s’installer dans une structure figée.
La séquence efficace place la correction en avant-dernière position : rédaction, vérification des faits, relecture structurelle, puis correction linguistique, et enfin contrôle typographique. Inverser les deux dernières étapes oblige souvent à repasser sur la typographie que la correction a défaite.
Sur un texte produit avec un assistant, une précaution supplémentaire s’impose : les modèles génèrent une orthographe globalement correcte mais une typographie française très approximative. Notre guide pour choisir un assistant d’écriture détaille les critères à tester sur ce point précis, et celui sur la rédaction SEO assistée par IA replace cette étape dans la chaîne complète.
Correction automatique du français : les questions fréquentes
Un correcteur peut-il abîmer un texte ?
Oui, et c’est fréquent en mode automatique. Les dégâts typiques : un accord de participe passé « corrigé » à contresens, un subjonctif remplacé par un indicatif qui change la nuance, un terme précis remplacé par un synonyme plus courant mais moins juste.
Faut-il un correcteur si l’on écrit déjà bien ?
Pour les fautes de frappe et la typographie, oui : ce sont des erreurs d’inattention que la relecture personnelle rate justement parce qu’on lit ce qu’on a voulu écrire. Pour la grammaire, le bénéfice décroît vite avec le niveau.
Les assistants génératifs corrigent-ils aussi bien qu’un correcteur dédié ?
Ils comprennent mieux le contexte et repèrent des maladresses qu’un correcteur ignore. En revanche, ils appliquent la règle de façon moins systématique et réécrivent parfois au lieu de corriger. Les deux approches sont complémentaires, dans cet ordre : correcteur d’abord, assistant ensuite pour l’avis de fond.
Comment vérifier la typographie sans outil dédié ?
Une recherche sur les caractères suffit : cherchez les espaces ordinaires devant les deux-points et les points d’interrogation, et les guillemets droits. Ces deux contrôles attrapent l’essentiel des défauts typographiques d’un texte français.
La correction automatique du français a beaucoup progressé sur ce qui se codifie, et pas du tout sur ce qui demande de comprendre. Connaître cette frontière change la façon de travailler : on cesse de relire uniformément, et on concentre son attention là où aucun outil ne viendra jamais.
iafocus.fr est un site dédié à l’intelligence artificielle, aux outils IA et aux usages concrets pour gagner du temps, créer plus vite et rester à jour.